보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
태그
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
AI가 이상을 찾아낸 뒤에도 현장에는 확인하고 결정할 일이 남습니다. OpenBot 1.0을 사례로, 에이전트의 분석이 사람의 판단과 후속 업무로 이어지려면 무엇이 필요한지 살펴봅니다.
AI 에이전트는 이제 답만 하지 않고 코드를 돌리고, 브라우저를 몰고, 사내 시스템에 접근합니다. 그 일은 어디서, 무엇을 쥐고 해야 할까요? 에이전트가 일하는 구조부터 짚고, 구글이 공개한 Agent Compute Engine의 설계를 살펴봅니다.
AI 에이전트에게 데이터베이스 스키마만 주면 SQL은 실행돼도 숫자가 틀릴 수 있습니다. 온톨로지가 무엇인지부터 짚고, 엔비디아가 공개한 Auto Ontology가 이 문제를 어떻게 푸는지 살펴봅니다.
앤트로픽이 증권신고서에 AI가 AI 개발을 크게 앞당기는 기준선에 곧 닿을 수 있다고 적었습니다. 코드와 실험은 이미 AI가 대부분 맡지만, 무엇을 연구할지 고르는 판단은 아직 사람의 몫입니다.
REA는 Ghidra 같은 기존 분석 도구를 코딩 에이전트에 이어 주는 층입니다. 시도의 문턱은 크게 낮아졌지만, 읽은 내용을 이해하고 검증하는 일은 아직 사람의 몫입니다.
다섯 회사의 에이전트는 모두 자기 컴퓨터로 24시간 일합니다. 기능은 빠르게 닮아 가고, 차이는 어디까지 맡길 수 있게 설계했느냐에서 갈립니다.
Anthropic의 하루 병합 수는 넉 달 만에 2,500건에서 3만 건으로 늘었습니다. 사람 속도에 맞춰 만든 Git과 CI가 먼저 버거워졌고, Anthropic은 Scion이라는 소스 관리 시스템을 새로 만들었습니다.
같은 질문도 긴 대화 속에 넣으면 정답률이 0.92에서 0.38로 떨어집니다. 모델이 한 번에 보는 정보를 고르고 줄이고 나누는 컨텍스트 엔지니어링을 연구 결과와 포인랩의 적용 사례로 살펴봅니다.
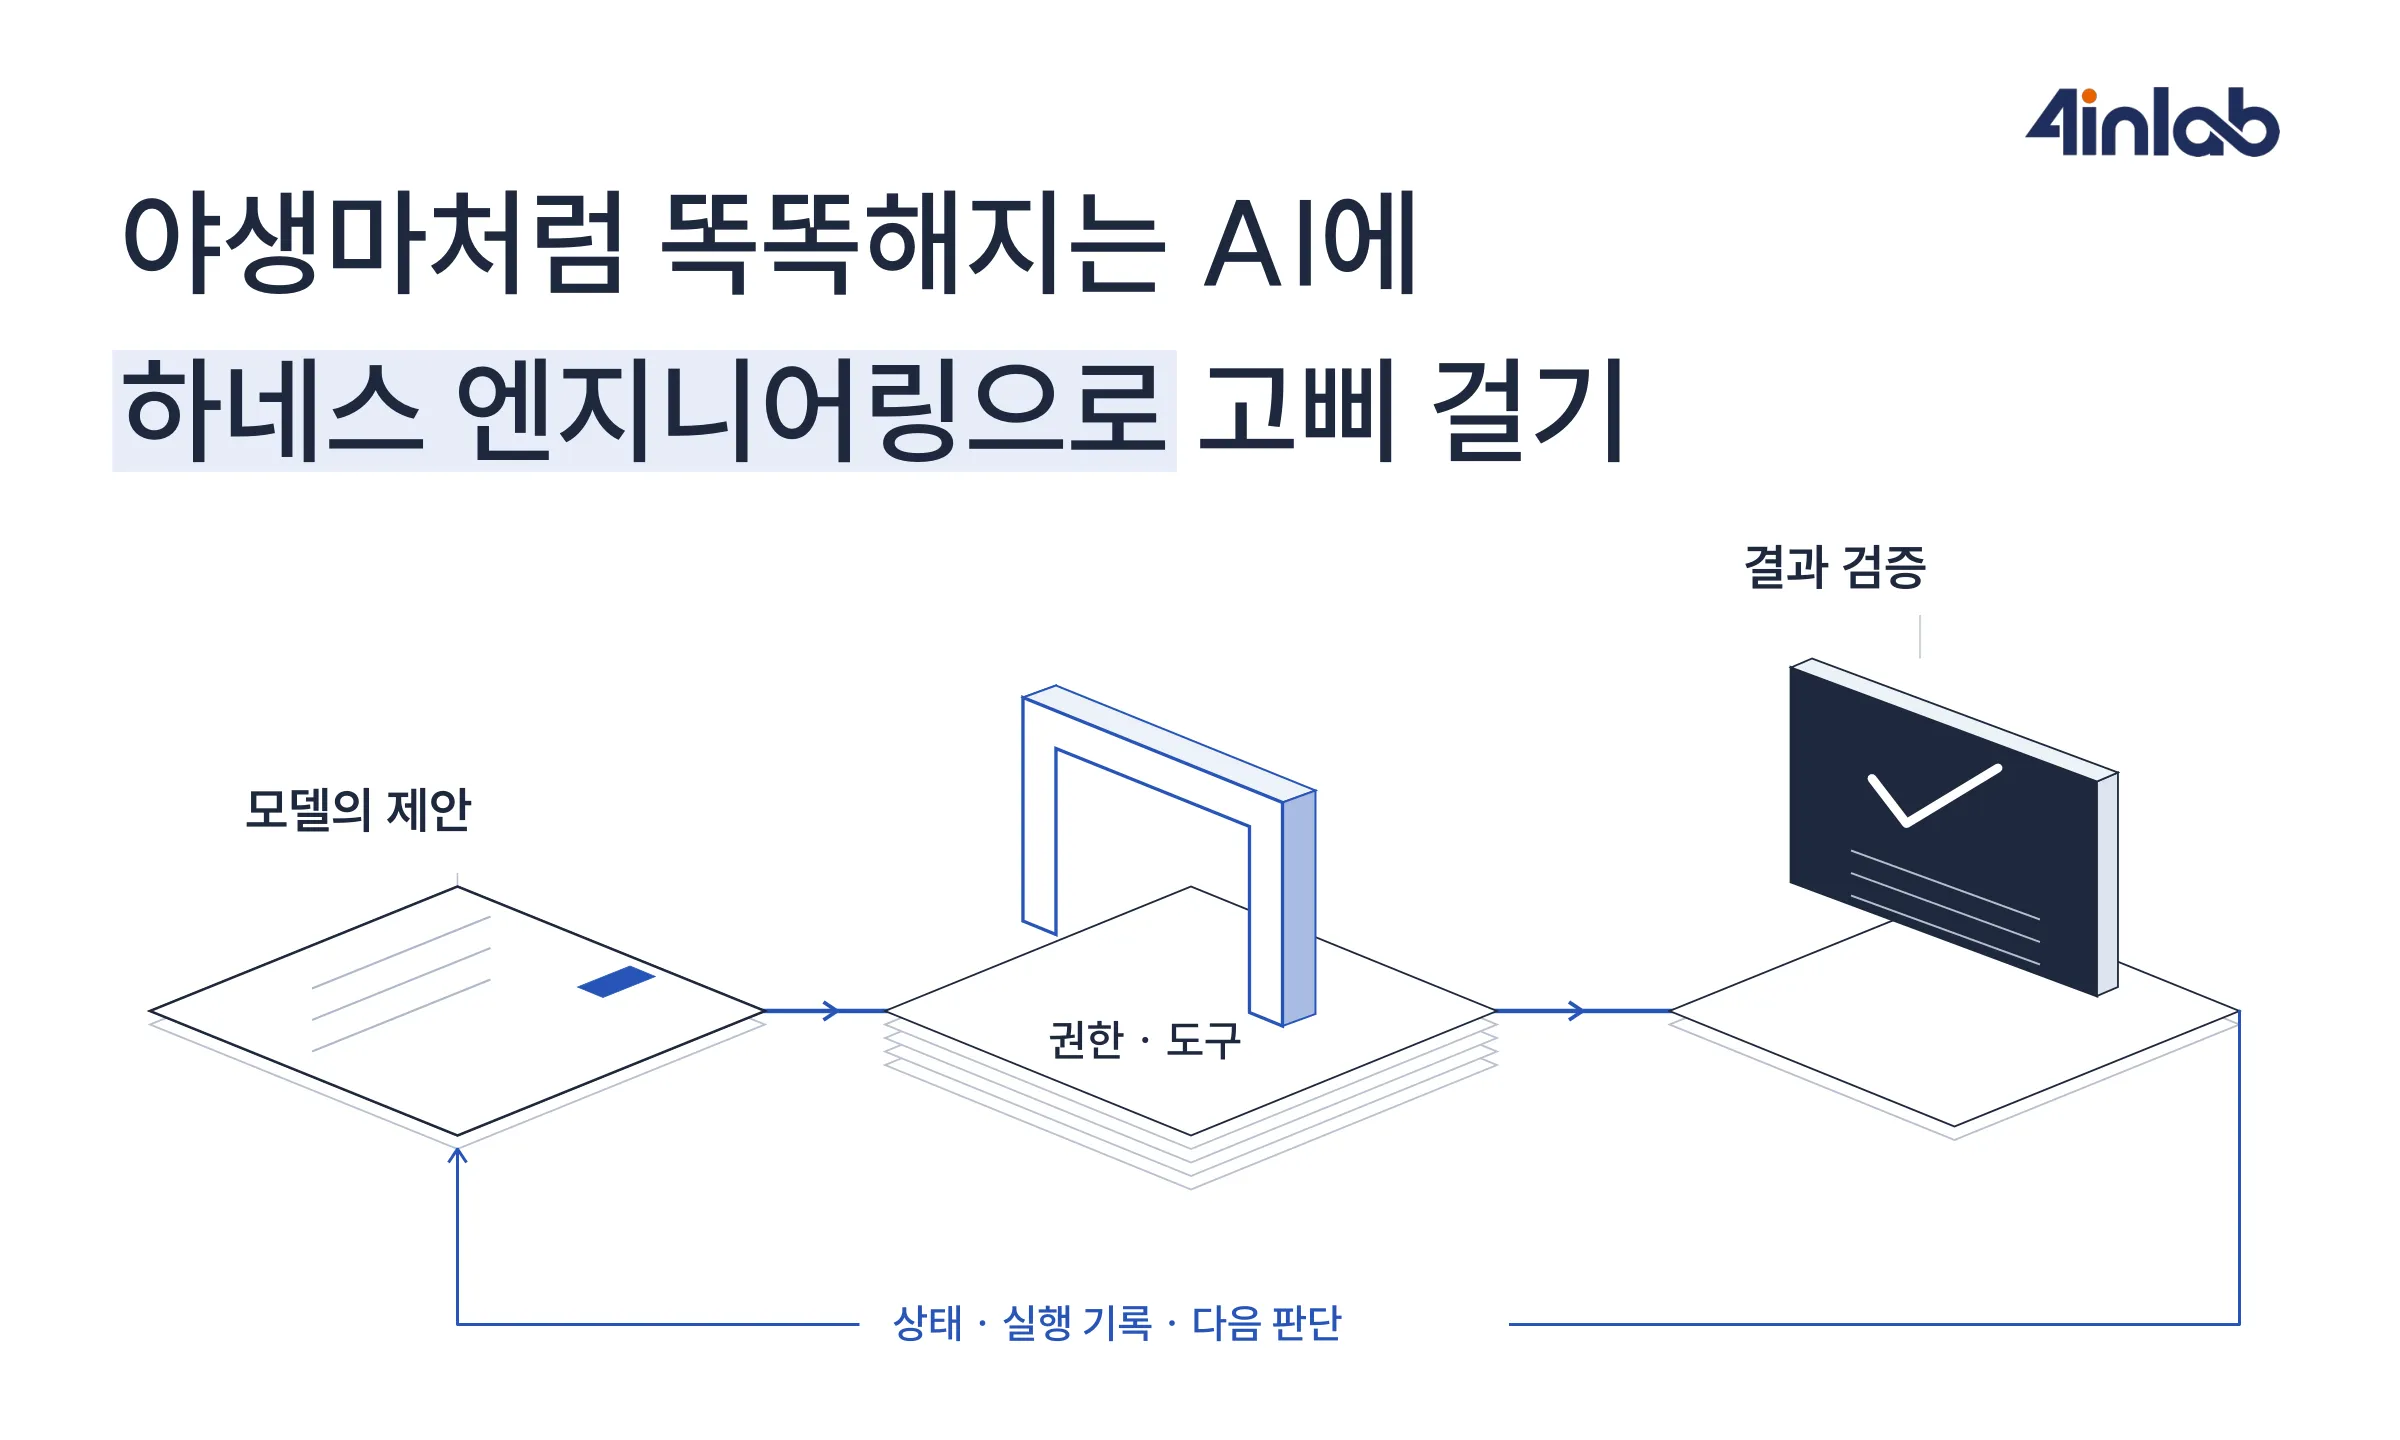
AI가 여러 단계의 일을 맡으며 드러난 문맥과 진행 상태, 도구 실패와 완료 검증의 문제를 통해 하네스 엔지니어링이 필요한 이유를 살펴봅니다.
Jev는 정해진 질문에 선택·점수·확률을 반환합니다. 검색 결과와 문서를 고르고 에이전트의 다음 행동을 정할 때, 코드가 검증하고 실행할 판단을 어떻게 분리할 수 있을지 살펴봅니다.
같은 모델의 성능이 41.8%에서 56.4%로 높아졌어요. Agent Lightning v1.0의 원문 그림과 함께 하네스, 학습 기록, 평가 기준을 읽어 봅니다.