소스 코드가 없어도 AI가 다 뜯어본다고요?
Reverse Engineer Anything으로 본 AI 역엔지니어링
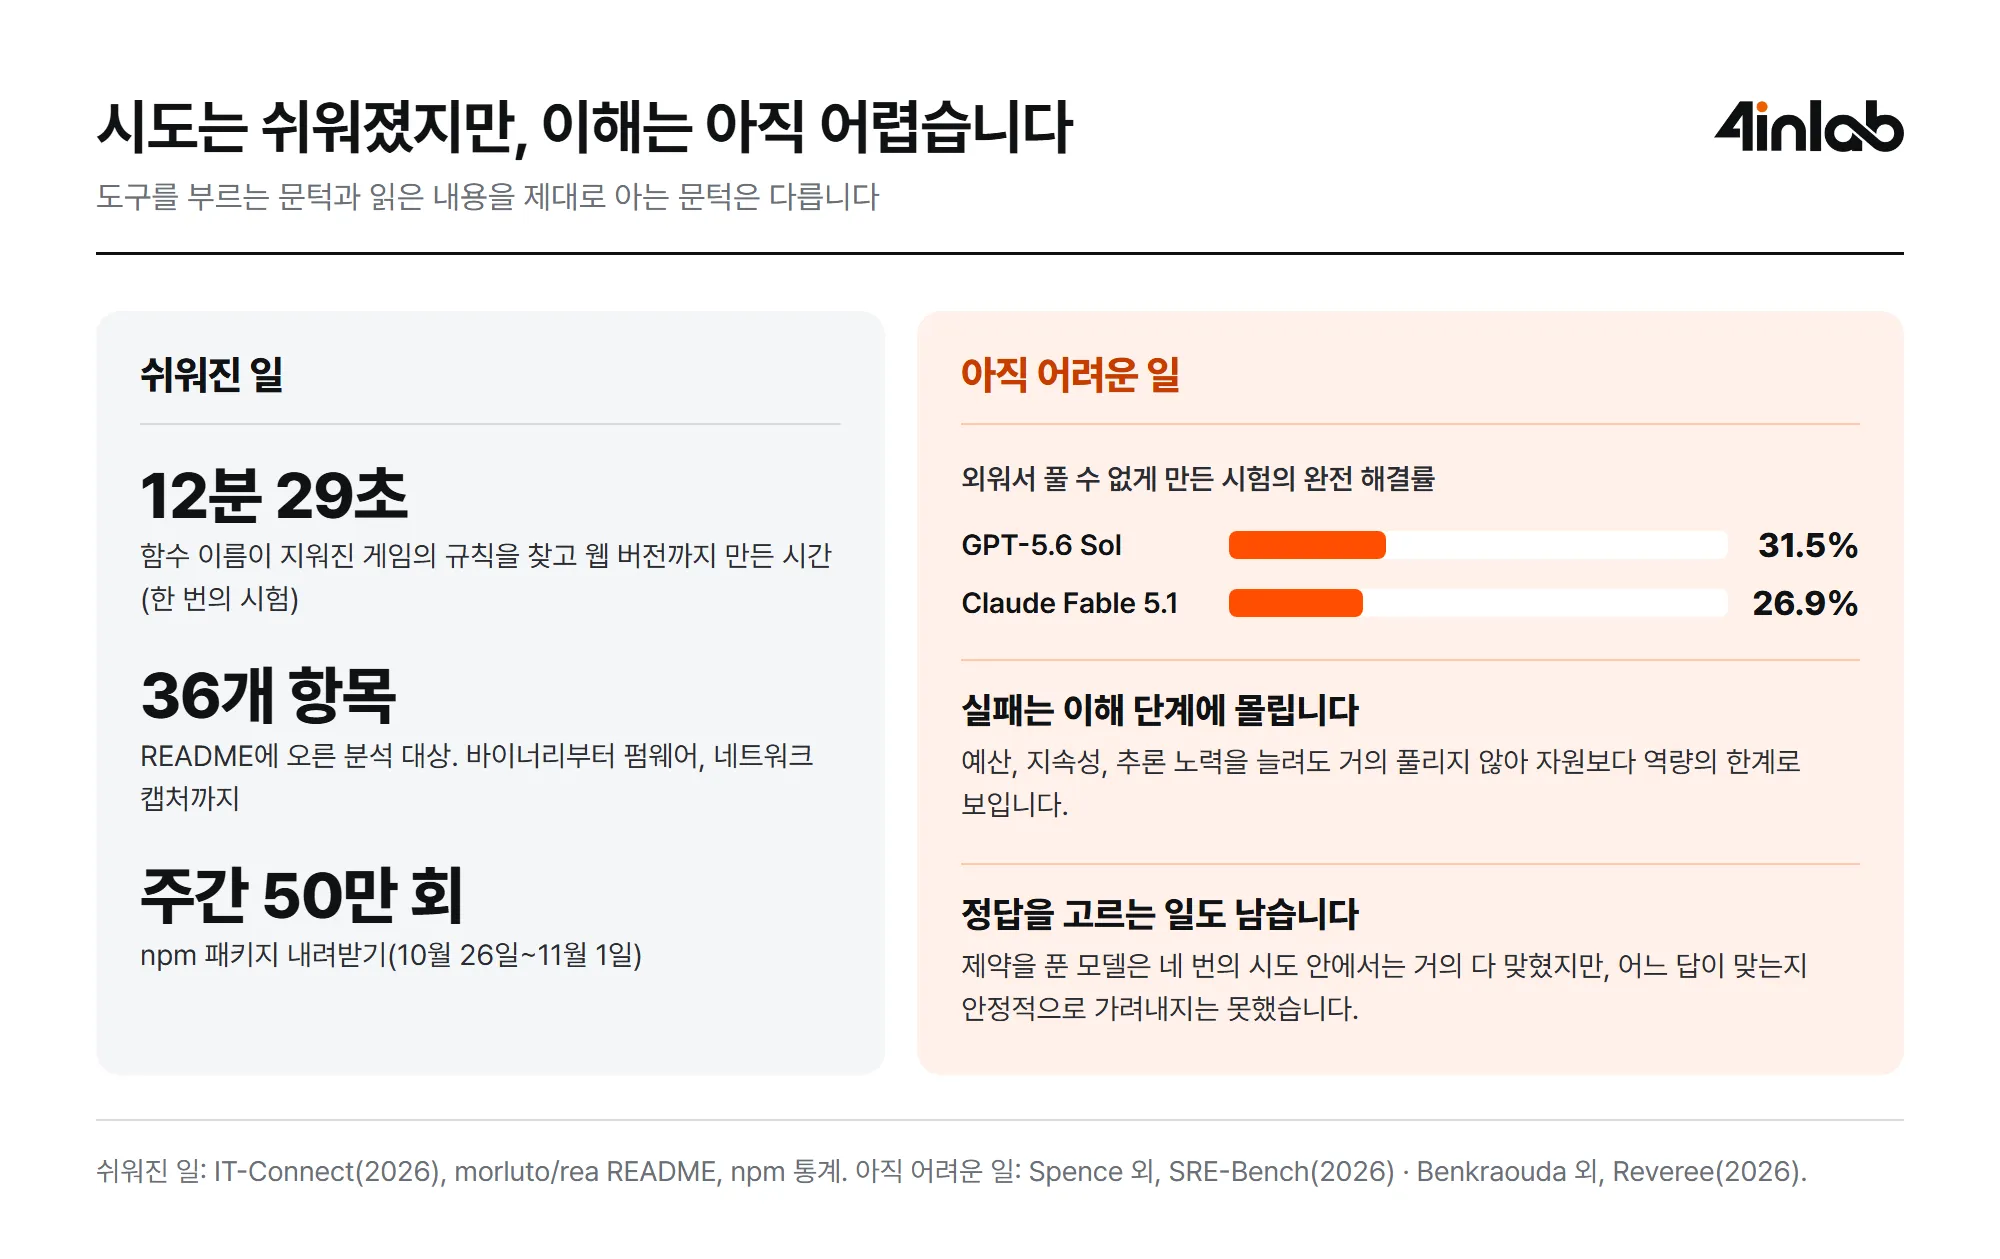
프랑스 IT 매체 IT-Connect의 필자 (새 탭에서 열림)가 리눅스 게임 실행 파일 하나를 AI 에이전트에게 건넸습니다. 소스 코드는 주지 않았고, 파일 안의 함수 이름도 지워져 있었습니다. 12분 29초 뒤 에이전트는 화면이 0.08초마다 한 칸씩 움직이고 점프가 1.08초 동안 이어진다는 규칙을 찾아냈고, 그 규칙으로 웹 버전까지 만들었습니다.
이때 쓴 도구가 REA(Reverse Engineer Anything)입니다. 올해 4월에 만들어진 오픈소스 프로젝트인데, 10월 초부터 빠르게 퍼져 11월 3일 기준 GitHub 스타가 약 42만 개에 이릅니다. 코딩 에이전트로 스마트 TV의 광고를 걷어 내거나 (새 탭에서 열림) 방치된 IoT 기기를 되살렸다는 이야기 (새 탭에서 열림)도 함께 번졌습니다.
이름 그대로라면 이제 소스 코드가 없는 프로그램도 AI가 다 뜯어볼 수 있다는 뜻입니다. 정말 그럴까요?
REA는 무엇일까요?
역엔지니어링은 완성된 프로그램을 거꾸로 읽어 어떻게 동작하는지 알아내는 일입니다. 컴파일을 거친 프로그램에는 사람이 읽을 소스 코드가 남아 있지 않습니다. Ghidra나 IDA 같은 도구가 기계어를 읽기 쉬운 형태로 바꿔 주지만, 어디를 볼지 정하고 의미를 짜 맞추는 일은 숙련된 분석가의 몫이었습니다.
REA는 그 자리에 코딩 에이전트를 데려옵니다. 다만 이름에서 받는 인상과 달리 REA 자체는 디컴파일러도, 에이전트도 아닙니다 (새 탭에서 열림). Claude Code나 Codex 같은 에이전트가 MCP(AI 앱이 외부 도구와 통신하는 표준)로 기존 분석 도구를 부를 수 있게 이어 주는 층입니다.
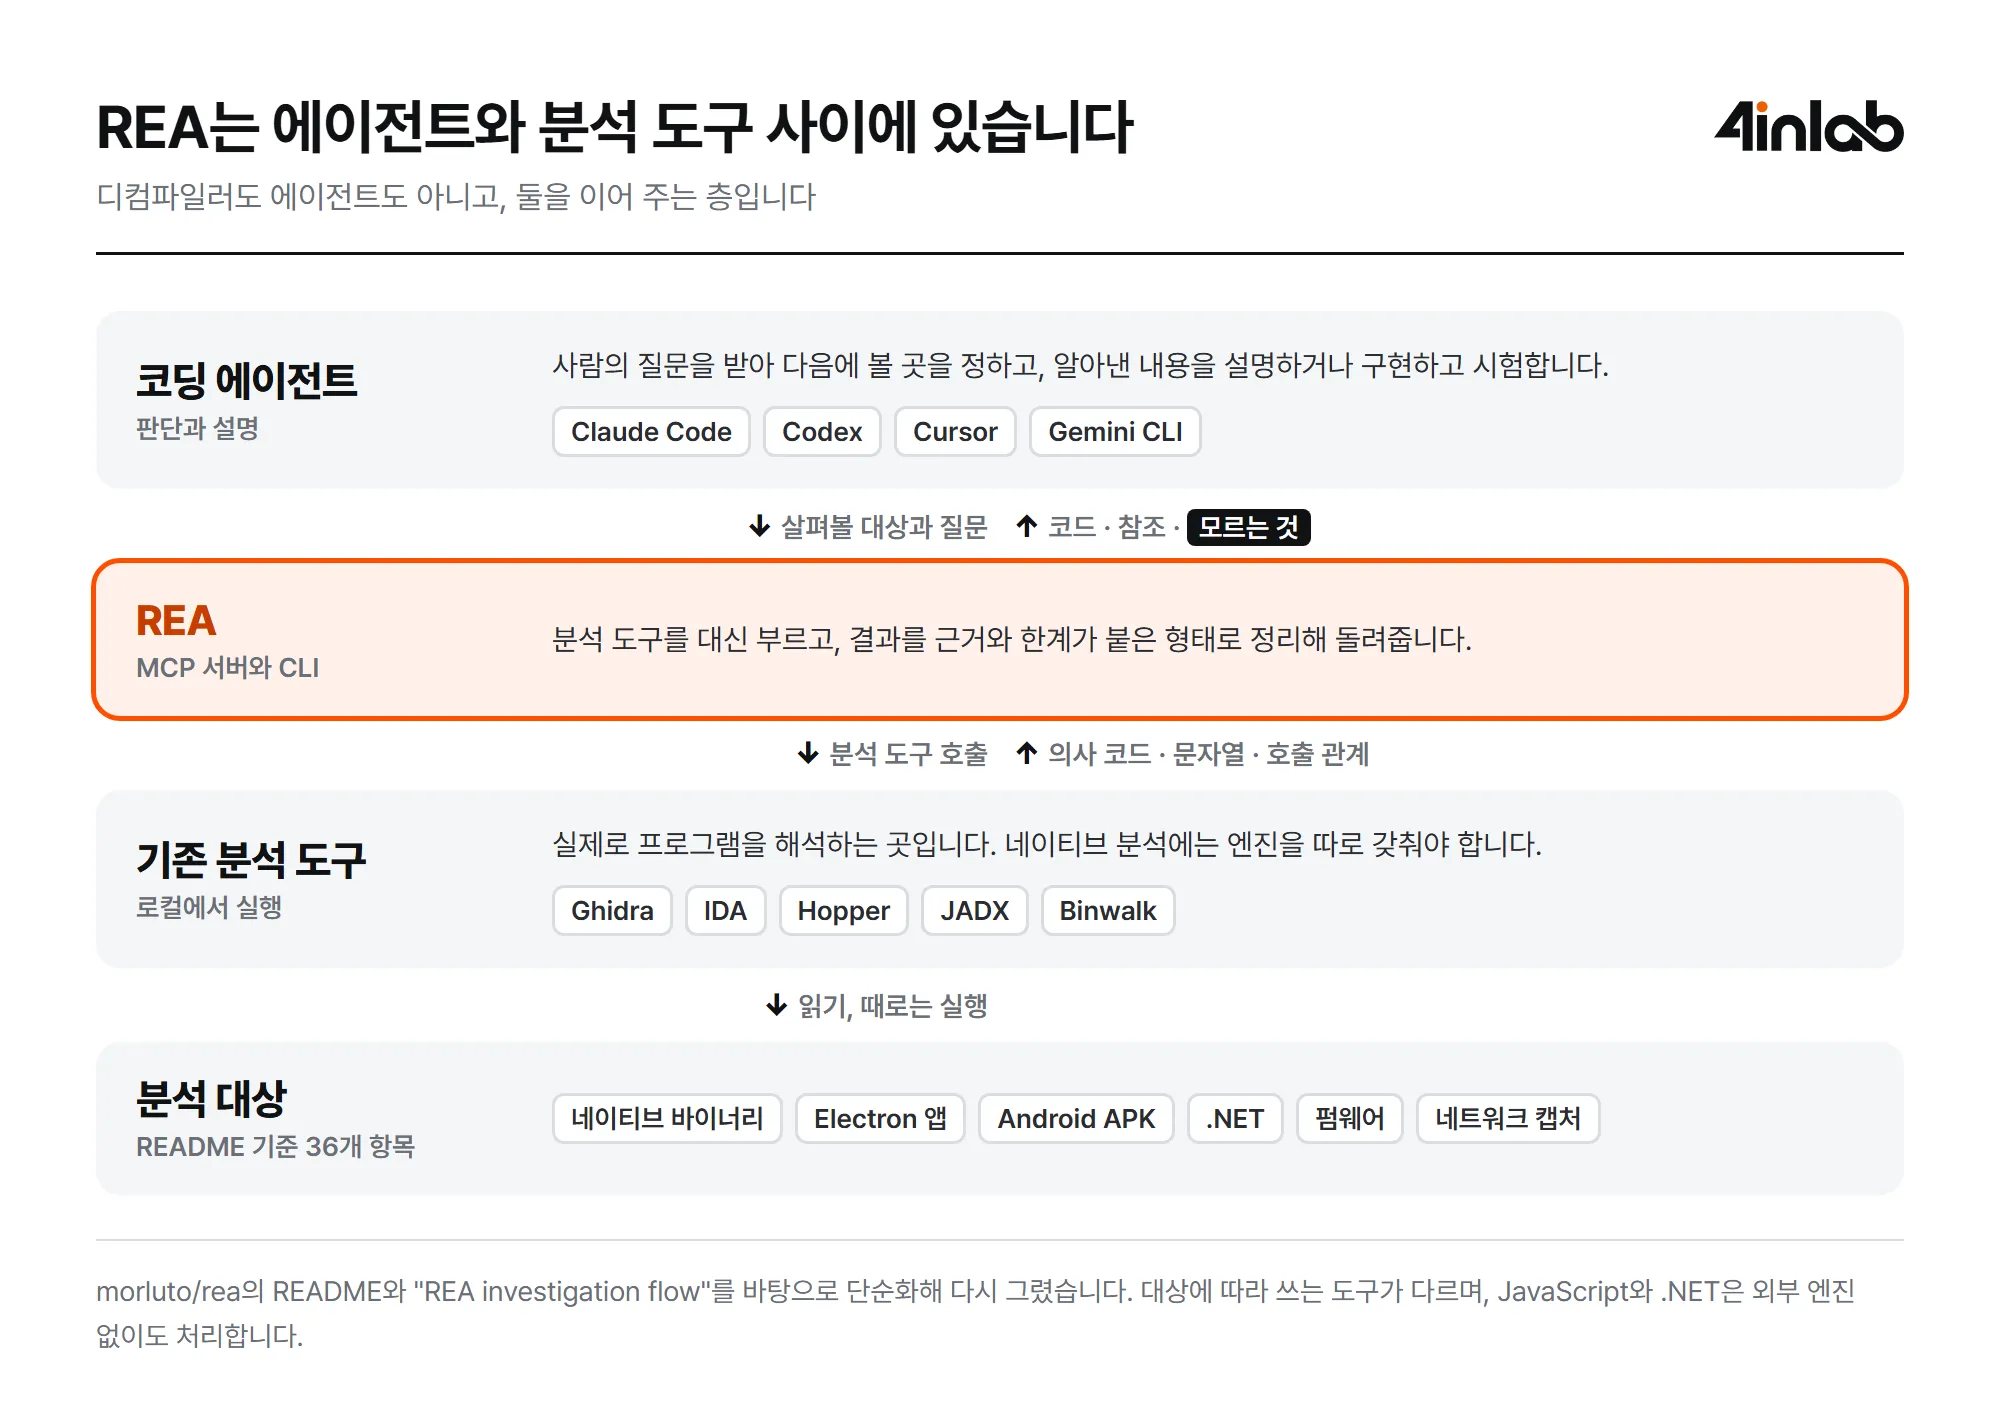
출처: morluto/rea (새 탭에서 열림)의 README를 바탕으로 다시 그림
대상은 넓습니다. README의 표에는 네이티브 바이너리, Electron 앱, Android APK, 펌웨어, 네트워크 캡처까지 36개 항목이 올라 있습니다. 네이티브 분석에는 Ghidra, IDA, Hopper 같은 엔진을 따로 갖춰야 하고, JavaScript와 .NET은 외부 엔진 없이도 처리합니다.
눈여겨볼 점은 돌려주는 결과의 모양입니다. REA는 코드와 참조 관계뿐 아니라 아직 모르는 것까지 함께 돌려줍니다. 공식 사이트 (새 탭에서 열림)의 예시도 REA가 제공한 것과 에이전트가 설명한 것을 나누어 표시합니다. 근거와 해석을 섞지 않겠다는 설계입니다.
그래서 이런 질문도 나옵니다. Hacker News에서는 (새 탭에서 열림) 에이전트에게 Ghidra를 직접 쓰게 하면 되는데 REA가 무엇을 더하느냐고 묻는 사람이 있었고, 바탕이 되는 디컴파일러는 수십 년 된 기술이라는 지적도 있습니다. 틀린 말이 아닙니다. REA가 새로운 분석 기법을 만든 것은 아닙니다.
그럼 어떤점이 달라졌을까요?
달라진 것은 기술보다 문턱입니다. 예전에는 도구를 익히고 어셈블리를 읽는 훈련을 거쳐야 시작이라도 할 수 있었습니다. 이제는 명령 한 줄로 설치하고 에이전트에게 말로 물어봅니다. npm 패키지는 10월 마지막 주에만 약 50만 번 내려받혔습니다.
프로젝트가 내세우는 데모도 눈길을 끕니다. 1996년 게임 DX-Ball에서 공의 위치를 좌우 소리 값으로 바꾸는 함수를 복원했고, InfoQ의 정리 (새 탭에서 열림)에 따르면 x86 시험 3,205건과 함수 바이트 63개가 일치했습니다. 다만 프로젝트 쪽 자료이고, 독립적으로 검증된 결과는 아닙니다.
직접 시험해 본 사람들의 결과는 조금 더 복잡합니다.
| 누가, 무엇을 | 잘된 점 | 드러난 한계 |
|---|---|---|
| IT-Connect: 함수 이름이 지워진 게임 실행 파일 | 12분 29초에 규칙을 찾고 웹 버전 제작 | 운석을 바위로 부름. 이름은 실행 파일에 남지 않음 |
| HackerNoon: 100MB Electron 앱을 에이전트 없이 명령줄로 정적 분석 | 약 52초에 분석, 창과 IPC 수가 직접 검색한 결과와 일치 | 파일 2개 누락, 결과 크기 제한으로 365개 파일의 연결 정보가 잘림 |
| MindStudio: Mac의 Preview 앱 재현 | 주요 기능이 작동하는 복제본 완성 | 스크린샷만 본 일반 에이전트가 먼저 끝남 |
표 1. 각 필자가 직접 해 본 시험입니다. 규모가 작아 일반화할 수는 없습니다. 출처: IT-Connect (새 탭에서 열림), HackerNoon (새 탭에서 열림), MindStudio (새 탭에서 열림)
MindStudio의 비교 (새 탭에서 열림)는 Preview처럼 단순한 앱이라면 화면만 봐도 상당 부분을 재현할 수 있다는 점을 보여 줍니다. REA가 힘을 낼 곳은 화면에 드러나지 않는 내부 규칙일 텐데, 이 시험이 그것까지 증명하지는 않습니다.
비용도 봐야 합니다. HackerNoon 시험에서 REA의 MCP 도구 목록은 170개, 약 1.95MB였고 요약 응답 하나가 약 672KB였습니다. 에이전트가 일을 시작하기도 전에 문맥을 크게 차지할 수 있는 크기입니다. 많이 보여 준다고 AI가 더 잘하지 않는다는 점은 컨텍스트 엔지니어링 글에서 다뤘습니다.
진짜 어려운 부분은 어디일까요?
도구를 부르기 쉬워졌다고 읽은 내용을 제대로 이해하게 된 것은 아닙니다. 올해 8월과 9월에 나온 연구 두 편이 이 차이를 보여 줍니다.
SRE-Bench (새 탭에서 열림)는 기존 시험의 약점에서 출발합니다. 공개된 문제는 모델이 답을 외웠을 수 있어서 실력을 재기 어렵습니다. 연구진은 전문가 5,000시간 이상을 들여 공개된 적 없는 프로그램 19개를 만들고, 분석을 방해하는 기법을 입혀 과제 1,572개를 구성했습니다. 소스 코드 보안에 강한 GPT-5.6 Sol과 Claude Fable 5.1도 완전히 해결한 과제는 각각 31.5%, 26.9%였습니다.
예산 상한과 안전장치를 없앤 GPT-6 Astra는 네 번 시도 기준으로 거의 만점을 받았습니다. 그런데 여러 답 가운데 맞는 답을 안정적으로 고르는 일은 여전히 어려웠습니다. 답을 낼 줄 아는 것과 어느 답이 맞는지 아는 것은 다른 능력입니다.
Reveree (새 탭에서 열림)는 실패가 어디서 나는지 살폈습니다. CTF 과제 88개로 모델 9개를 평가했더니 실패가 이해 단계에 몰려 있었고, 예산과 추론 노력을 늘려도 거의 나아지지 않았습니다. 연구진은 이를 자원이 아니라 역량의 한계로 봅니다.
도구를 부르는 일은 명령 한 줄로 쉬워졌지만, 읽은 내용을 제대로 이해했는지 가리는 일은 아직 쉬워지지 않았습니다.
왜 이렇게 어려울까요? 컴파일을 거치면 변수 이름과 주석, 설계 의도가 사라집니다. 디컴파일 결과는 원본이 아니라 재구성입니다. IT-Connect 시험에서 운석을 바위로 부른 일은 웃고 넘길 수 있습니다. 하지만 HackerNoon 시험에서 REA는 헬퍼 함수 뒤에 숨은 발신자 검증을 찾지 못했습니다. 이런 결과를 그대로 믿으면 있는 보안 검사를 없다고 판단하게 됩니다. 설명이 그럴듯할수록 틀린 부분을 찾기는 더 어렵습니다.
REA의 고지문 (새 탭에서 열림)도 결과가 불완전하거나 틀릴 수 있으니 근거를 확인하라고 적고 있습니다. 모르는 것을 모른다고 표시하는 설계가 중요한 이유입니다. 쓰는 쪽에서도 동작을 이미 아는 프로그램으로 도구의 한계부터 재 보는 편이 좋습니다.
현장 장비에 사용해도 괜찮을까요?
제조 현장에는 문서가 없거나 제조사 지원이 끝난 장비와 프로그램이 적지 않습니다. 장비가 어떤 데이터를 어떻게 주고받는지 몰라서 연동 프로젝트가 막히기도 합니다. REA의 대상 목록에 펌웨어, 네트워크 캡처, 로직 신호 기록이 있는 것을 보면 이런 곳에 쓸 수 있겠다는 기대가 생깁니다. 다만 실제 산업 프로토콜을 에이전트로 해독한 공개 사례는 찾지 못했습니다.
반대로 위험을 보여 주는 실험은 있습니다. 보안 회사 Forescout (새 탭에서 열림)는 9월에 Claude Code와 Ghidra로 실제 PLC를 다룬 실험을 공개했습니다. REA를 쓴 실험은 아니지만 같은 방식입니다. 한 모델에서 이미 알려진 취약점을 비슷한 모델로 옮길 수 있는지 본 것으로, 목표까지 도달하는 데 약 8시간 32분과 API 비용 약 535달러가 들었습니다. 그동안 연구자가 잘못된 가설을 계속 바로잡아야 했고, Forescout는 숙련자라면 더 빠르고 싸게 끝냈을 것으로 평가합니다.
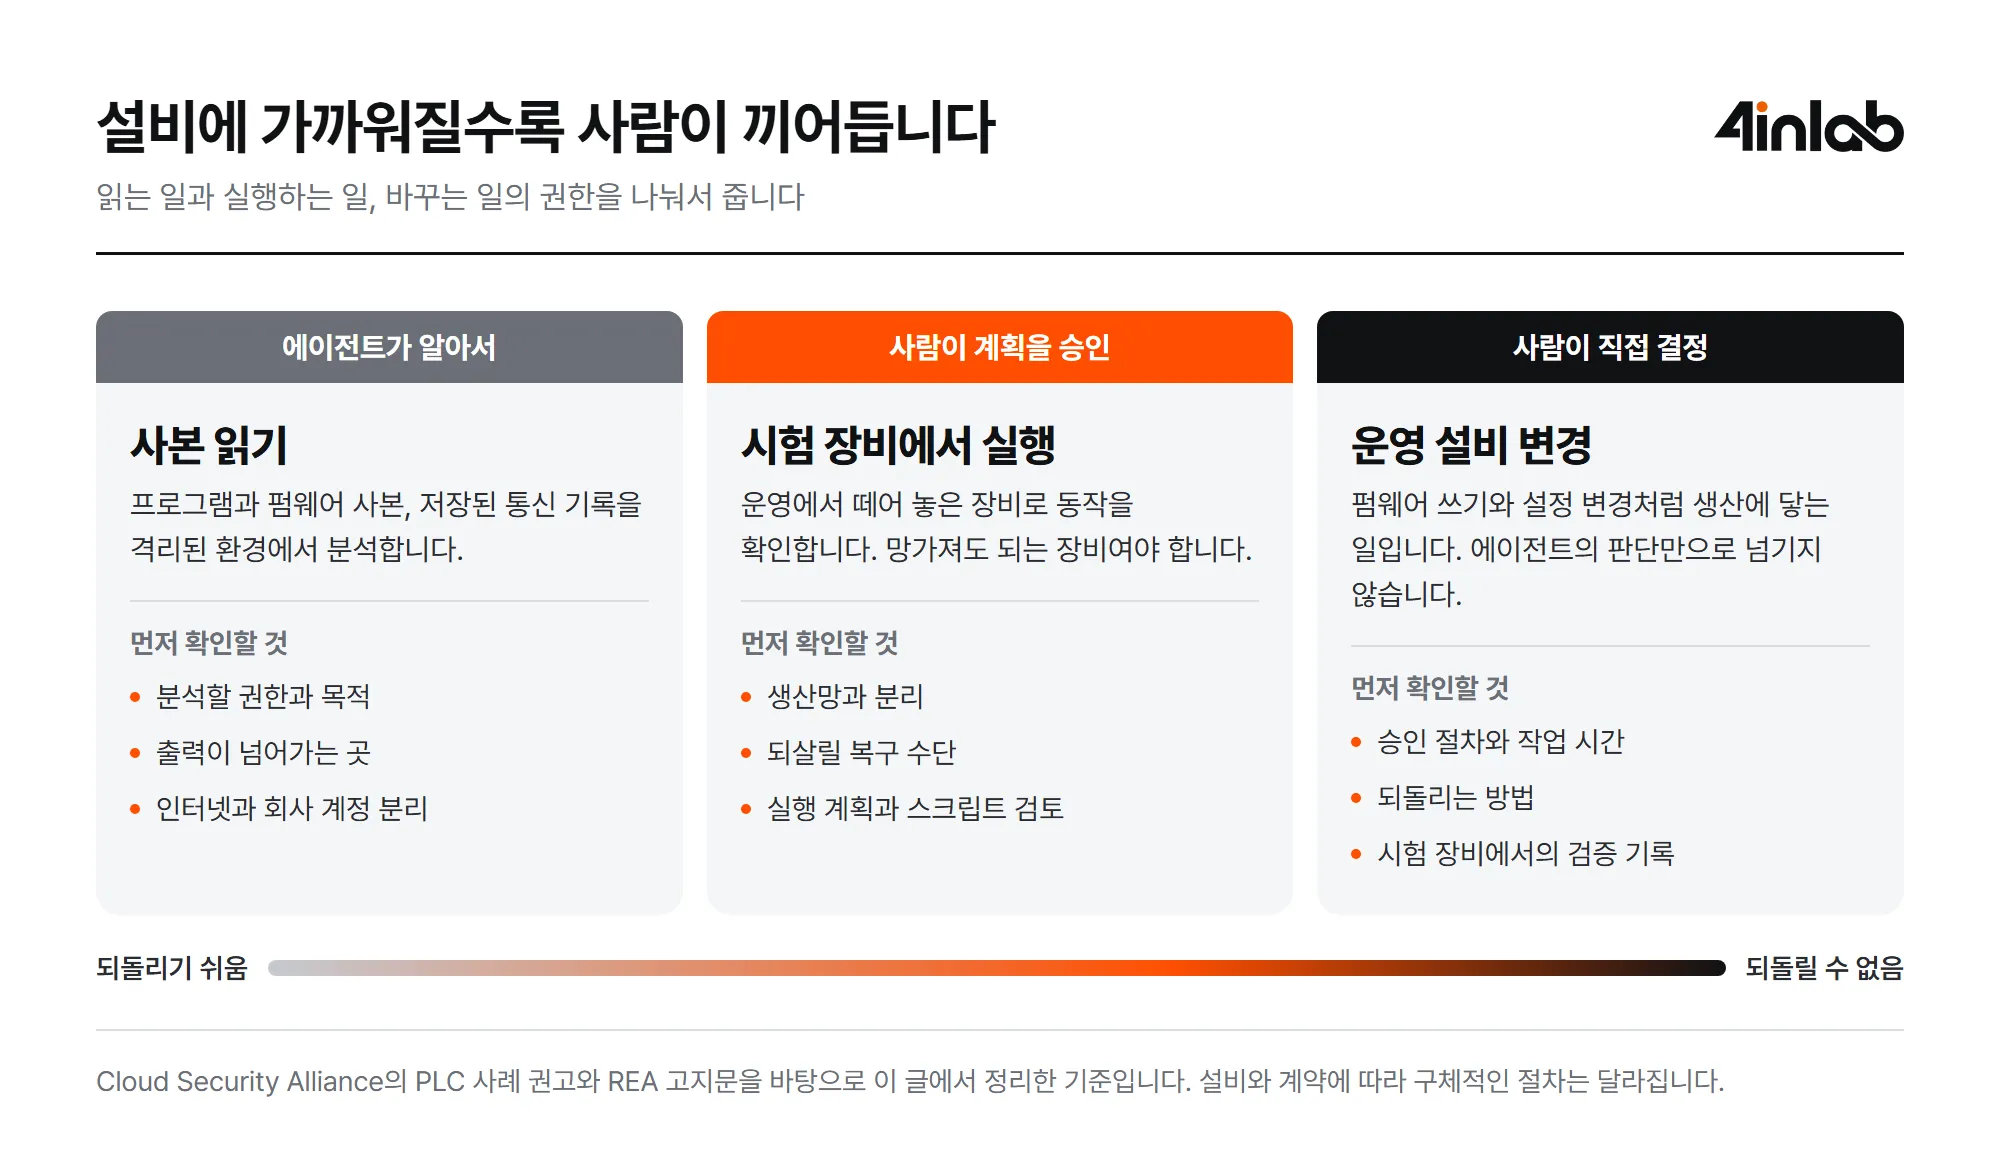
더 눈여겨볼 장면은 그다음입니다. 후속 작업에서 AI가 만든 코드가 플래시 메모리 영역에 쓰기를 하면서 장비가 영구히 고장 났습니다. 이런 장비는 진단 수단이 적어 잘못된 쓰기를 되돌리기 어렵습니다. Forescout와 Cloud Security Alliance (새 탭에서 열림)가 짚는 가까운 위험도 악의적인 공격보다, 권한을 받은 에이전트가 물리 장비에 저지르는 실수입니다.
소프트웨어는 되돌리면 되지만 설비는 그렇지 않습니다. 그래서 공장에서는 읽는 일과 실행하는 일, 바꾸는 일의 권한을 나눠서 줘야 합니다. 상시 에이전트 글에서 다룬 살피기와 행동의 분리가 여기서는 설비 앞의 안전 문제가 됩니다.
어디까지 괜찮은 걸까요?
할 수 있다는 것과 해도 된다는 것은 다릅니다. REA의 고지문은 보안 연구, 상호운용성, 소프트웨어 보존, 소유하거나 허가받은 소프트웨어의 감사를 쓰임새로 들고, DRM이나 라이선스 우회, 독점 소프트웨어 복제는 지원하지 않는다고 밝힙니다. 파일을 갖고 있다고 모든 작업이 허락되는 것은 아니고, 살펴볼 권한이 실행이나 장치 변경 권한까지 뜻하지도 않는다고 적었습니다.
우리나라에서는 저작권법 제101조의4 (새 탭에서 열림)가 기준입니다. 정당한 권한으로 프로그램을 쓰는 사람이 호환에 필요한 정보를 쉽게 얻을 수 없을 때, 호환에 필요한 부분에 한해 허락 없이 역분석할 수 있습니다. 얻은 정보를 호환 외의 목적으로 쓰거나 제3자에게 넘기는 것, 표현이 실질적으로 유사한 프로그램을 만드는 데 쓰는 것은 허용되지 않습니다. 계약으로 역분석을 금지한 조항의 효력은 견해가 갈립니다 (새 탭에서 열림). 실제 업무에 쓰기 전에는 법무 검토가 필요합니다.
보안도 따로 봐야 합니다. 내 컴퓨터에서 돈다는 말을 안전하다는 뜻으로 읽으면 곤란합니다.
- 샌드박스가 아닙니다. 보안 문서 (새 탭에서 열림)는 "This is not a sandbox"라고 분명히 적습니다. 출처를 모르는 파일은 사용자 권한으로 돌아가는 로컬 분석기가 열게 되므로 격리된 환경이 필요합니다.
- 분석 결과는 밖으로 나갑니다. 분석은 내 컴퓨터에서 돌아도 도구 출력은 에이전트를 거쳐 모델 제공사로 전달됩니다. 회사 프로그램이라면 어떤 내용이 어디로 가는지 확인해야 합니다.
- 가짜 배포본이 나왔습니다. 10월에는 REA를 베낀 저장소가 Windows 실행 파일을 나눠 주고 있고 트로이목마로 탐지된다는 신고 (새 탭에서 열림)가 올라왔습니다. REA가 안내하는 공식 경로는 GitHub의 morluto/rea, rea.tools, npm의
rea-agents세 곳입니다.
한 가지 더 있습니다. 이 변화는 우리가 만든 프로그램에도 똑같이 적용됩니다. 배포한 앱과 장비 프로그램도 같은 방법으로 읽힙니다. 실행 파일 안에 넣어 둔 규칙과 비밀은 읽힐 수 있다고 보고 설계해야 합니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
AI가 시키기도 전에 일을 찾아서 한다고요?
다섯 회사의 에이전트는 모두 자기 컴퓨터로 24시간 일합니다. 기능은 빠르게 닮아 가고, 차이는 어디까지 맡길 수 있게 설계했느냐에서 갈립니다.
보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
AI 에이전트의 분석을 현장의 업무로 연결하려면
AI가 이상을 찾아낸 뒤에도 현장에는 확인하고 결정할 일이 남습니다. OpenBot 1.0을 사례로, 에이전트의 분석이 사람의 판단과 후속 업무로 이어지려면 무엇이 필요한지 살펴봅니다.