보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서 찾은 exploit_agent
"키는 채팅창 말고 여기에 직접 넣을 것. 두 줄 다 필요하다."
구글 위협 인텔리전스 그룹(GTIG)이 공격자의 시험용 서버에서 찾은 설정 파일에, 러시아어로 남아 있던 주석입니다. 두 줄에 들어갈 것은 LLM API 키였고, 그 키를 쓰는 프로그램의 이름은 exploit_agent였습니다. 이 프로그램은 인기 웹 소프트웨어의 보안 패치가 나오면 고치기 전후 코드를 비교해 취약점을 찾고, 공격 코드를 쓰고, 실제로 실행했습니다. 그 사이에 사람은 없었습니다.
GTIG는 11월 17일 낸 AI 위협 보고서에서, 취약점 발견부터 공격까지 사람 없이 자동으로 돌린 사례를 처음 확인했다고 밝혔습니다. 보고서를 따라가 보면 새로운 것은 공격 기법이 아닙니다. 패치가 나온 뒤 공격이 오기까지의 시간을 줄이는 일에서, 사람이 빠졌다는 점입니다.
고친 줄이 구멍의 위치를 알려 줍니다
보안 패치는 취약점을 고친 업데이트입니다. 패치 공지는 대개 "권한 확인 문제를 고쳤다" 정도로 짧지만, 고친 코드는 훨씬 많은 것을 말해 줍니다. 오픈소스라면 고치기 전후 코드를 그대로 나란히 놓을 수 있고, 아니어도 업데이트 전후 프로그램을 비교할 수 있습니다. 이를 패치 비교(patch diffing)라고 합니다. 새로 들어간 확인 한 줄을 거꾸로 읽으면, 고치기 전에는 그 확인 없이 통과할 수 있었다는 사실이 보입니다.
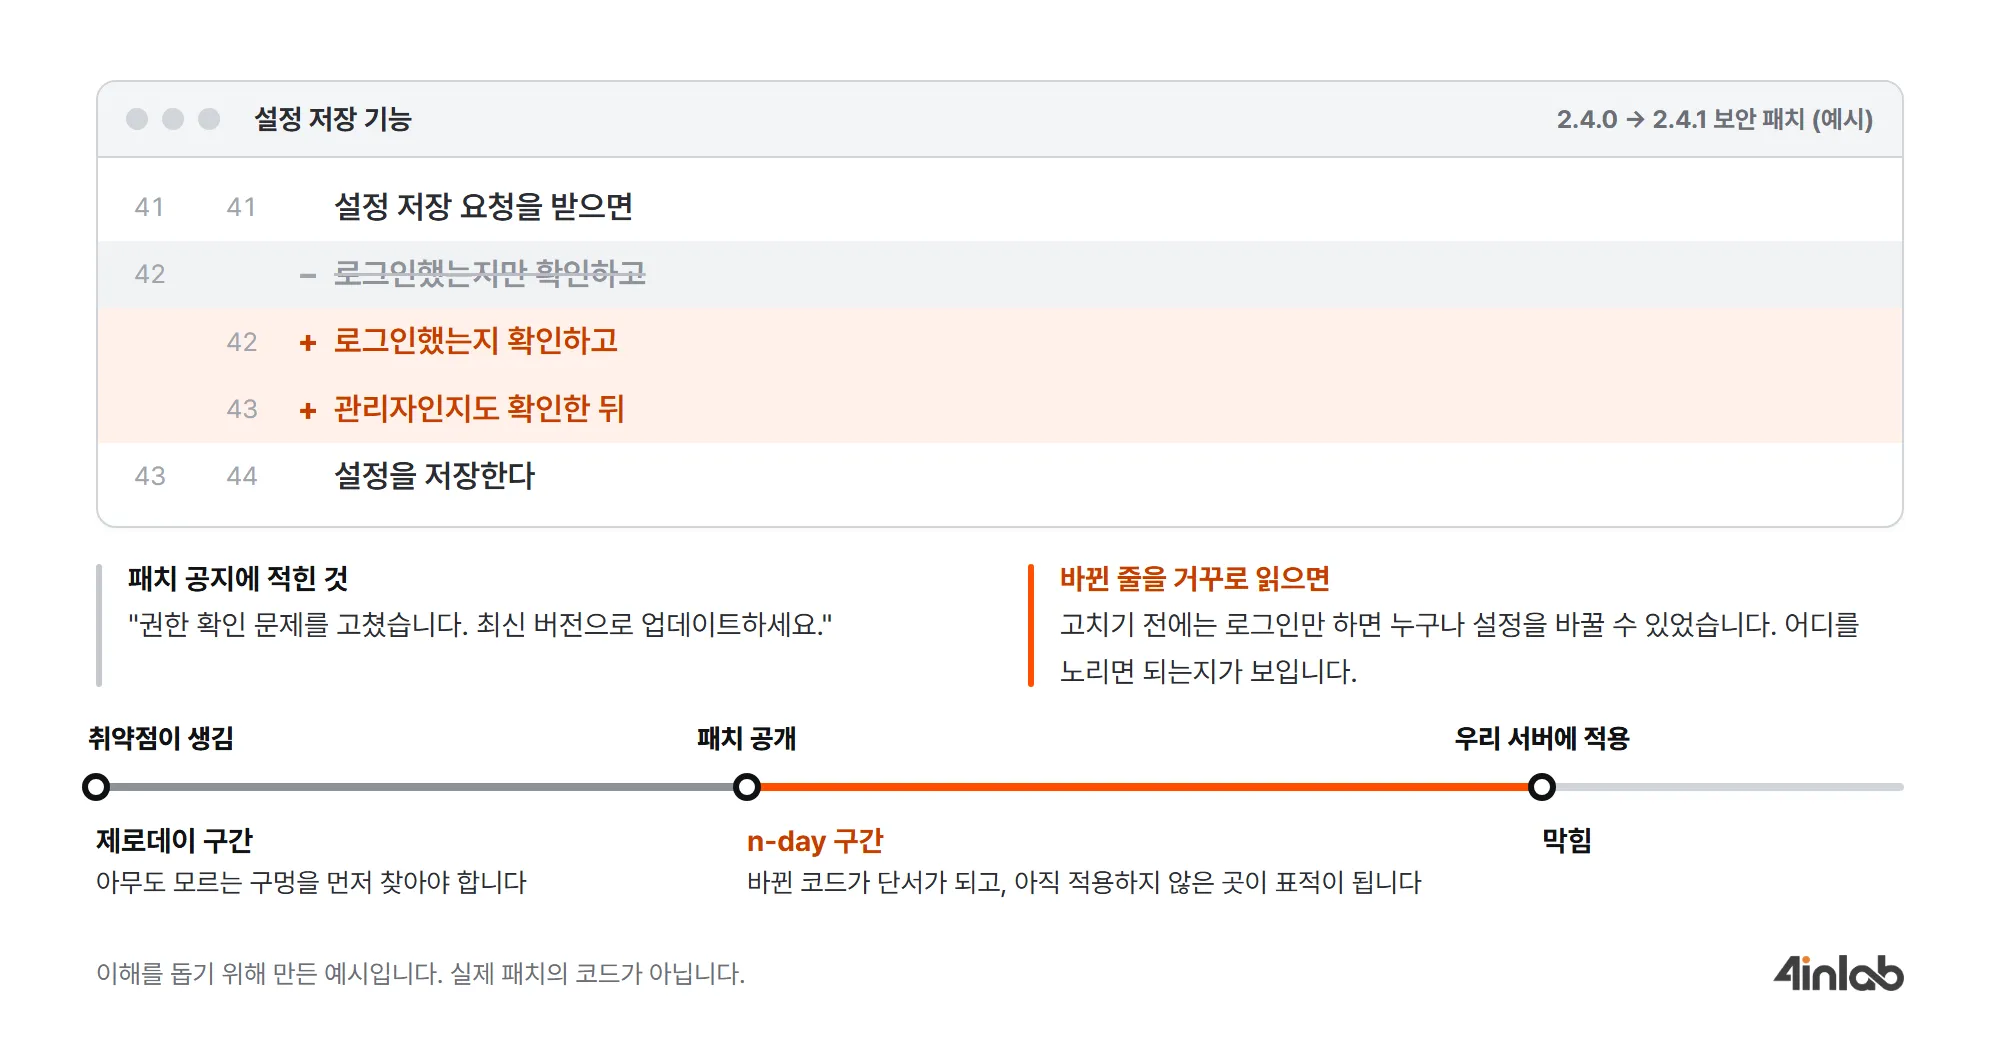
그래서 보안에서는 취약점을 패치를 기준으로 나눕니다. 패치가 나오기 전에 공격에 쓰이면 제로데이, 나온 뒤에 쓰이면 n-day입니다. 제로데이는 아무도 모르는 구멍을 먼저 찾아야 해서 어렵고 비쌉니다. n-day는 구멍의 위치가 이미 공개돼 있고, 패치를 아직 적용하지 않은 곳이 표적이 됩니다.
n-day 공격은 속도 싸움입니다. 바뀐 코드를 읽고, 원래 구멍을 이해하고, 그 구멍을 노리는 코드를 짜는 데 걸리는 시간이 짧을수록 더 많은 곳을 노릴 수 있습니다. 이 일은 지금까지 숙련된 사람의 몫이었습니다.
exploit_agent는 네 단계를 사람 없이 돌았습니다
GTIG가 찾은 exploit_agent는 여러 AI 에이전트로 짠 프레임워크로, 여러 프론티어 LLM과 로컬 LLM을 함께 연결해 썼습니다. 보고서에 적힌 일의 순서는 이렇습니다.
- 인기 웹 애플리케이션 소프트웨어의 패치 발표 전후 코드를 비교합니다.
- 찾은 차이를 분석해 취약점 후보를 고릅니다.
- 공격 코드 초안을 씁니다.
- 사람 개입 없이 자동으로 실행합니다.
한 번 돌고 끝나는 구조도 아니었습니다. 대상 소프트웨어를 계속 지켜보며 비교하도록 설정돼 있었습니다. 서버에는 피해 조직에서 빼낸 데이터와 침투 뒤에 쓰는 스크립트도 함께 있었습니다. 내부 정찰, 비밀번호 무차별 대입, 웹셸(원격 조종용 뒷문) 설치에 쓰는 것들이었고, 다른 공격자가 먼저 심어 둔 웹셸을 지우는 스크립트까지 있었습니다. 남이 먼저 들어온 서버까지 차지하려 한 것으로 보입니다. 피해 기록으로 보면 운영자는 프랑스의 미디어·엔터테인먼트 웹사이트와 교육 분야를 노렸습니다.
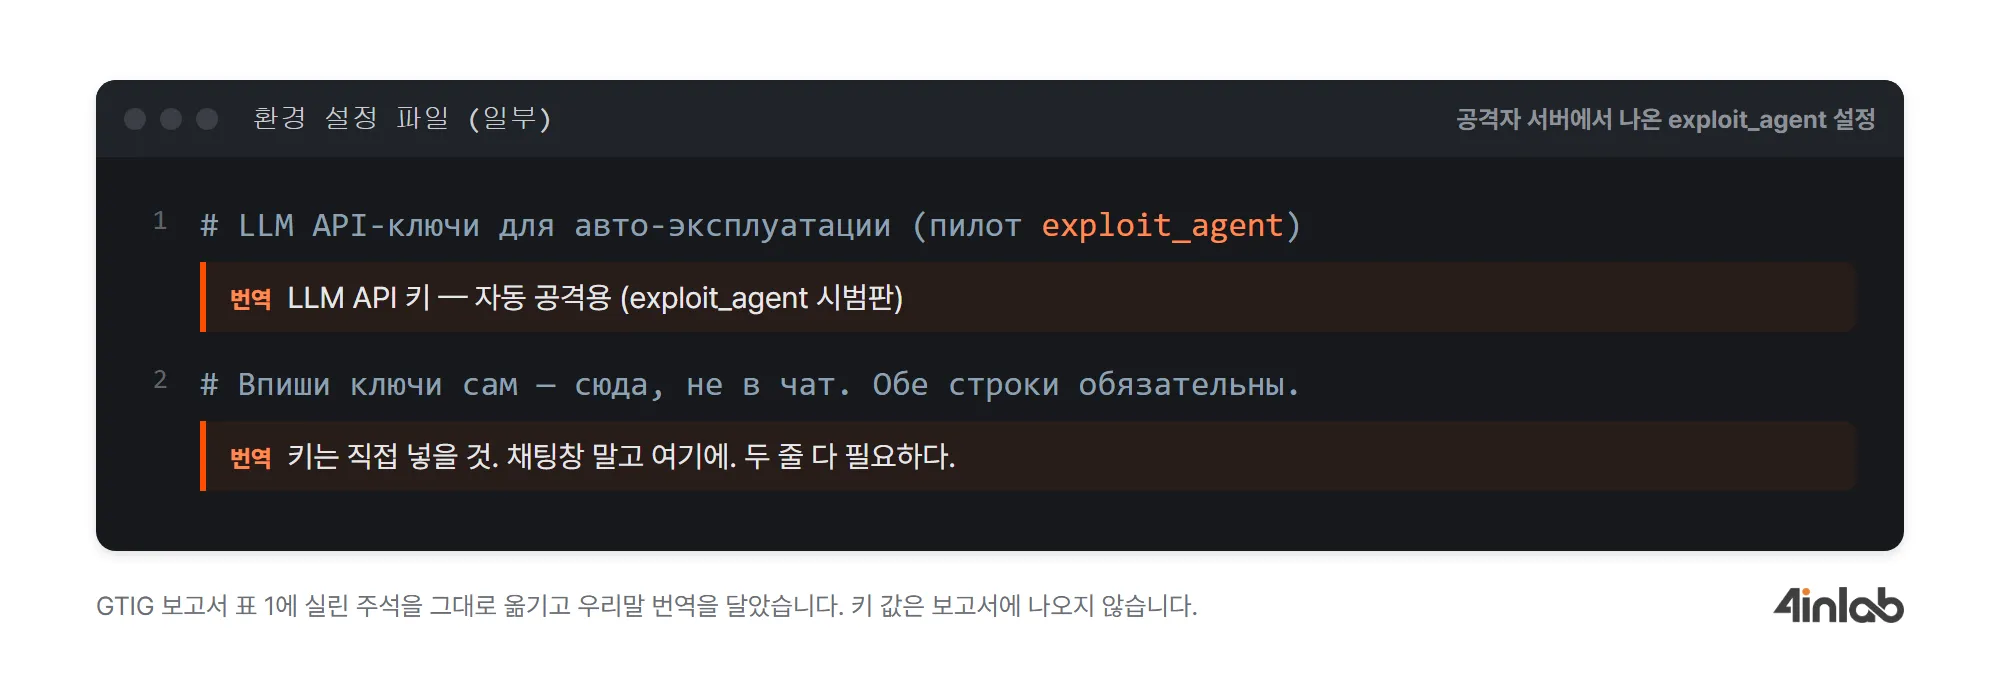
출처: Google Threat Intelligence Group, AI Threat Tracker (새 탭에서 열림)(2026-11-17) 표 1
보고서가 밝히지 않은 것도 그만큼 많습니다. 어떤 모델을 썼는지, 몇 번 시도해 몇 번 성공했는지, 패치가 나온 뒤 공격까지 얼마나 걸렸는지는 나오지 않습니다. 대상도 "인기 웹 애플리케이션 소프트웨어"라고만 적혀 있습니다. 사람 없이 돌아갔다는 말은 GTIG가 서버에서 본 구성을 두고 내린 평가이고, 실제 성공률을 잰 결과는 아닙니다.
AI를 쓴 공격은 전에도 있었습니다
같은 보고서에는 지난 8월 인쇄 관리 소프트웨어 PaperCut 사례도 나옵니다. 취약점 두 개가 공개되자 보안 연구자들이 LLM으로 하루 안에 동작하는 공격 코드를 만들었고, 나흘 뒤에는 LLM으로 공격 코드를 만들고 시험해 대상 목록까지 꾸린 것으로 보이는 공격이 수백 개 조직을 노렸습니다. 여기까지는 사람이 LLM을 도구로 쓴 경우입니다. GTIG도 지난 분기 보고서에서는 취약점 탐색과 공격을 일부 자동화한 시도까지만 다뤘습니다. exploit_agent는 그 고리에서 사람을 뺐습니다.
GTIG는 공격자의 LLM 사용을 일곱 단계로 나눠 봅니다. 채팅창에 묻던 1단계를 지나 지금은 여러 공격 단계를 LLM 도구가 맡고 사람은 최소한만 끼는 5단계에 와 있고, 사람이 거의 끼지 않는 6단계는 앞으로 1~3개월 안에 올 것으로 내다봤습니다. 이 예상이 맞는다면 exploit_agent 같은 도구는 한 운영자의 시범판에 그치지 않을 것입니다.
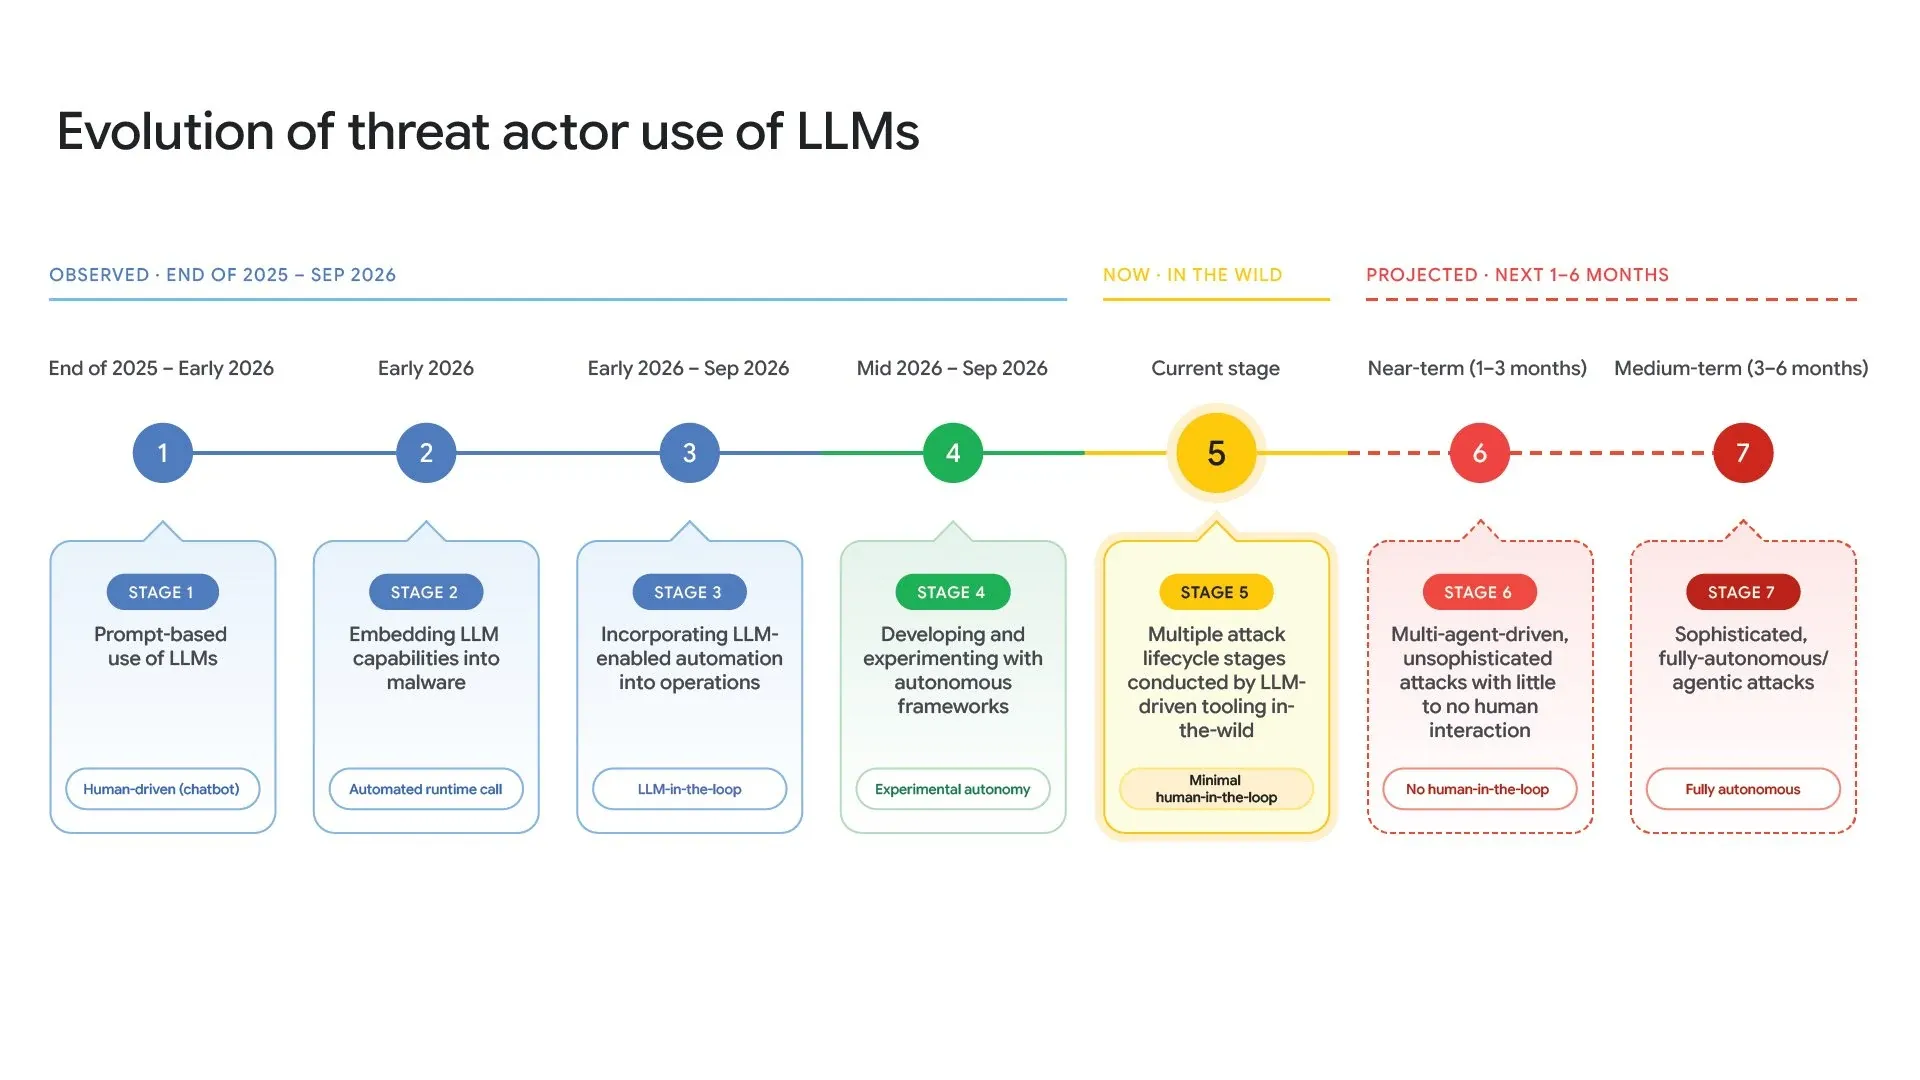
출처: Google Threat Intelligence Group, AI Threat Tracker (새 탭에서 열림) 그림 2
패치 뒤에 남는 시간은 이미 며칠입니다
GTIG가 n-day를 주목하는 이유는 볼 자료가 정해져 있기 때문입니다. 제로데이를 찾으려면 넓게 뒤져야 하지만, n-day는 버전별 소스 코드와 릴리스 노트, 보안 연구 글, 공개된 개념 증명 코드(PoC)를 보면 됩니다. 범위가 좁은 만큼 LLM에 맡기기도 쉽습니다.
패치 뒤에 남는 시간은 AI 이전부터 줄고 있었습니다. 구글 맨디언트가 잰 평균 공격 소요 시간(TTE)은 2018~2019년 63일에서 2023년 5일로 줄었고, 2025년은 -7일로 추정됩니다. 평균으로는 패치보다 공격이 먼저 오는데, 제로데이가 평균을 끌어내린 결과입니다. n-day만 따로 봐도 빠릅니다. 2023년 n-day 41개 가운데 29%는 패치가 나온 지 일주일 안에, 56%는 한 달 안에 공격에 쓰였습니다.
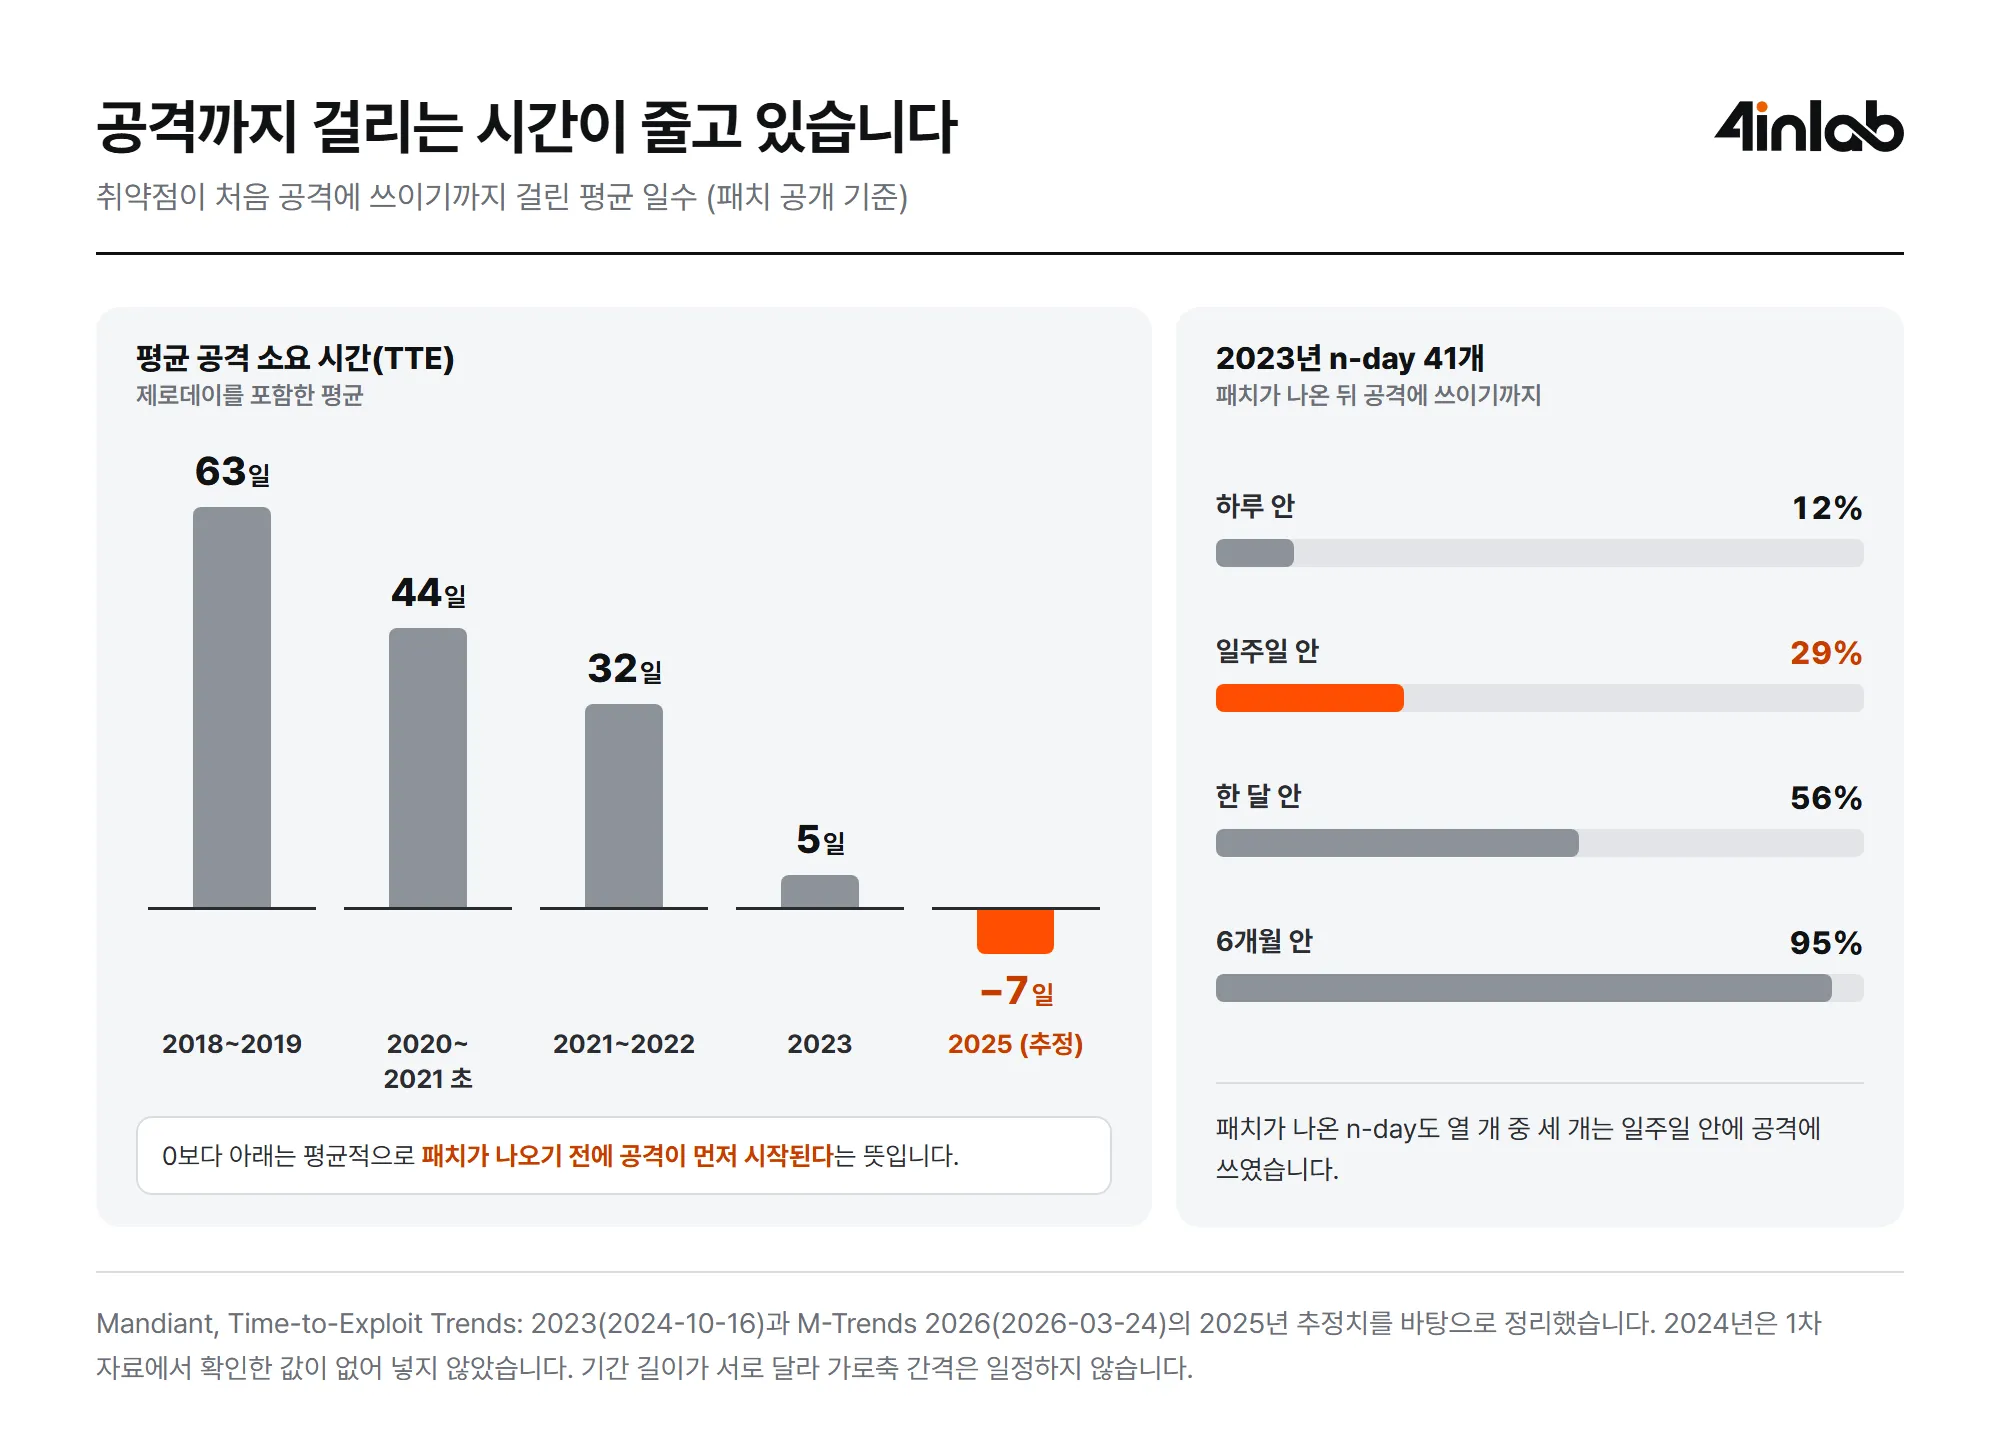
출처: Mandiant, Time-to-Exploit Trends: 2023 (새 탭에서 열림), M-Trends 2026 (새 탭에서 열림)
올해 숫자에서 눈여겨볼 것은 어느 쪽이 늘었느냐입니다. 2026년 1~8월 실제 공격에 쓰인 취약점은 141개로, 이미 2025년 한 해(127개)를 넘었습니다. 그런데 제로데이는 월평균 8개에서 11개로 조금 늘었을 뿐입니다(8월에만 22개로 튀었습니다). 늘어난 몫의 상당 부분은 n-day에서 나왔고, GTIG는 그 주된 원인이 LLM으로 패치와 버전 차이를 분석해 n-day를 빠르게 무기로 만드는 데 있을 수 있다고 봅니다.
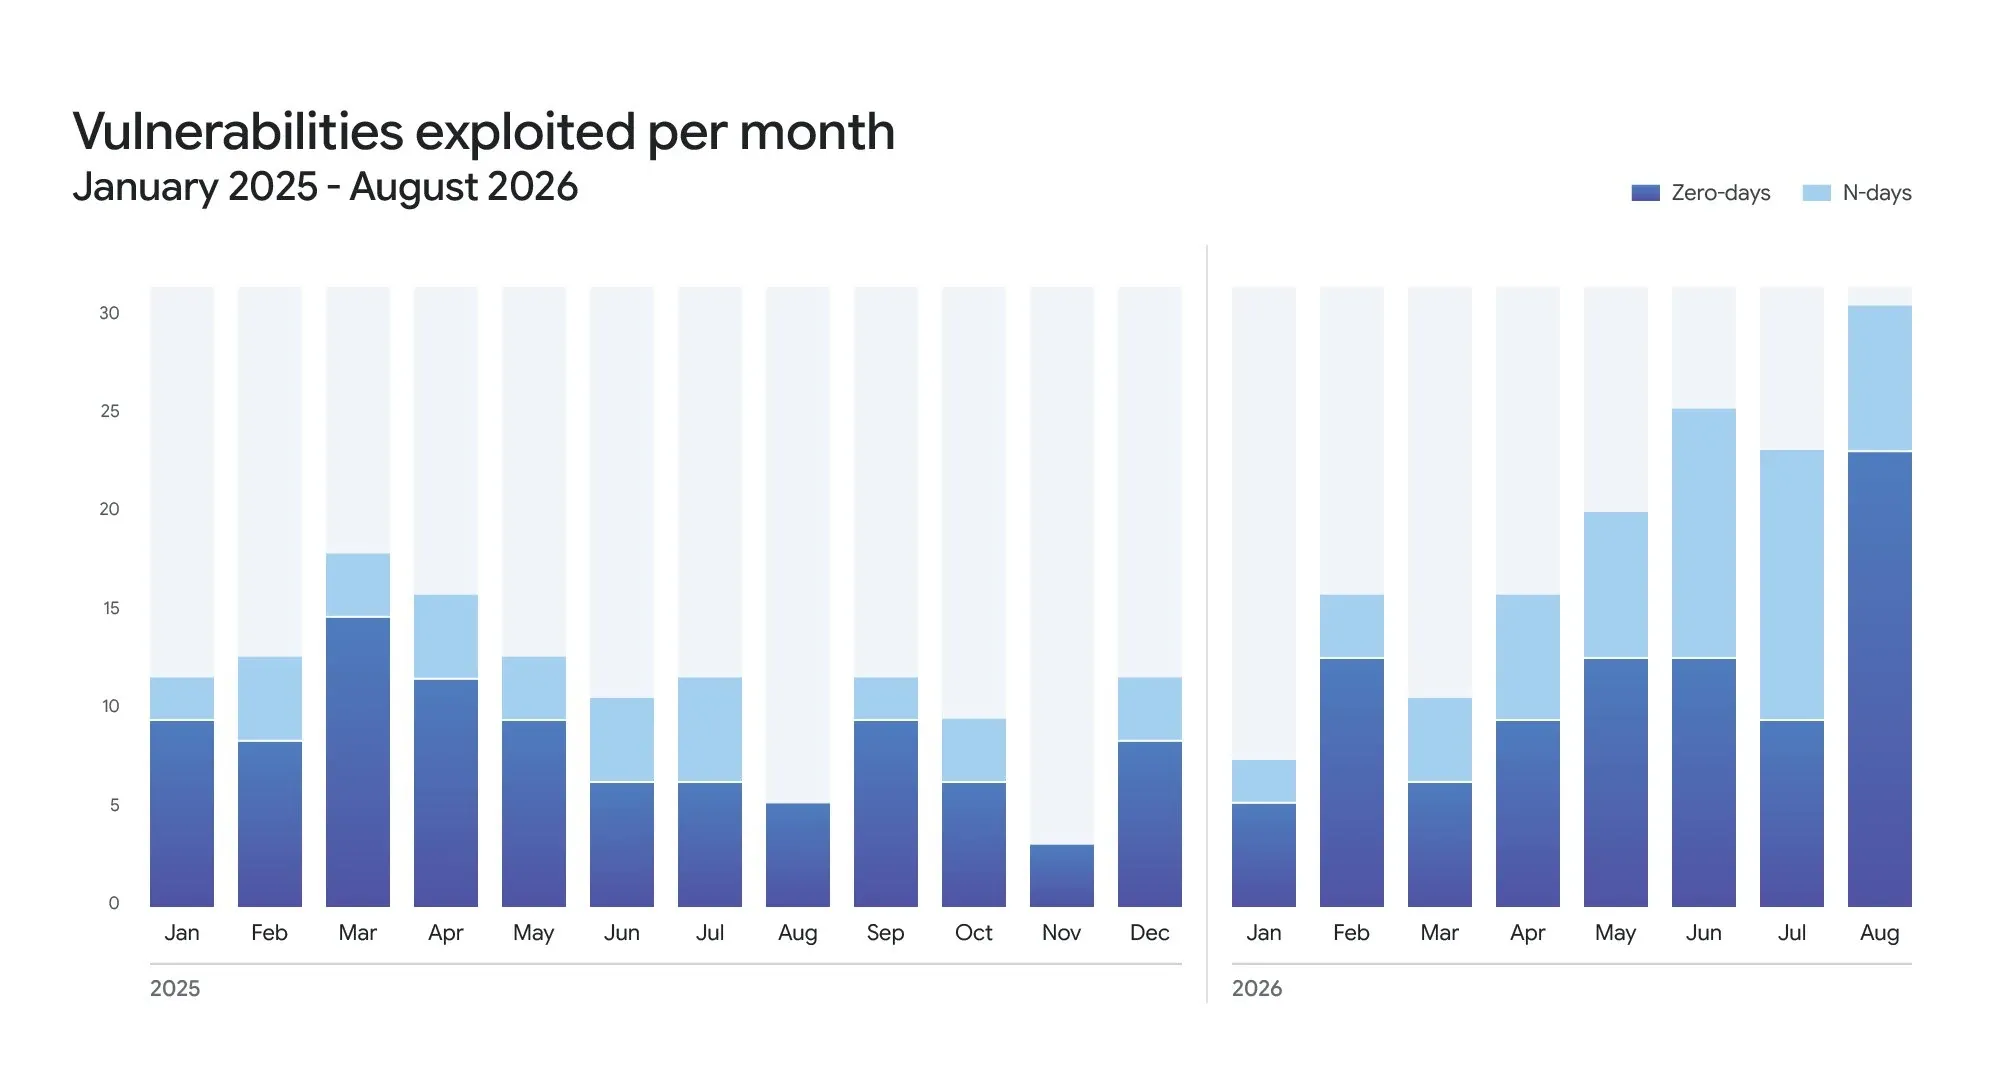
출처: Google Threat Intelligence Group, AI Threat Tracker (새 탭에서 열림) 그림 3
아직은 시끄럽고, 자주 틀립니다
GTIG는 이런 도구가 지금은 은밀함을 내주고 속도를 얻고 있다고 평가했습니다. 사람이 고르지 않고 자동으로 실행하다 보니 트래픽과 식별자, 코드 흔적이 많이 남고, 그만큼 잡힐 가능성도 커집니다. 다만 흔적이 많아도 목표는 충분히 이룬다는 말을 덧붙였습니다.
LLM이 만든 공격 코드가 다 동작하는 것도 아닙니다. 10월 PHP 취약점 패치가 나온 뒤 며칠 동안 LLM으로 만든 것으로 보이는 공격 코드 수백 개가 올라왔지만 동작하지 않았고, 이 가짜를 가려내는 일은 방어하는 쪽에 떨어졌습니다. 공개된 취약점 가운데 실제 공격이 확인된 것도 0.23%, 431개 중 1개꼴입니다. 패치마다 공격이 따라오지는 않습니다.
막는 쪽도 같은 자동화로 갑니다
구글은 2024년 딥마인드와 프로젝트 제로가 함께 만든 Big Sleep으로 아직 알려지지 않은 취약점을 찾고, CodeMender 같은 에이전트로 출시 전후에 취약점을 찾아 고칩니다. 공격자가 패치를 읽기 전에, 패치할 일 자체를 줄이자는 방향입니다. GTIG가 방어하는 쪽에 권한 것도 속도와 순서에 관한 것이었습니다.
- 모든 패치를 한꺼번에 하려 하지 말고, 실제 공격에 쓰이는 취약점부터 처리합니다.
- 인터넷에 열린 장비와 관리 화면을 먼저 지킵니다.
- 에이전트처럼 스스로 코드를 실행하는 작업은 격리된 환경에서 돌립니다.
- 소프트웨어를 만드는 쪽은 출시 전에 AI로 코드를 검토합니다.
AI를 만드는 도구도 표적입니다
AI 플랫폼을 다루는 팀이라면 같은 GTIG의 10월 동향 보고서에서 따로 볼 숫자가 있습니다. 2026년 1~8월에 공개된 AI 관련 취약점은 1,500개가 넘고, 그 절반인 782개가 LangChain, Langflow, Dify, MCP 같은 에이전트·오케스트레이션 프레임워크에서 나왔습니다. LiteLLM과 Langflow의 취약점은 이미 실제 공격에 쓰였습니다. 이런 프레임워크는 대부분 오픈소스이고 패치가 자주 나옵니다. exploit_agent가 지켜보던 "인기 웹 애플리케이션"과 조건이 크게 다르지 않습니다.
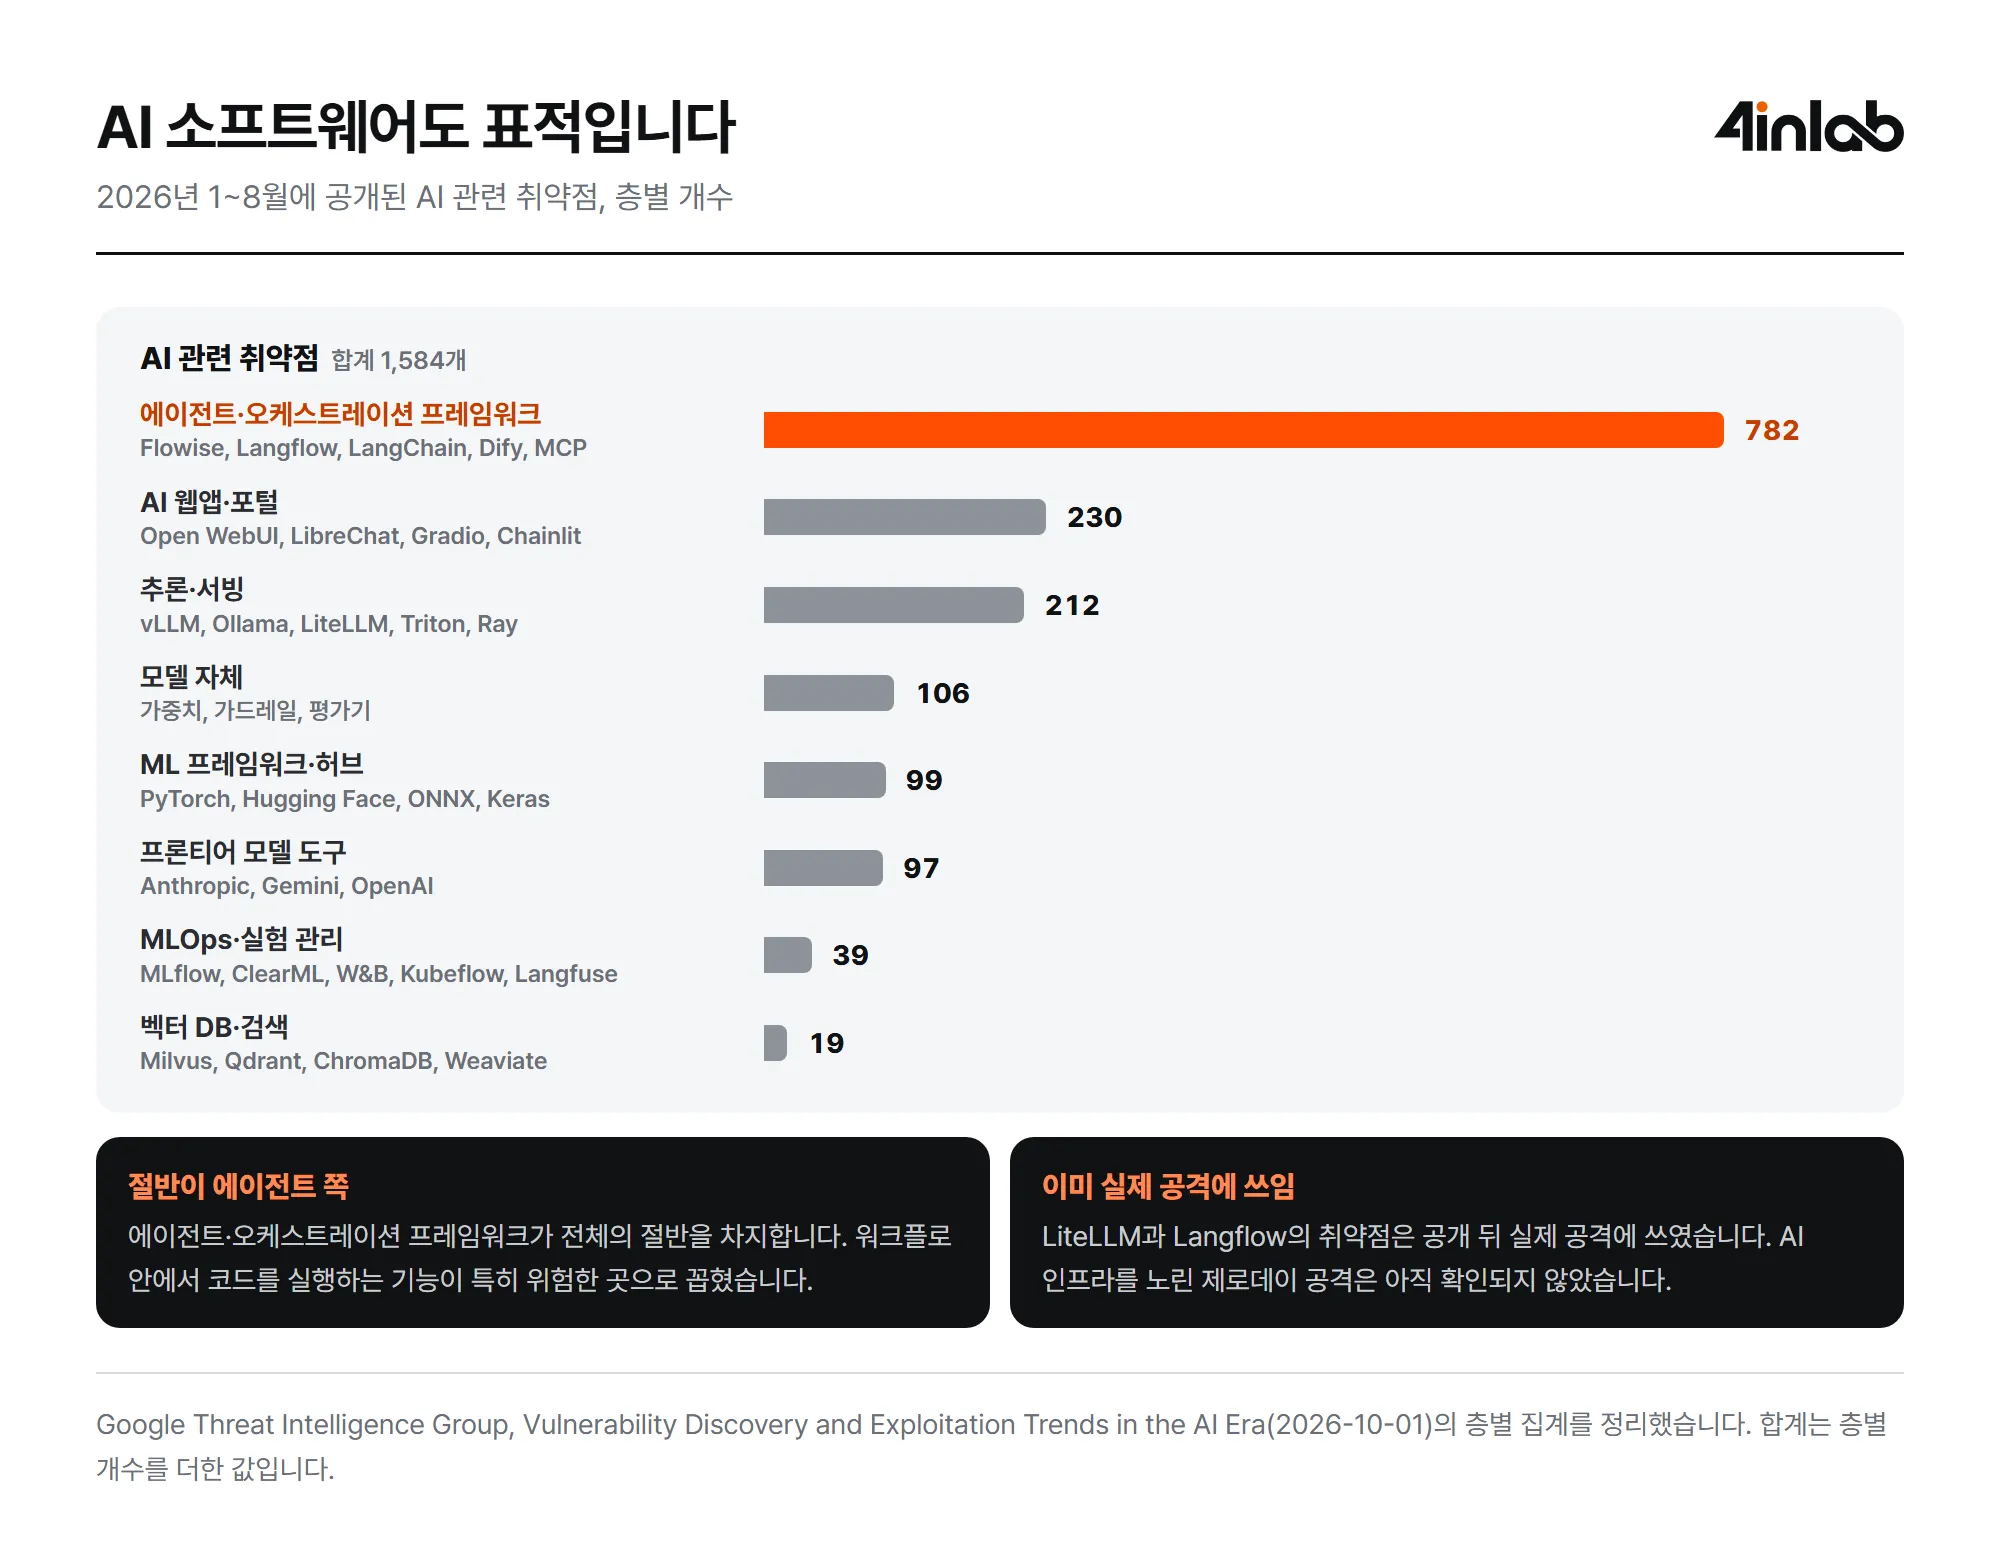
출처: Google Threat Intelligence Group, Vulnerability Discovery and Exploitation Trends in the AI Era (새 탭에서 열림)(2026-10-01)
GTIG의 예상대로라면 사람이 거의 끼지 않는 공격은 다음 분기 보고서에 더 자주 나올 것입니다. 그때 함께 볼 숫자는 패치가 나온 뒤 첫 공격까지 걸린 시간입니다. 이번 보고서에는 그 숫자가 없었습니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
AI 에이전트의 분석을 현장의 업무로 연결하려면
AI가 이상을 찾아낸 뒤에도 현장에는 확인하고 결정할 일이 남습니다. OpenBot 1.0을 사례로, 에이전트의 분석이 사람의 판단과 후속 업무로 이어지려면 무엇이 필요한지 살펴봅니다.
AI 에이전트가 일하는 곳은 어디일까요?
AI 에이전트는 이제 답만 하지 않고 코드를 돌리고, 브라우저를 몰고, 사내 시스템에 접근합니다. 그 일은 어디서, 무엇을 쥐고 해야 할까요? 에이전트가 일하는 구조부터 짚고, 구글이 공개한 Agent Compute Engine의 설계를 살펴봅니다.
왜 에이전트에게 스키마 대신 온톨로지를 줘야 할까? 엔비디아 Auto Ontology로 본 답
AI 에이전트에게 데이터베이스 스키마만 주면 SQL은 실행돼도 숫자가 틀릴 수 있습니다. 온톨로지가 무엇인지부터 짚고, 엔비디아가 공개한 Auto Ontology가 이 문제를 어떻게 푸는지 살펴봅니다.