로봇에는 어떤 AI가 들어갈까요?
하나하나 가르치던 로봇부터, 로봇 파운데이션 모델까지
자동차 공장에서는 로봇 팔이 쉬지 않고 용접을 하고, 부품을 옮기고, 페인트를 칠합니다. 이 로봇들은 같은 동작을 수없이 정확하게 되풀이하지만, 대부분 스스로 판단하지는 않습니다. 사람이 미리 가르쳐 준 위치와 경로를 따라 움직일 뿐입니다.
그런데 이번 달 구글 딥마인드가 메르세데스-벤츠 생산 라인에서 휴머노이드 로봇이 부품을 골라 담는 시험 결과를 공개했습니다. 같은 달 엔비디아는 시연 다섯 번이면 처음 보는 작업을 평균 95% 해내는 로봇 모델을 내놓았습니다. 둘 다 '로봇 파운데이션 모델'이라는 AI를 썼습니다.
지금 공장 로봇이 일하는 방식부터 짚고, 로봇 파운데이션 모델이 무엇이며 어디까지 왔는지 살펴보겠습니다.
지금 공장 로봇은 어떻게 일할까요?
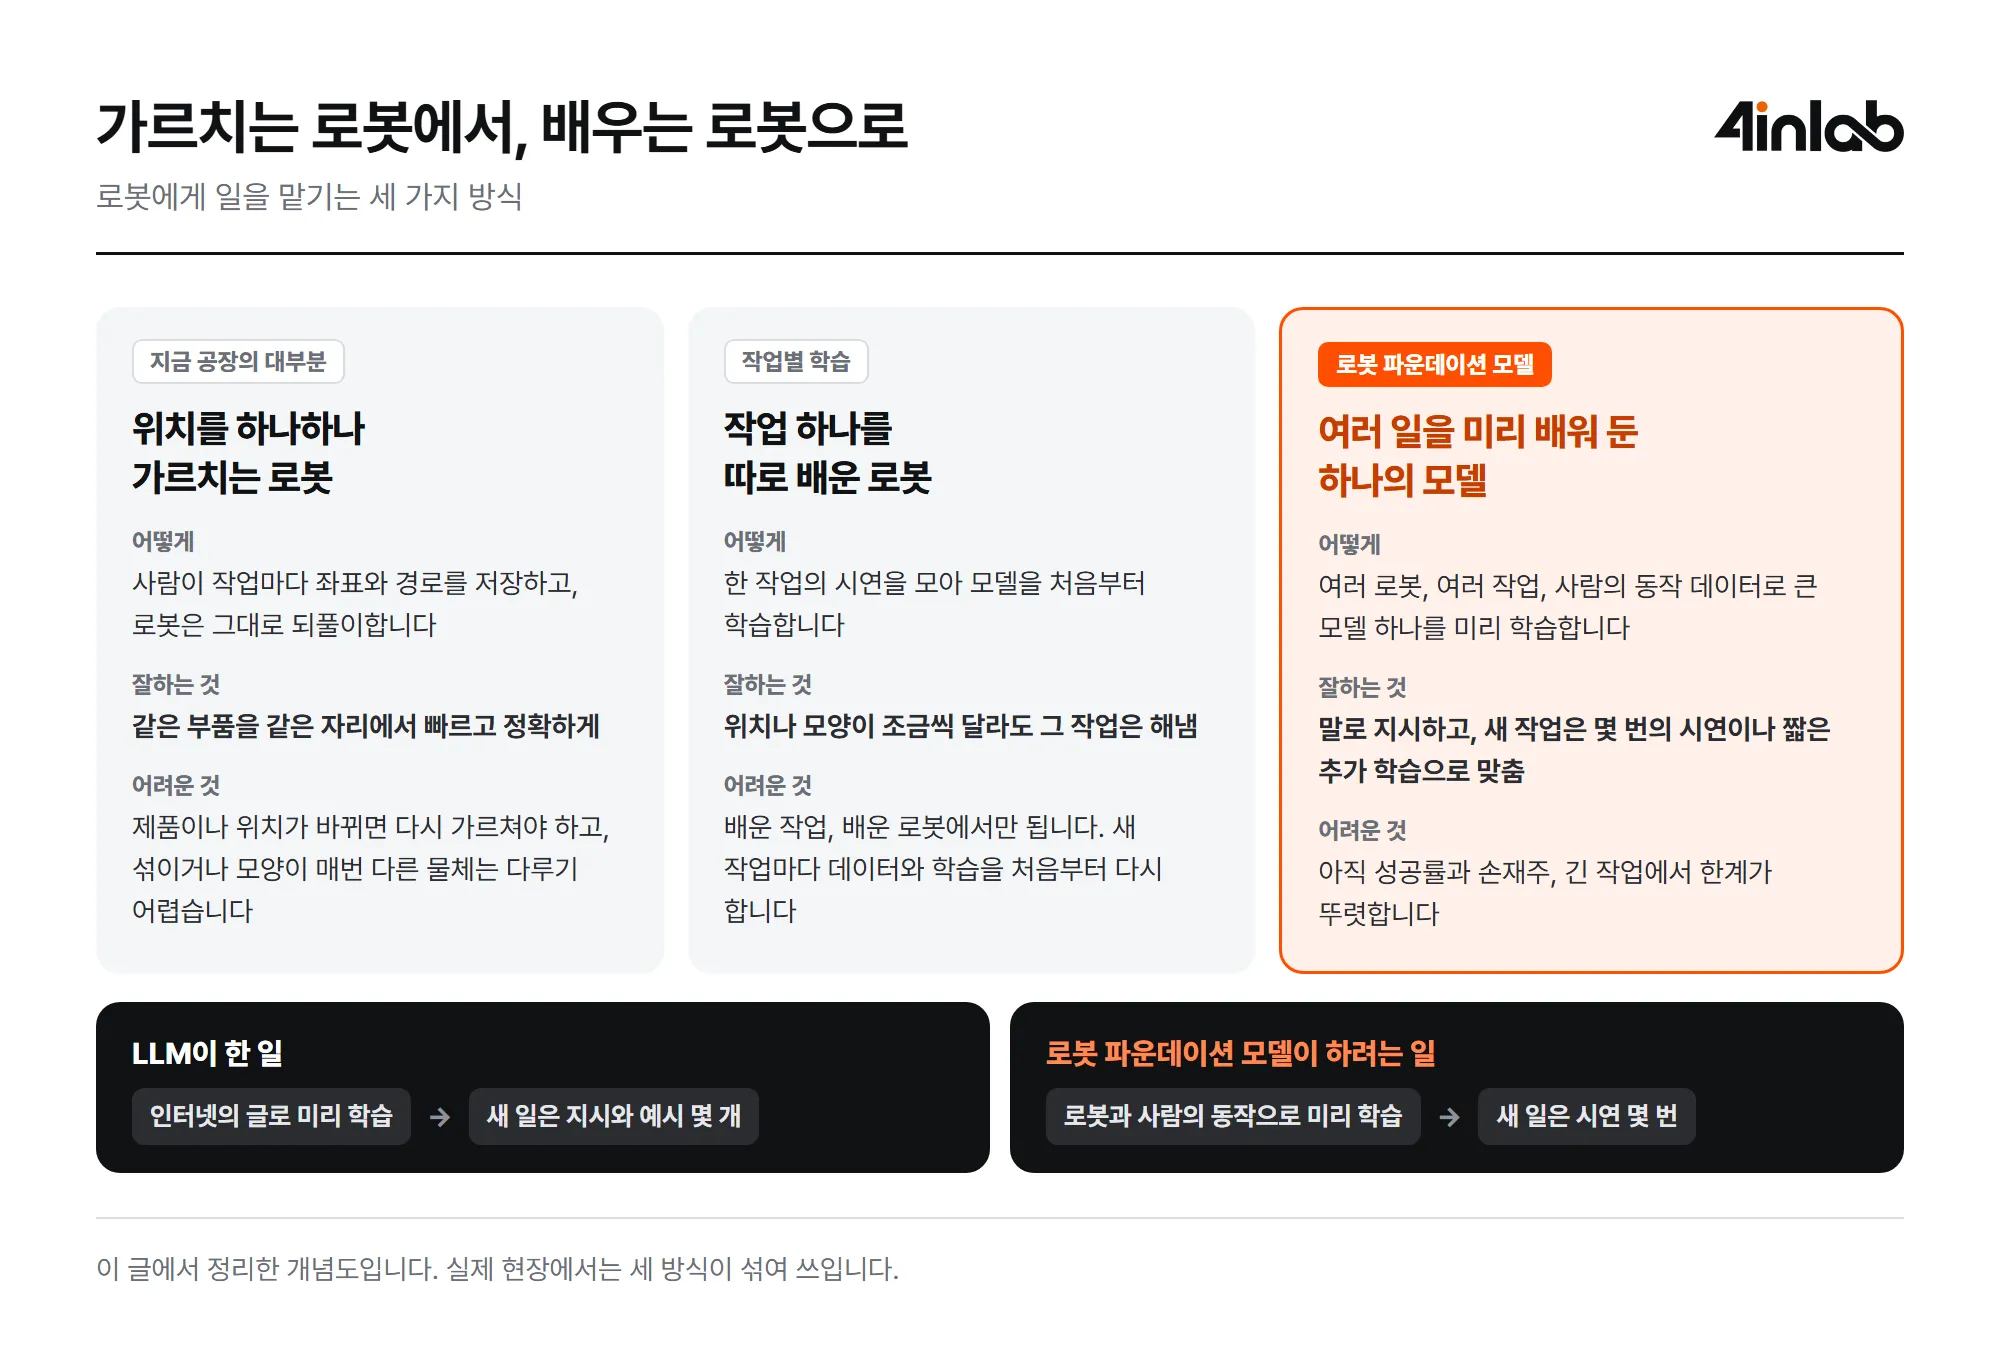
대부분의 산업용 로봇은 티칭(teaching)으로 일을 배웁니다. 사람이 조종기로 로봇 팔을 움직여 집을 위치, 지나갈 경로, 내려놓을 위치를 하나씩 저장하면, 로봇은 그 좌표를 그대로 되풀이합니다. 카메라로 부품 위치를 조금 보정하기도 하지만, 기본은 정해진 동작을 정확히 반복하는 것입니다.
같은 부품이 같은 자리에 오는 라인에서는 이 방식이 가장 빠르고 정확합니다. 문제는 무언가 바뀔 때입니다. 제품이 바뀌거나 부품 위치가 달라지면 다시 가르쳐야 하고, 통 안에 뒤섞인 부품이나 모양이 매번 다른 물체는 미리 정한 좌표로 다루기 어렵습니다. 여러 제품을 조금씩 만드는 공장일수록 로봇을 다시 가르치는 비용이 커집니다.
그래서 시연을 보고 배우는 로봇도 연구돼 왔습니다. 사람이 여러 번 시범을 보이면 그 작업을 하도록 모델을 학습시키는 방식입니다. 위치나 모양이 조금 달라도 해내지만, 배운 작업과 배운 로봇에서만 됩니다. 새 작업마다 데이터를 다시 모으고 처음부터 다시 학습해야 합니다.
로봇 파운데이션 모델은 무엇일까요?
로봇 파운데이션 모델은 이 순서를 뒤집습니다. 여러 로봇, 여러 작업, 사람의 동작까지 담은 데이터로 큰 모델 하나를 먼저 학습해 두고, 새 작업이나 새 로봇에는 몇 번의 시연이나 짧은 추가 학습으로 맞춥니다. LLM이 인터넷의 글로 미리 배운 뒤 지시와 예시 몇 개로 새 일을 하듯, 로봇의 동작에서도 같은 일을 하려는 것입니다.
모델의 입력은 머리와 손목에 달린 카메라 영상, 말로 된 지시, 그리고 관절 각도 같은 로봇의 상태입니다. 모델 안은 크게 두 부분으로 나뉩니다.
- 보고 알아듣는 부분: 이미지와 글을 함께 이해하도록 미리 학습된 모델 몸통입니다. 무엇이 어디 있고 무엇을 하라는지 파악합니다.
- 몸을 움직이는 부분: 앞으로 1초 남짓 동안의 동작을 한 묶음으로 계산해 모터 명령으로 내보냅니다. 로봇은 움직이면서 1초쯤마다 다시 보고 다시 계산합니다.
이렇게 보고(Vision), 알아듣고(Language), 움직이는(Action) 모델을 VLA라고 부릅니다. 2023년 구글이 RT-2 (새 탭에서 열림)를 내놓으며 붙인 이름입니다. 요즘은 그 위에 작업을 여러 단계로 나누고 진행 상황을 확인하는 느린 판단 모델을 따로 두는 구성이 많습니다. 구글 딥마인드의 Gemini Robotics도 계획을 맡는 ER 모델과 몸을 움직이는 VLA를 나눠 씁니다.
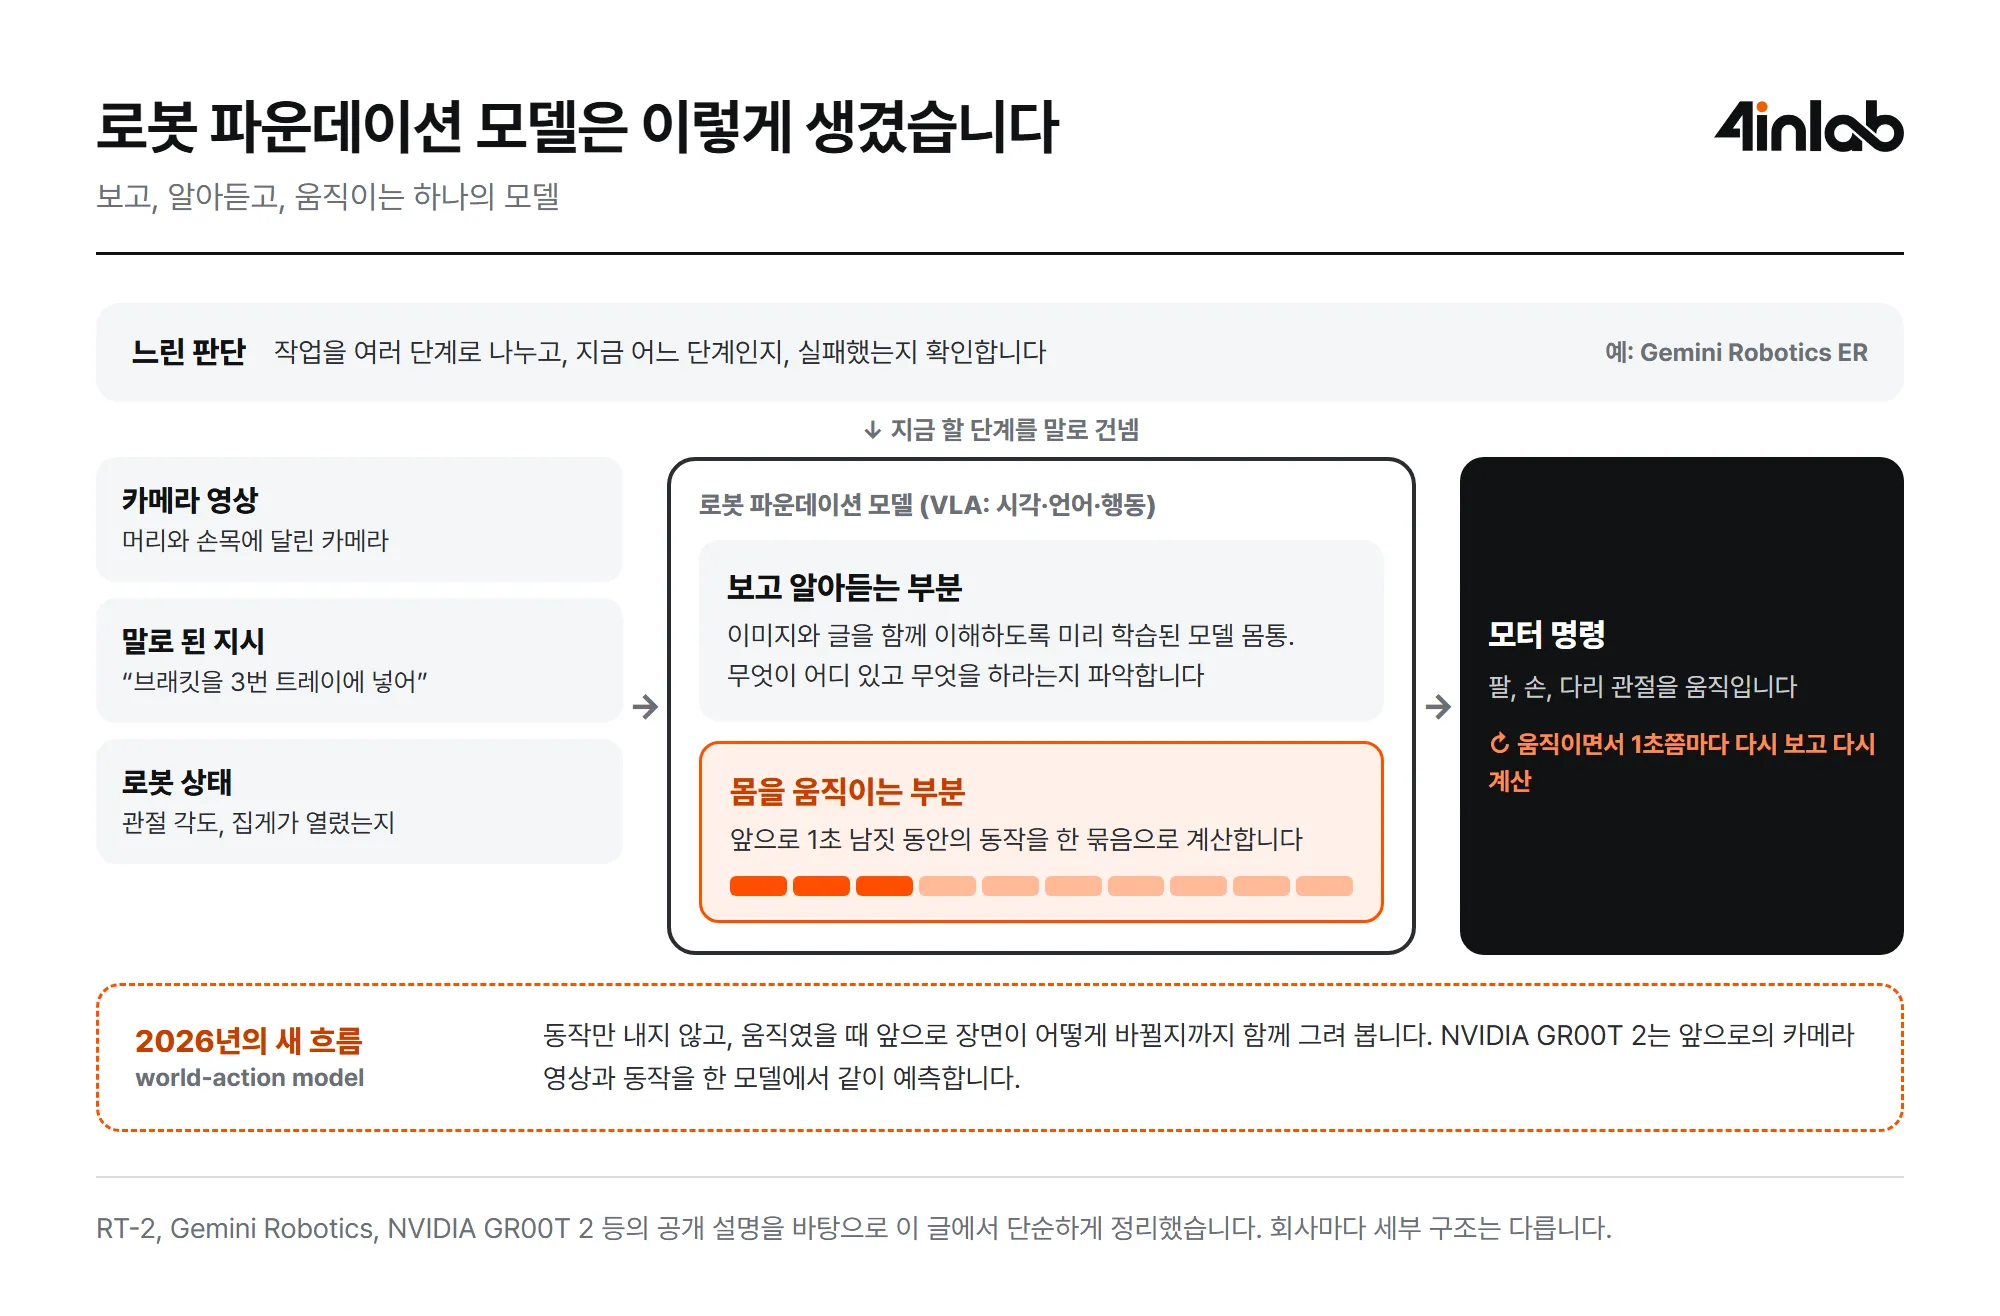
출처: RT-2, Gemini Robotics, NVIDIA GR00T 2 (새 탭에서 열림)의 공개 설명을 바탕으로 단순하게 정리
올해는 여기서 한 걸음 더 나아갔습니다. 동작만 내지 않고, 움직였을 때 장면이 어떻게 바뀔지까지 함께 그려 보는 모델입니다. 엔비디아는 이를 world-action model이라고 부릅니다. 11월 공개한 GR00T 2 (새 탭에서 열림)는 앞으로의 카메라 영상과 동작을 한 모델에서 같이 예측합니다. Physical Intelligence가 4월 공개한 π0.7 (새 탭에서 열림)도 가벼운 world model이 만든 목표 장면 이미지를 받아 그쪽으로 움직입니다.
로봇은 무엇으로 배울까요?
LLM에게는 인터넷이라는 거대한 글 더미가 있었습니다. 로봇에게는 그런 것이 없습니다. 로봇이 물건을 집고 옮기는 데이터는 누군가 실제로 로봇을 움직여야 생깁니다. 그래서 회사들은 데이터를 여러 갈래로 모읍니다.
- 원격 조종: 사람이 로봇을 직접 조종해 시범을 보입니다. 로봇 몸에 딱 맞는 데이터지만, 로봇과 사람이 함께 있어야 해서 비쌉니다.
- 손에 드는 집게: 로봇 집게 모양의 도구를 사람이 들고 일하며 기록합니다. 로봇 없이도 모을 수 있습니다.
- 사람 1인칭 영상: 일하는 사람의 머리 시점에서 찍은 영상입니다. 가장 많이 모을 수 있지만, 사람 손과 로봇 몸이 달라 옮겨 배우는 기술이 필요합니다.
- 시뮬레이션: 가상 공간에서 연습합니다. 실제와의 차이를 줄이는 것이 관건입니다.
GR00T 2의 학습 데이터를 보면 비중이 잘 드러납니다. 사람 1인칭 영상이 약 40만 시간, 원격 조종이 2만 3,500시간, 손에 드는 집게가 1만 시간 남짓입니다. 실제 데이터의 대부분이 사람 영상입니다. 엔비디아가 사람 영상을 전혀 쓰지 않았을 때와 모두 썼을 때를 비교하자, 실제 로봇 72개 작업의 평균 진척도가 50%에서 70%로 올랐습니다.
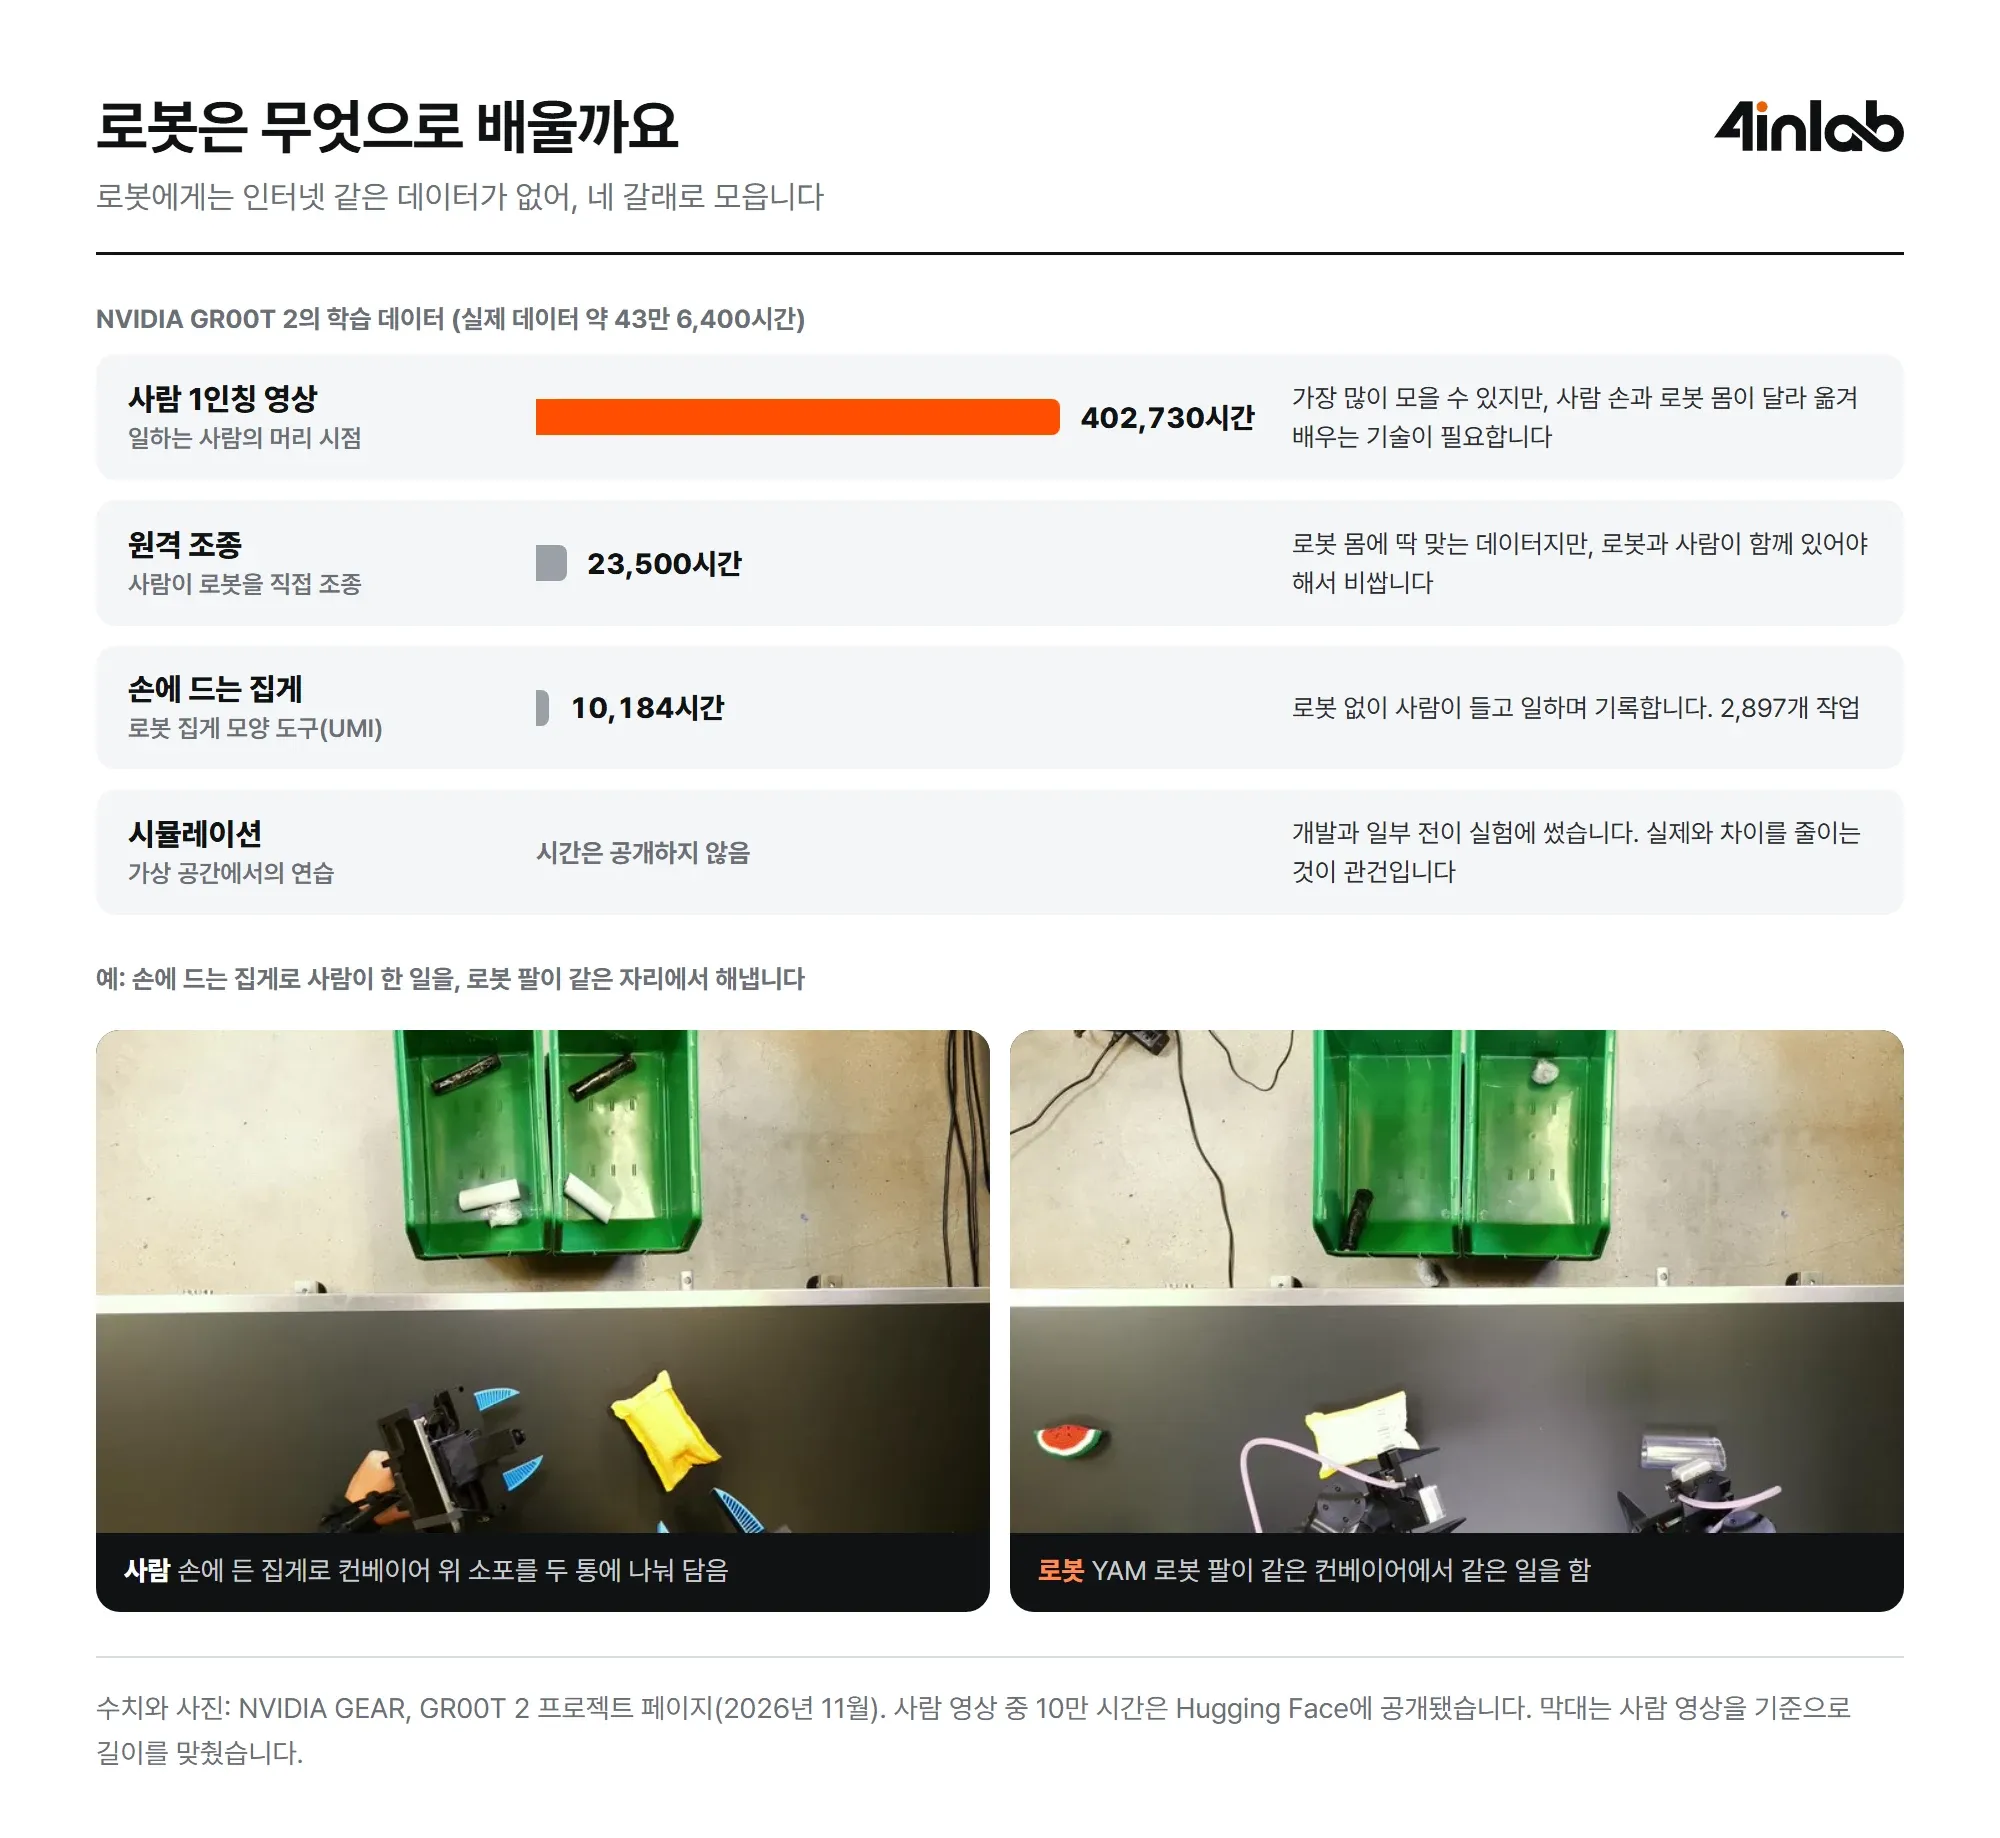
출처: NVIDIA GR00T 2 (새 탭에서 열림) 프로젝트 페이지의 데이터 수치와 사진
데이터를 늘리는 만큼 모델도 커져야 합니다. Generalist AI는 지난해 11월 실제 조작 데이터 27만 시간으로 학습한 GEN-0 (새 탭에서 열림)를 공개하며, 10억 파라미터 모델은 데이터를 늘려도 어느 순간 더 배우지 못했지만 70억 이상 모델은 계속 좋아졌다고 밝혔습니다. LLM에서 본 스케일링 법칙이 로봇에서도 나타나기 시작했다는 주장입니다. 이 회사는 지금도 매주 1만 시간 넘는 데이터를 새로 모은다고 합니다.
새 일은 얼마나 빨리 배울까요?
미리 많이 배워 둔 모델의 장점은 새 일을 배울 때 드러납니다. 엔비디아는 양손에 다섯 손가락 손을 단 로봇으로, GR00T 2가 처음 보는 작업 50개를 시험했습니다. 시연 없이 지시만 했을 때 평균 성공률은 40%, 작업마다 시연 하나를 보여 주면 71%, 다섯 개를 보여 주면 95%였습니다. 시연 다섯 개는 로봇 데이터로 3분이 채 안 되고, 모델을 맞추는 학습은 RTX 5090 그래픽카드 한 장에서 30분 걸렸습니다.
다른 회사들도 같은 방향입니다. 구글 딥마인드는 7월 Gemini Robotics 2 (새 탭에서 열림)를 내놓으며 새로운 양팔 로봇에 맞추는 데 몇 시간, 보통 예시 200개 미만이면 된다고 밝혔습니다. π0.7은 빨래 개기 데이터가 전혀 없는 로봇으로 티셔츠를 갰습니다. 다른 로봇에서 배운 것을 새 몸으로 옮긴 셈입니다.
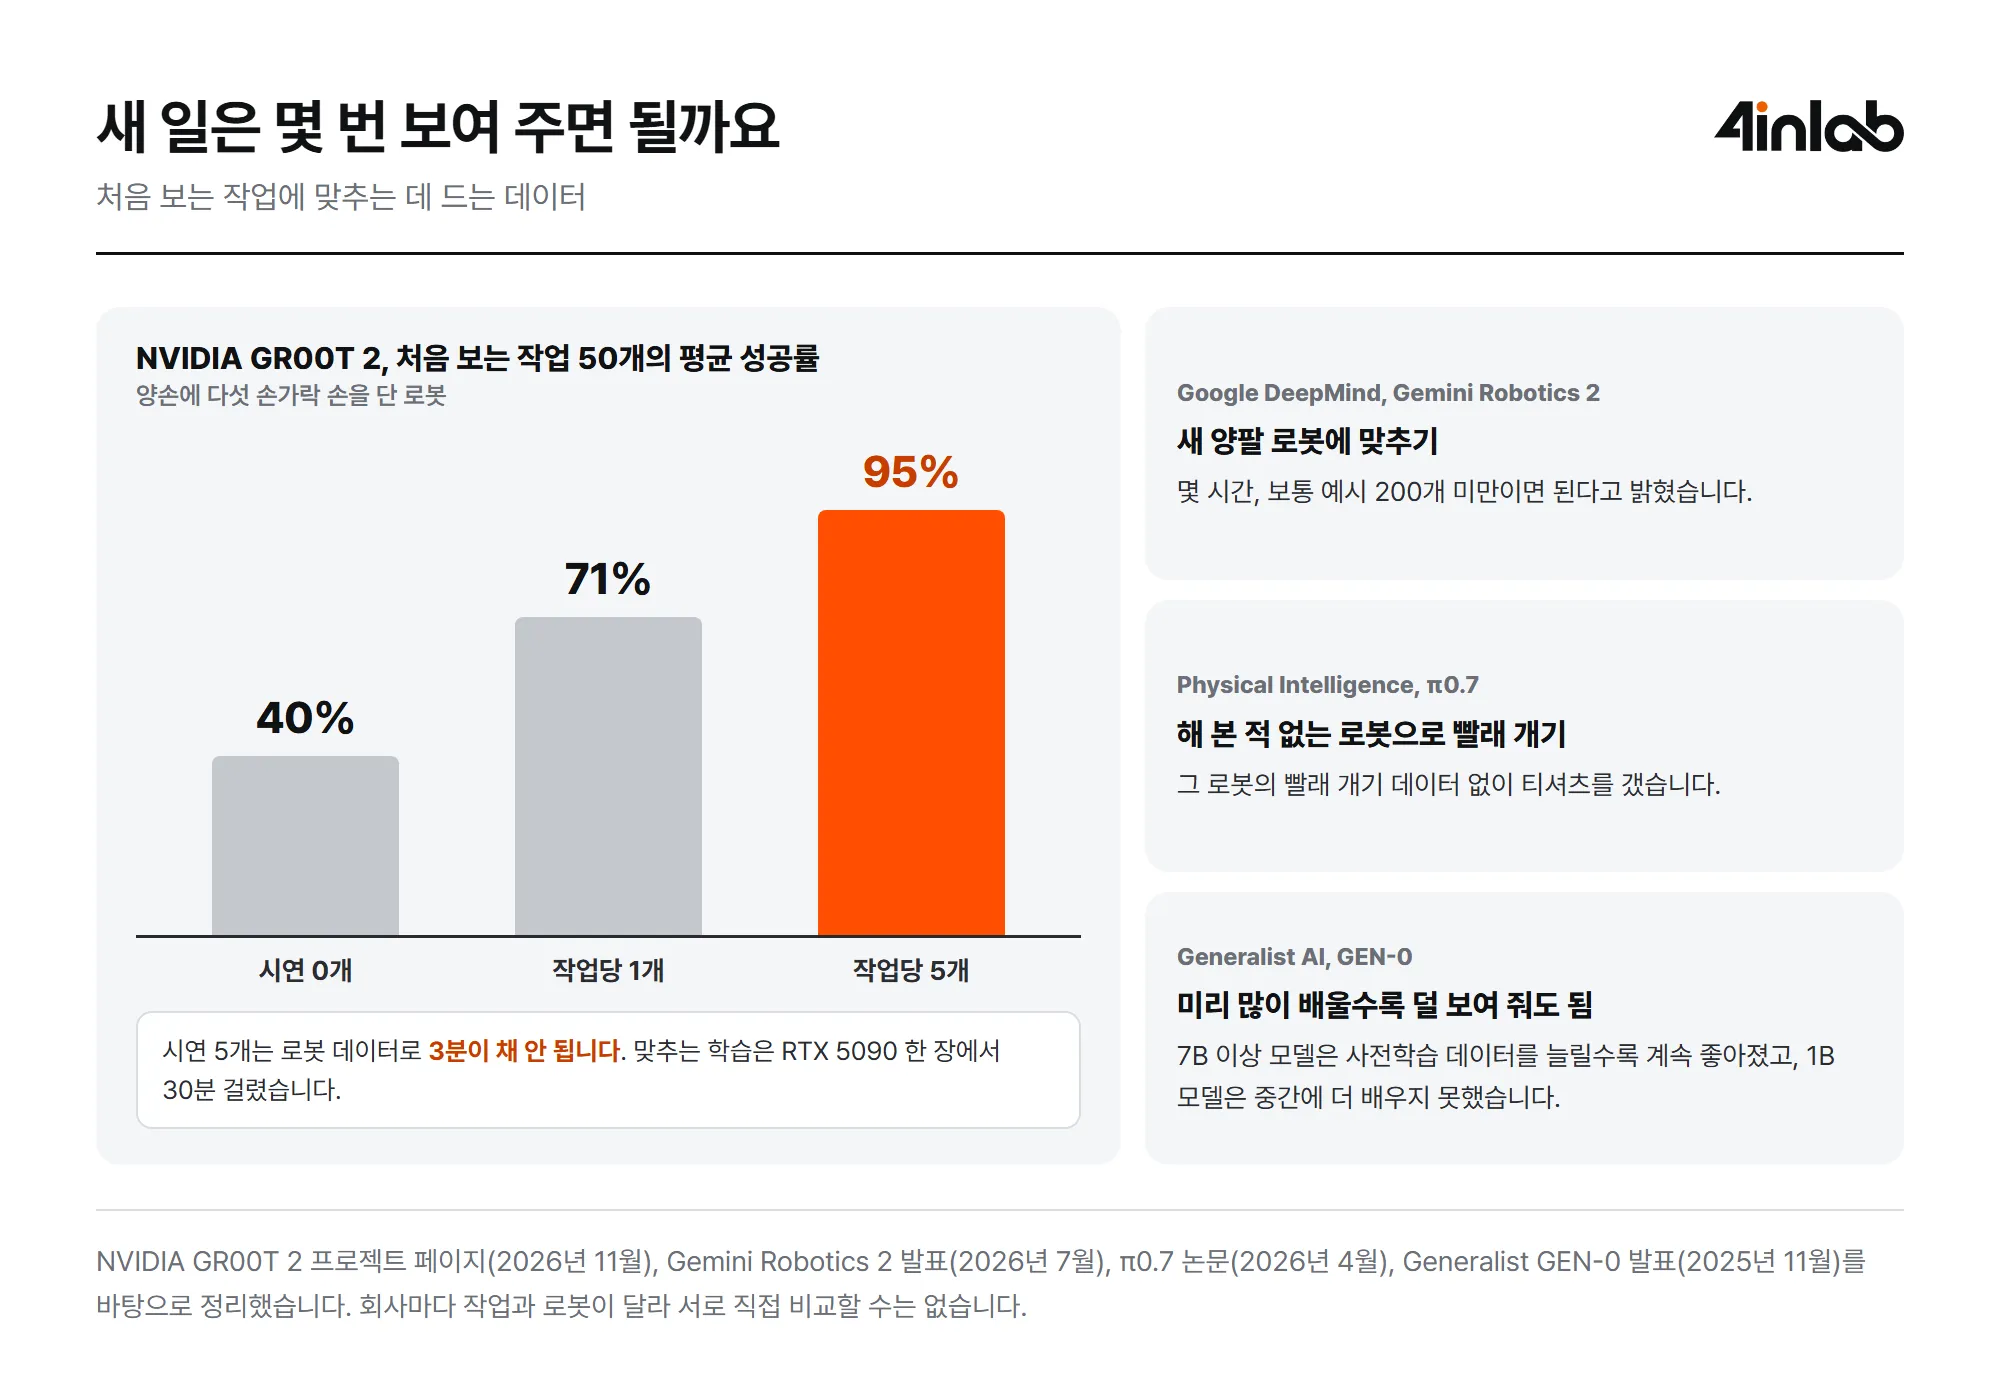
출처: NVIDIA GR00T 2 (새 탭에서 열림), Gemini Robotics 2 (새 탭에서 열림), π0.7 (새 탭에서 열림), GEN-0 (새 탭에서 열림)의 공개 수치를 정리
공장에서는 어디까지 왔을까요?
가장 현장에 가까운 결과는 11월 10일 나온 Gemini Robotics 2.5 (새 탭에서 열림)입니다. 구글 딥마인드는 메르세데스-벤츠의 헝가리 케치케메트, 독일 진델핑겐 공장 생산 라인에서 Apptronik의 휴머노이드 Apollo 2로 키팅 작업을 시험했습니다. 큰 통에 담긴 금속 브래킷을 차량마다 필요한 순서대로 트레이에 나눠 담는 일로, 성공률은 96%였습니다. 작업 흐름은 ER 모델이 따라가고, 팔과 손은 Gemini Robotics 2.5가 움직였습니다. 아직 개념 검증 단계입니다.
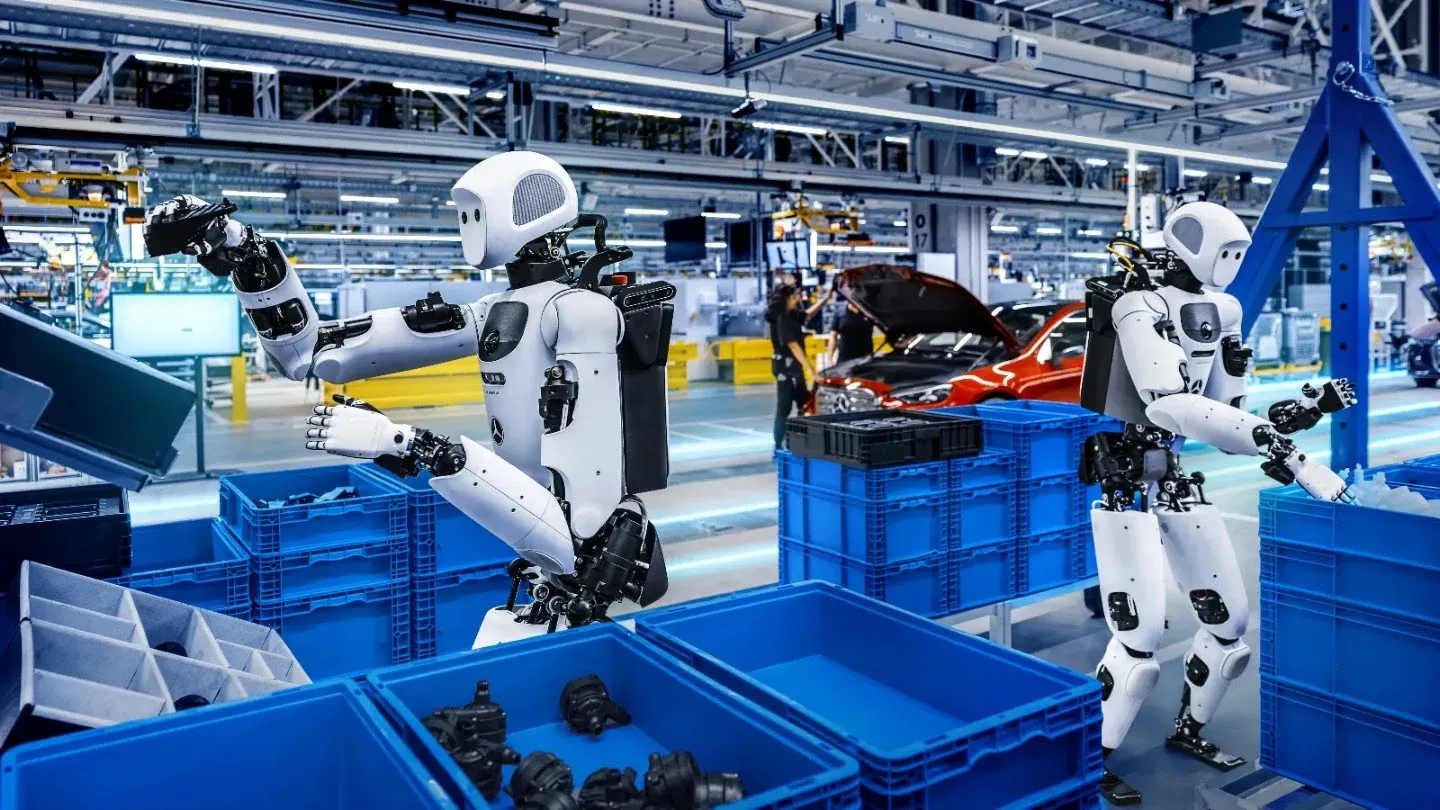
출처: Google DeepMind (새 탭에서 열림)
GR00T 2도 제조에 가까운 작업 결과를 냈습니다. 서버용 GB300 메모리 모듈을 슬롯에 끼우는 작업은 85% 성공했습니다. 실제 환경에서 강화학습을 더한 뒤에는 케이블 다섯 개를 꽂는 작업을 20번 중 19번, 충전기 다섯 개를 꽂는 작업을 20번 모두 해냈습니다. 강화학습 전에는 각각 12번, 2번이었습니다.
아직 어려운 것은 무엇일까요?
- 손재주: Gemini Robotics 2는 두 손가락 집게로 정밀하게 끼우는 일은 89.6% 해냈지만, 다섯 손가락 손으로 전구를 끼우는 일은 36%, 쓰레기봉투를 묶는 일은 44%였습니다. 딥마인드도 다섯 손가락 손재주는 아직 어렵다고 밝혔습니다.
- 긴 작업: GR00T 2로 움직인 다섯 손가락 로봇은 여러 단계로 된 긴 작업을 끝까지 마치는 경우가 드물었습니다. 보드를 분해하는 작업은 10번 중 3번 성공했습니다.
- 96%라는 숫자: 25번에 한 번은 실패한다는 뜻입니다. 생산 라인에 넣으려면 실패했을 때 누가 어떻게 이어받을지까지 함께 설계해야 합니다.
- 비교하기 어려운 숫자: 대부분 각 회사가 자기 로봇과 자기 작업으로 잰 값입니다. 작업도 로봇도 기준도 달라 회사끼리 직접 비교할 수 없고, 모두가 인정하는 공통 시험도 아직 없습니다.
- 써 볼 수 있는 범위: Gemini Robotics 2.5는 파트너에게만 열려 있고, GR00T 2 코드는 12월에 공개할 예정입니다. π0.7은 연구 모델입니다.
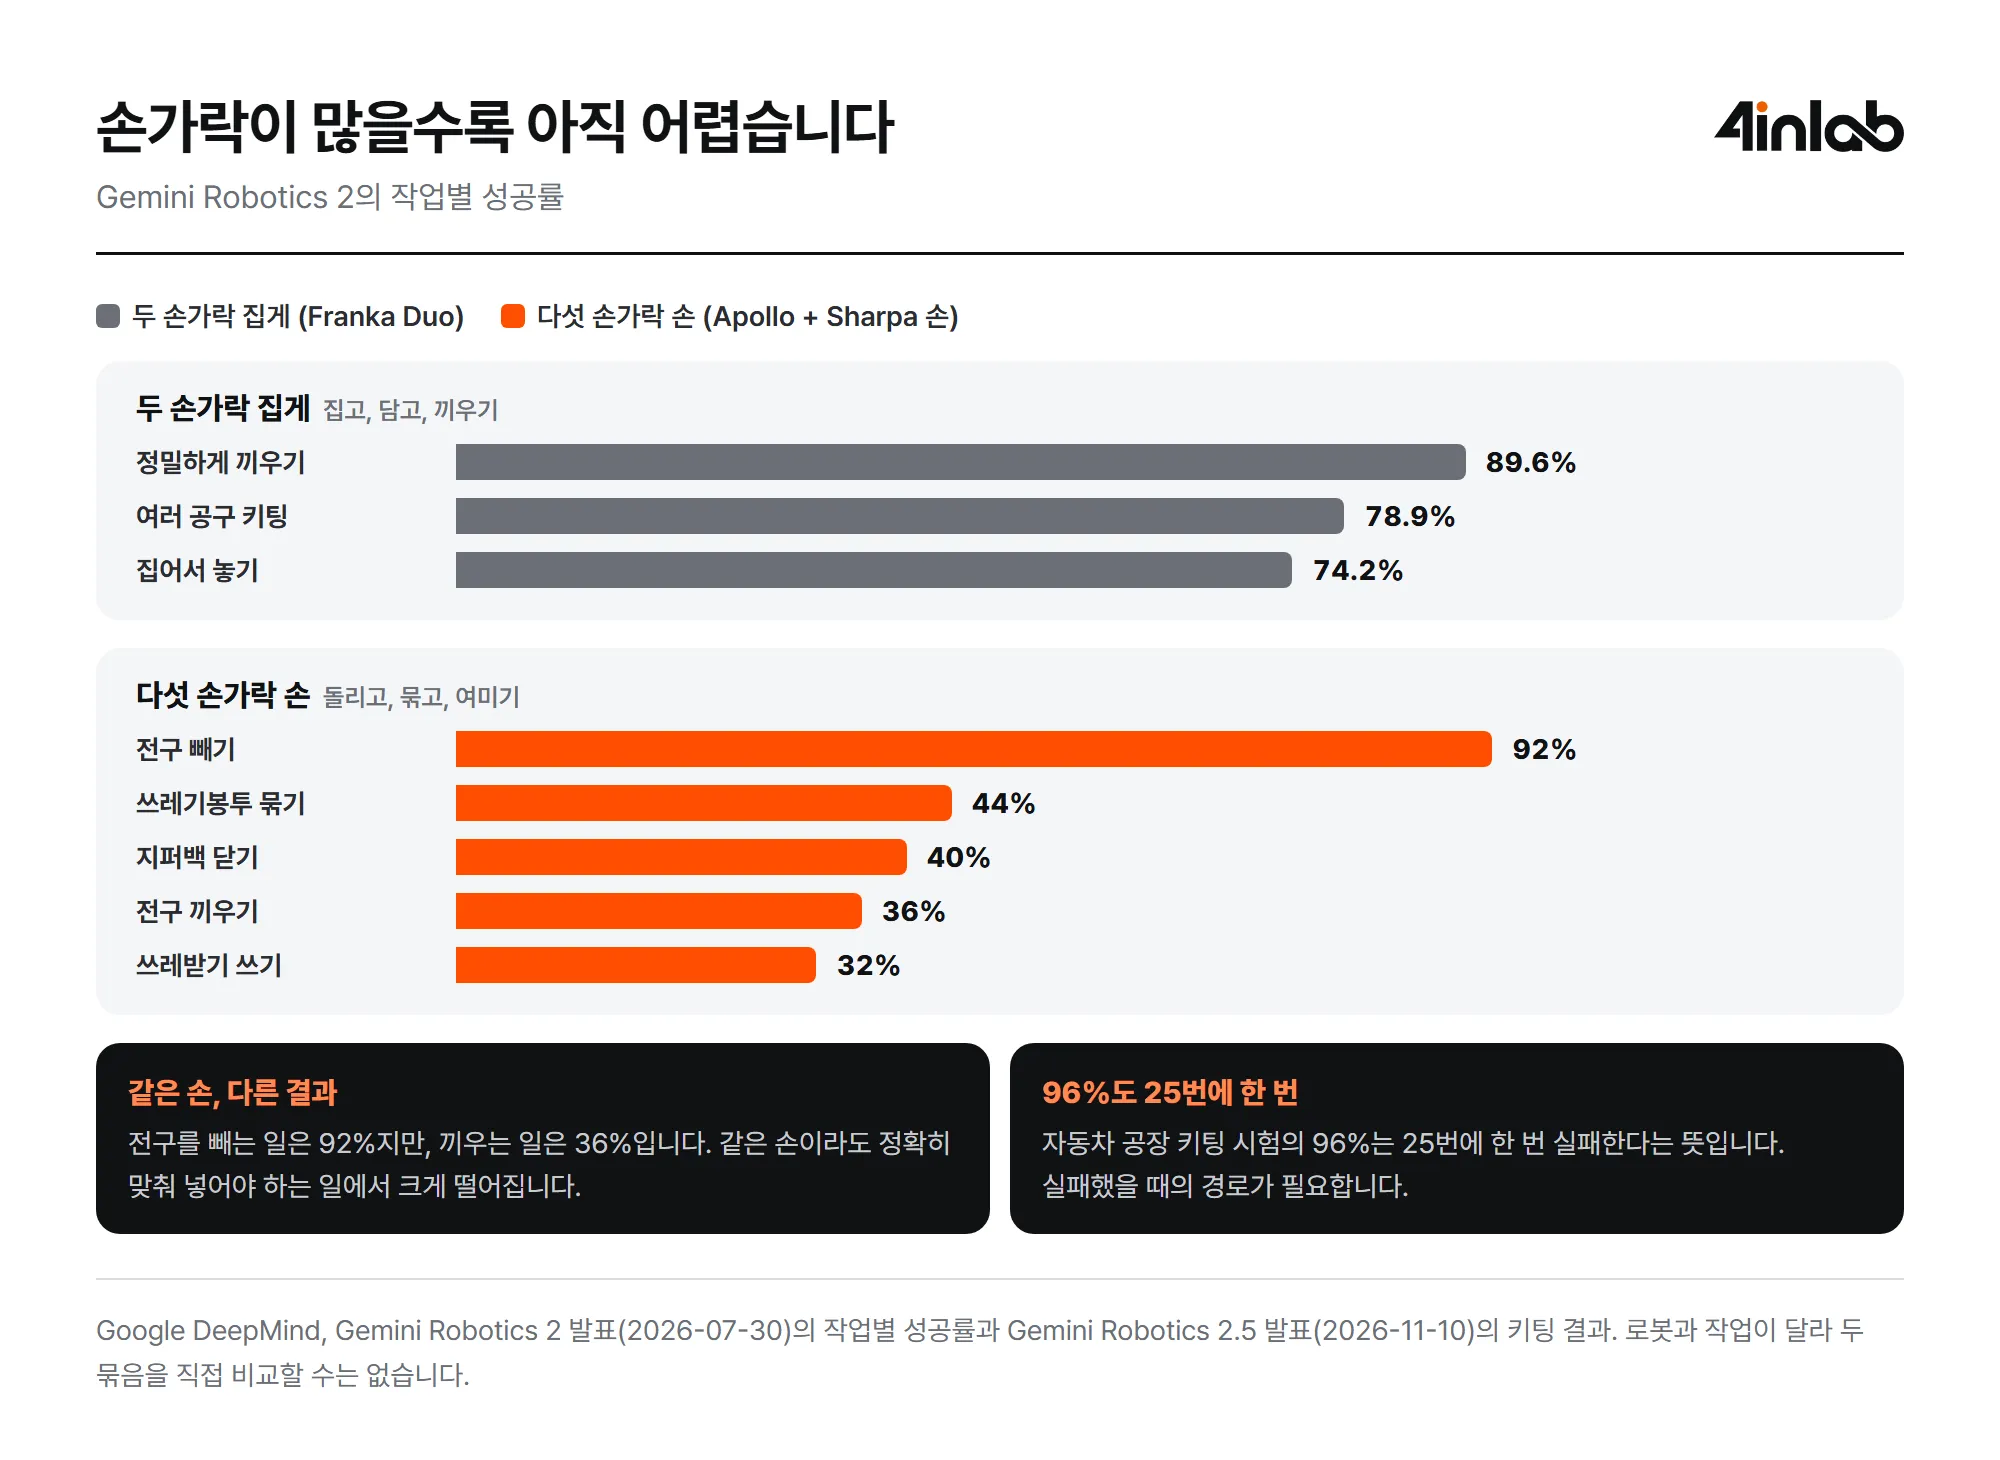
출처: Gemini Robotics 2 (새 탭에서 열림), Gemini Robotics 2.5 (새 탭에서 열림) 발표의 수치를 정리
우리 일에는 무엇이 달라질까요?
제조 현장의 로봇 일은 크게 두 가지로 나뉩니다. 같은 부품을 같은 자리에서 수없이 반복하는 일, 그리고 품종이 자주 바뀌거나 물체가 매번 조금씩 다른 일입니다. 앞의 일은 지금처럼 가르친 동작을 반복하는 로봇이 여전히 가장 낫습니다. 로봇 파운데이션 모델이 먼저 들어올 곳은 뒤의 일입니다. 부품을 골라 담는 키팅, 뒤섞인 통에서 꺼내기, 케이블 꽂기처럼 반복되지만 매번 조금씩 다른 작업입니다.
당장 모델을 들이지 않더라도 준비할 것은 있습니다.
- 우리 작업의 데이터를 쌓습니다. 작업자 시점 영상과 시연 기록처럼, 나중에 모델을 맞출 때 쓸 데이터를 모아 둡니다.
- 우리 작업으로 성공률을 잽니다. 발표된 숫자 대신, 우리 부품과 우리 라인에서 몇 번 중 몇 번 성공하는지를 기준으로 봅니다.
- 실패했을 때의 경로를 먼저 정합니다. 로봇이 놓치거나 멈췄을 때 사람이 이어받는 방법과 안전 정지를 함께 설계합니다.
- 반복되지만 조금씩 다른 일부터 봅니다. 정밀 조립이나 긴 공정보다, 실패해도 다시 시도할 수 있는 일이 먼저입니다.
로봇에 들어갈 AI는 동작을 외운 프로그램에서, 여러 일을 미리 배운 하나의 모델로 바뀌고 있습니다. 그 모델이 우리 라인에서 일하게 하려면, 우리 작업을 보여 줄 데이터부터 있어야 합니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
LLM이 하던 일, 누가 가져가고 있을까?
아마존은 사내 티켓 분류에서 LLM을 빼고 결정 모델을 넣었습니다. 호출 시간은 78%, 정가 기준 비용은 약 98% 줄었다고 합니다. 무엇을 바꿨고 어떻게 갈아탔는지 살펴보고, LLM이 하던 일이 어디로 옮겨 가고 있는지 짚어 봅니다.
AI 에이전트의 분석을 현장의 업무로 연결하려면
AI가 이상을 찾아낸 뒤에도 현장에는 확인하고 결정할 일이 남습니다. OpenBot 1.0을 사례로, 에이전트의 분석이 사람의 판단과 후속 업무로 이어지려면 무엇이 필요한지 살펴봅니다.