LLM이 하던 일, 누가 가져가고 있을까?
아마존 Strands Decider 사례로 본, 일에 맞는 모델 고르기
요즘 서비스 안에서 LLM은 거의 모든 일을 맡습니다. 글을 쓰고 요약하는 일뿐 아니라, 들어온 문의를 분류하고, 요청을 담당 팀에 보내고, 에이전트가 다음에 쓸 도구를 고르는 일까지요. 일단 LLM에 물어보면 웬만큼 답이 나오니, 일마다 모델을 따로 고를 이유가 없었던 셈입니다.
그런데 아마존에서 이 흐름과 반대 방향의 사례가 나왔습니다. 사내 티켓 시스템에서 Claude Sonnet 4.6이 하던 티켓 분류를, 글을 쓰지 못하는 작은 결정 모델로 바꾼 것입니다. AWS의 오픈소스 에이전트 프로젝트 Strands Agents 블로그에 올라온 사례 글 (새 탭에서 열림)에 따르면, 호출 시간은 78%, 정가 기준 비용은 약 98% 줄었습니다.
아마존이 무엇을 바꿨고 어떻게 갈아탔는지 살펴보고, LLM이 하던 일이 어디로 옮겨 가고 있는지 짚어 보겠습니다.
LLM에 맡긴 일은 정말 글쓰기일까요?
LLM에 맡긴 일을 하나씩 들여다보면, 결과로 필요한 것이 문장이 아닌 경우가 많습니다. 문의가 어느 범주인지, 요청을 어느 팀에 보낼지, 에이전트가 어떤 도구를 쓸지처럼 정해진 목록에서 하나를 고르는 일입니다.
LLM은 이런 고르기도 글로 합니다. 범주 설명이 담긴 긴 프롬프트를 읽고, {"category": ...} 같은 JSON을 한 글자씩 이어 씁니다. 그러면 코드가 그 JSON을 다시 읽어 범주를 꺼냅니다. 고르는 데 필요한 것보다 훨씬 많은 글을 읽고 쓰는 셈이고, 형식이 깨지거나 목록에 없는 답이 나오면 따로 처리해야 합니다.
결정 모델(decision model)은 이 고르기만 합니다. 상황과 보기를 받으면 글을 쓰지 않고, 보기마다 확률과 신뢰도를 매겨 돌려줍니다. 답은 언제나 주어진 보기 안에 있습니다. 결정 모델이 어떤 질문을 받고 확률을 어떻게 읽어야 하는지는 지난 Jev 글에서 자세히 다뤘습니다.
아마존이 쓴 Strands Decider (새 탭에서 열림)는 Strands Agents 팀이 10월에 공개한 오픈소스 결정 모델입니다. 만드는 방식은 단순합니다.
- LLM 몸통은 그대로 둡니다. 사전학습된 언어 모델이 글을 읽고 이해하는 부분을 가져옵니다.
- 글자를 고르는 머리를 떼어 냅니다. 다음 토큰을 고르는 출력층을 없애, 글을 쓸 수 없게 만듭니다.
- 보기 점수를 매기는 머리를 붙입니다. 보기마다 점수를 매기는 작은 출력층(약 100만 개 파라미터)을 붙여 학습합니다.
계산을 한 번 하면 답이 나오고, 글을 이어 쓰는 반복이 없습니다. 처음에는 Qwen3.5-2B를 바탕으로 한 2B 모델 (새 탭에서 열림)이 나왔고, 10월 중순 구글 Gemma 4를 바탕으로 한 네 가지 크기 (새 탭에서 열림)가 더해졌습니다.
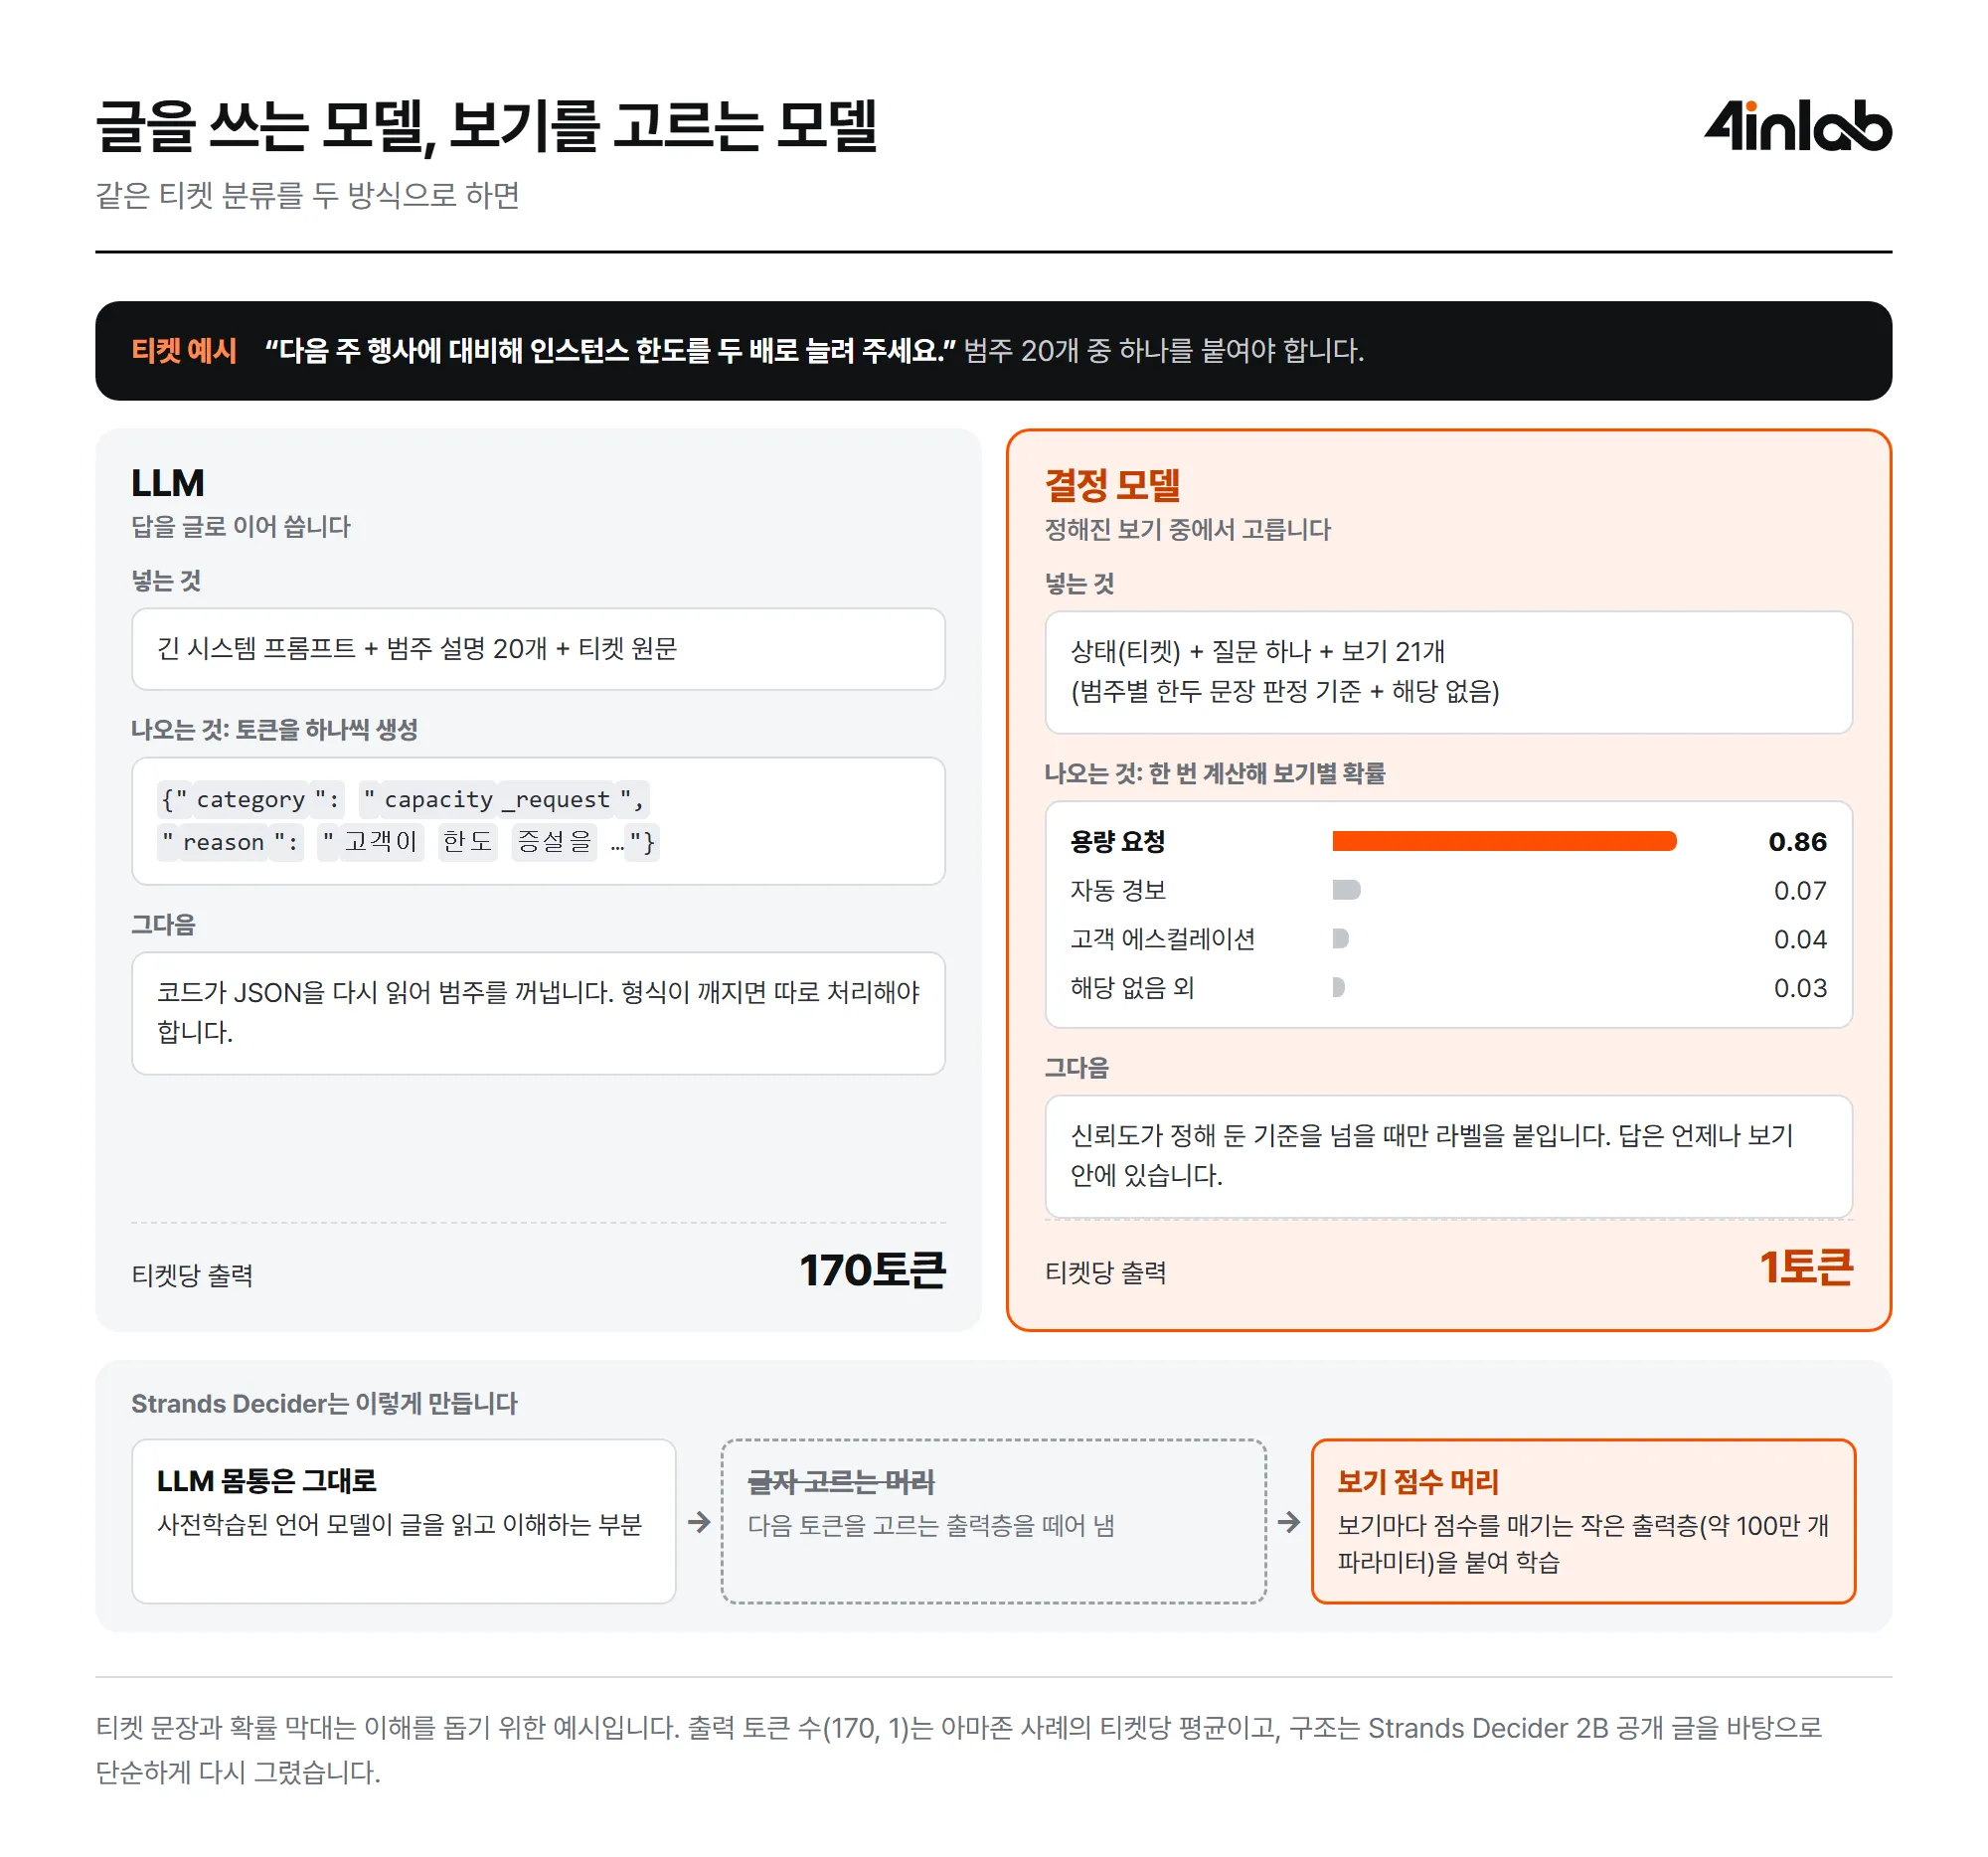
출처: Strands Agents (새 탭에서 열림) 블로그의 구조 설명과 아마존 사례의 토큰 수를 바탕으로 다시 그림
아마존은 무엇을 바꿨을까요?
아마존과 AWS 팀은 사내 티켓 시스템에서 Sonnet 4.6으로 티켓에 범주를 붙여 왔습니다. 고객 에스컬레이션, 용량 요청, 자동 경보, 보안 발견 사항 같은 20개 범주입니다. 티켓마다 긴 시스템 프롬프트를 읽히고, JSON으로 답을 받았습니다.
엔지니어 두 명이 이 일을 Strands Decider로 옮겼습니다. 처음에는 2B 모델로 시작했지만, 테스트용 티켓에서 Gemma 4 기반 E4B가 확실히 나은 결과를 냈습니다. 라벨을 붙이기 전에 필요한 신뢰도 기준을 조정한 뒤 별도의 티켓 묶음으로 다시 비교했고, E4B가 운영 중인 Sonnet보다 좋은 결과를 냈다고 합니다.
바꾼 것은 모델만이 아니었습니다.
- 범주 설명을 판정 기준으로 다시 썼습니다. 기존 범주 설명만으로도 Decider가 한 번에 읽는 4,096토큰을 넘었습니다. 그래서 범주마다 한두 문장으로 판단 기준을 적고, 보기에 '해당 없음'을 더했습니다.
- 긴 티켓은 오래된 댓글부터 뺐습니다. 정해진 길이 안에 티켓이 들어가도록 했습니다.
- 입력 순서를 고정했습니다. 티켓 JSON의 키 순서만 바꿔도 확률이 최대 0.19까지 움직였습니다. 지금은 키를 정렬해서 넣습니다.
아마존이 자기 티켓으로 모델을 다시 학습시켰다는 언급은 없습니다. 글에 나온 작업은 질문과 보기를 다듬고 신뢰도 기준을 맞추는 일이었습니다.
어떻게 멈추지 않고 갈아탔을까요?
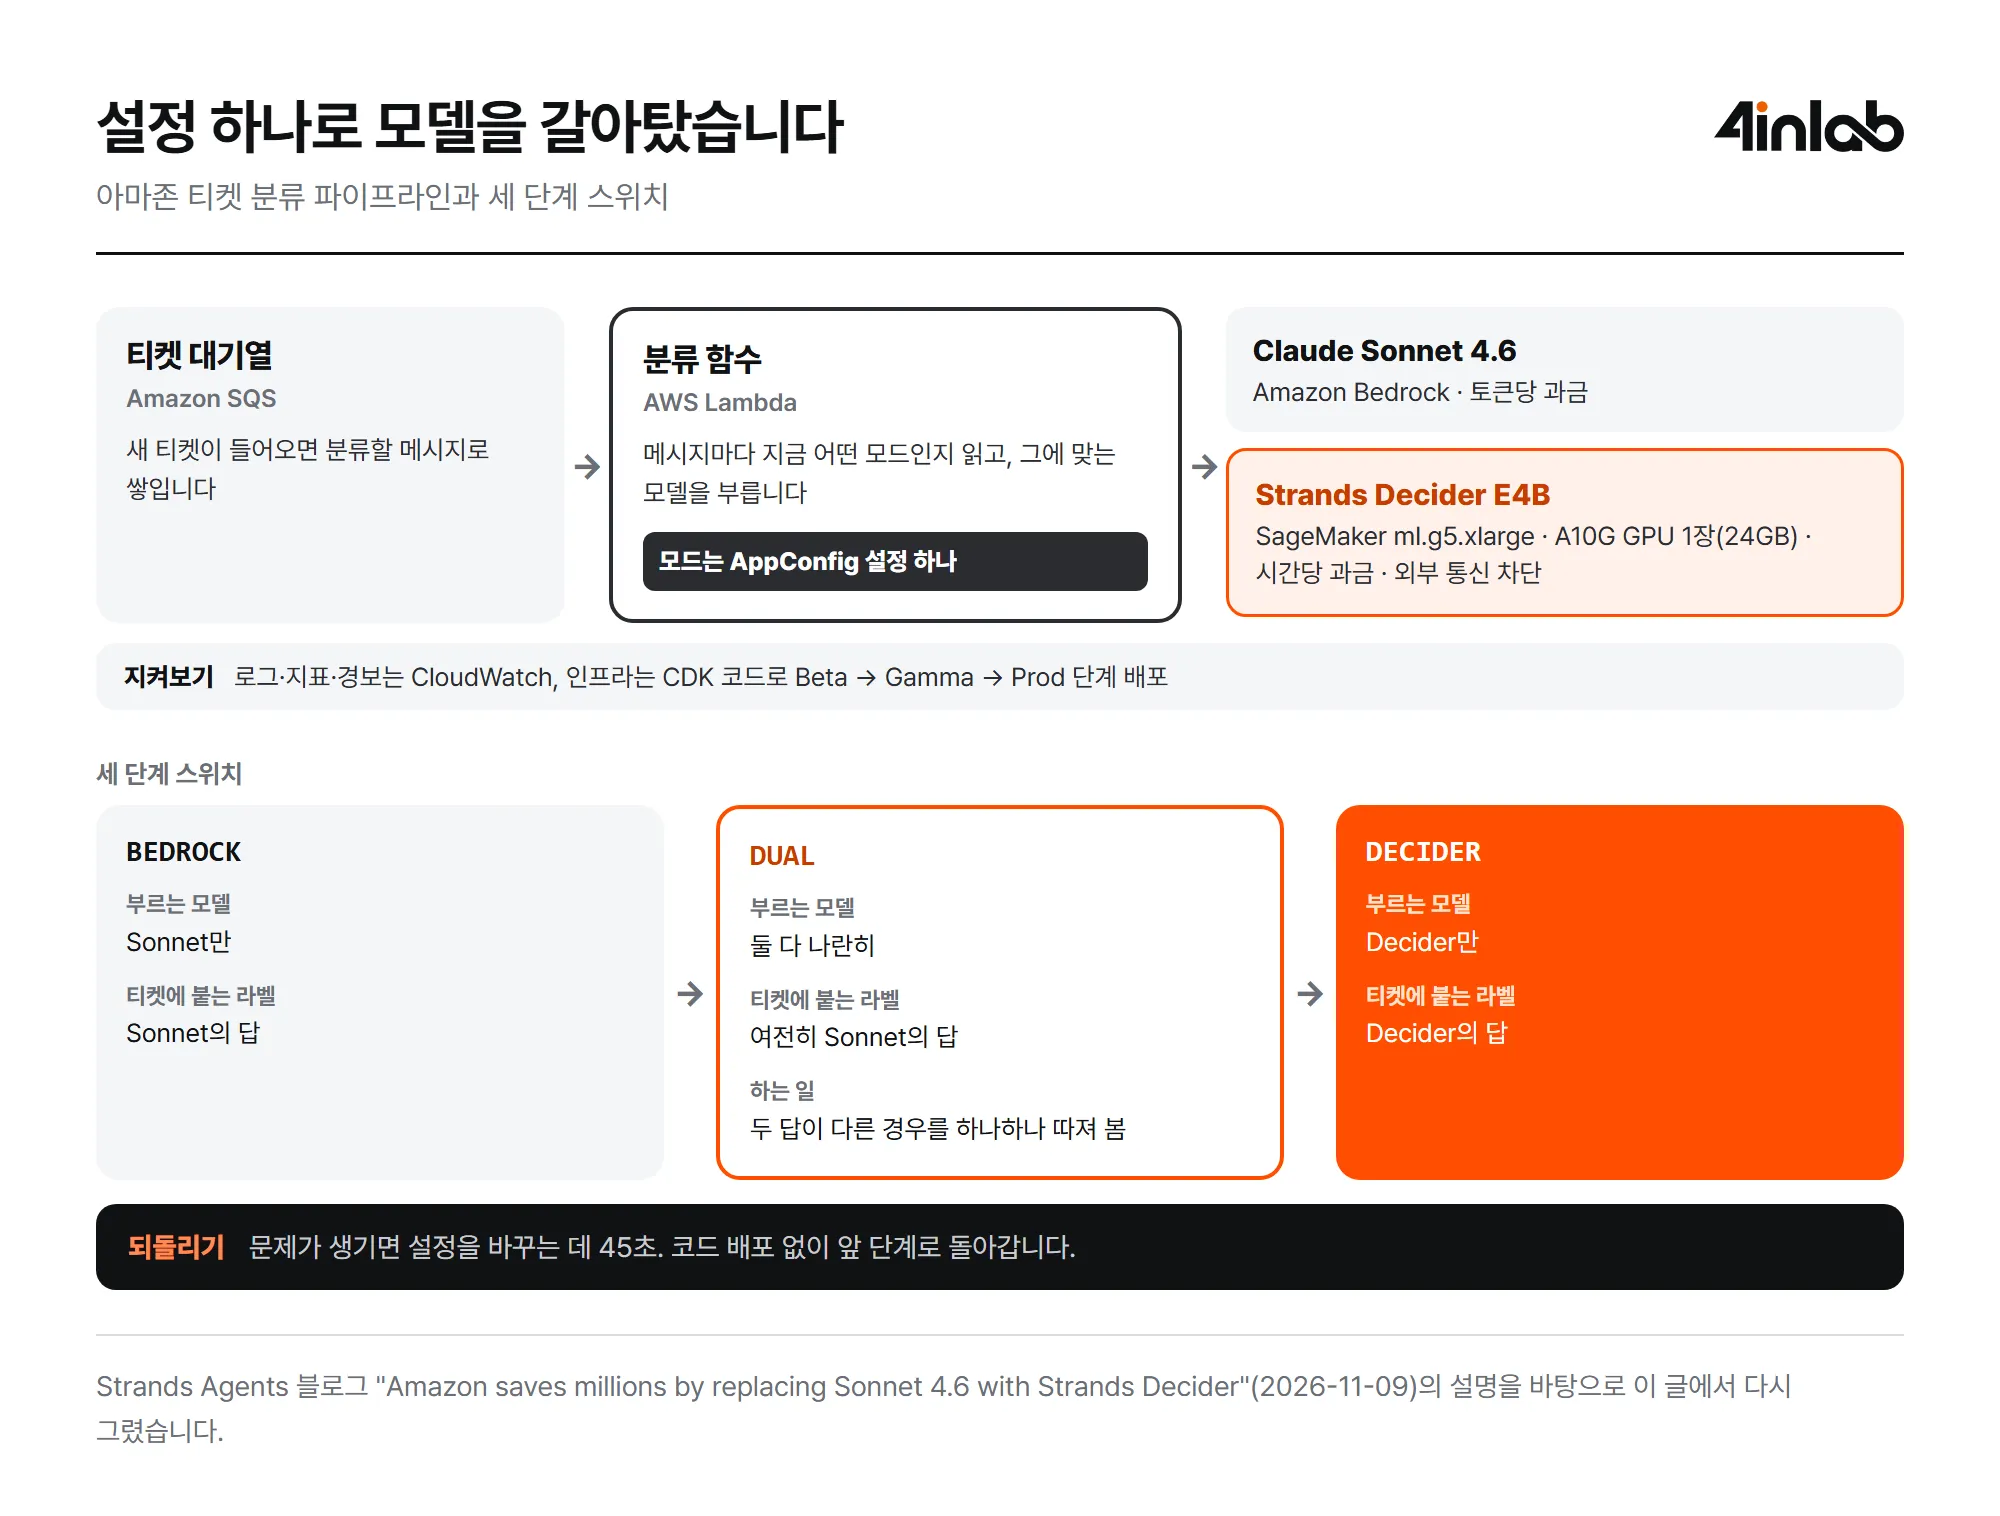
티켓 분류는 쉬지 않고 돌아가는 일입니다. 모델을 바꾸는 동안에도 티켓은 계속 들어옵니다. 아마존은 이 문제를 설정 하나로 풀었습니다.
새 티켓은 대기열(Amazon SQS)에 쌓이고, 분류 함수(AWS Lambda)가 메시지를 하나씩 꺼내 모델을 부릅니다. 이때 함수는 메시지마다 AppConfig에 적힌 모드를 읽고, 모드에 따라 부를 모델을 정합니다. Decider E4B는 SageMaker의 GPU 인스턴스(ml.g5.xlarge, A10G 1장, 24GB)에서 돌고, 외부 통신은 막혀 있습니다. 모델은 약 19GiB이고, 요청 하나에 약 640ms가 걸립니다.
모드는 세 가지입니다.
- BEDROCK: Sonnet만 부릅니다.
- DUAL: 두 모델을 나란히 부르되, 티켓에는 여전히 Sonnet의 답을 붙입니다. 그리고 두 답이 다른 경우를 하나하나 따져 봤습니다.
- DECIDER: Decider만 부릅니다.
문제가 생기면 설정을 바꿔 앞 단계로 돌아가는 데 45초면 됐다고 합니다. 원문은 이 스위치를 두고, 어떤 모델을 쓰든 따라 할 만한 부분이라고 강조합니다.
출처: Strands Agents (새 탭에서 열림) 블로그의 설명을 바탕으로 다시 그림
얼마나 달라졌을까요?
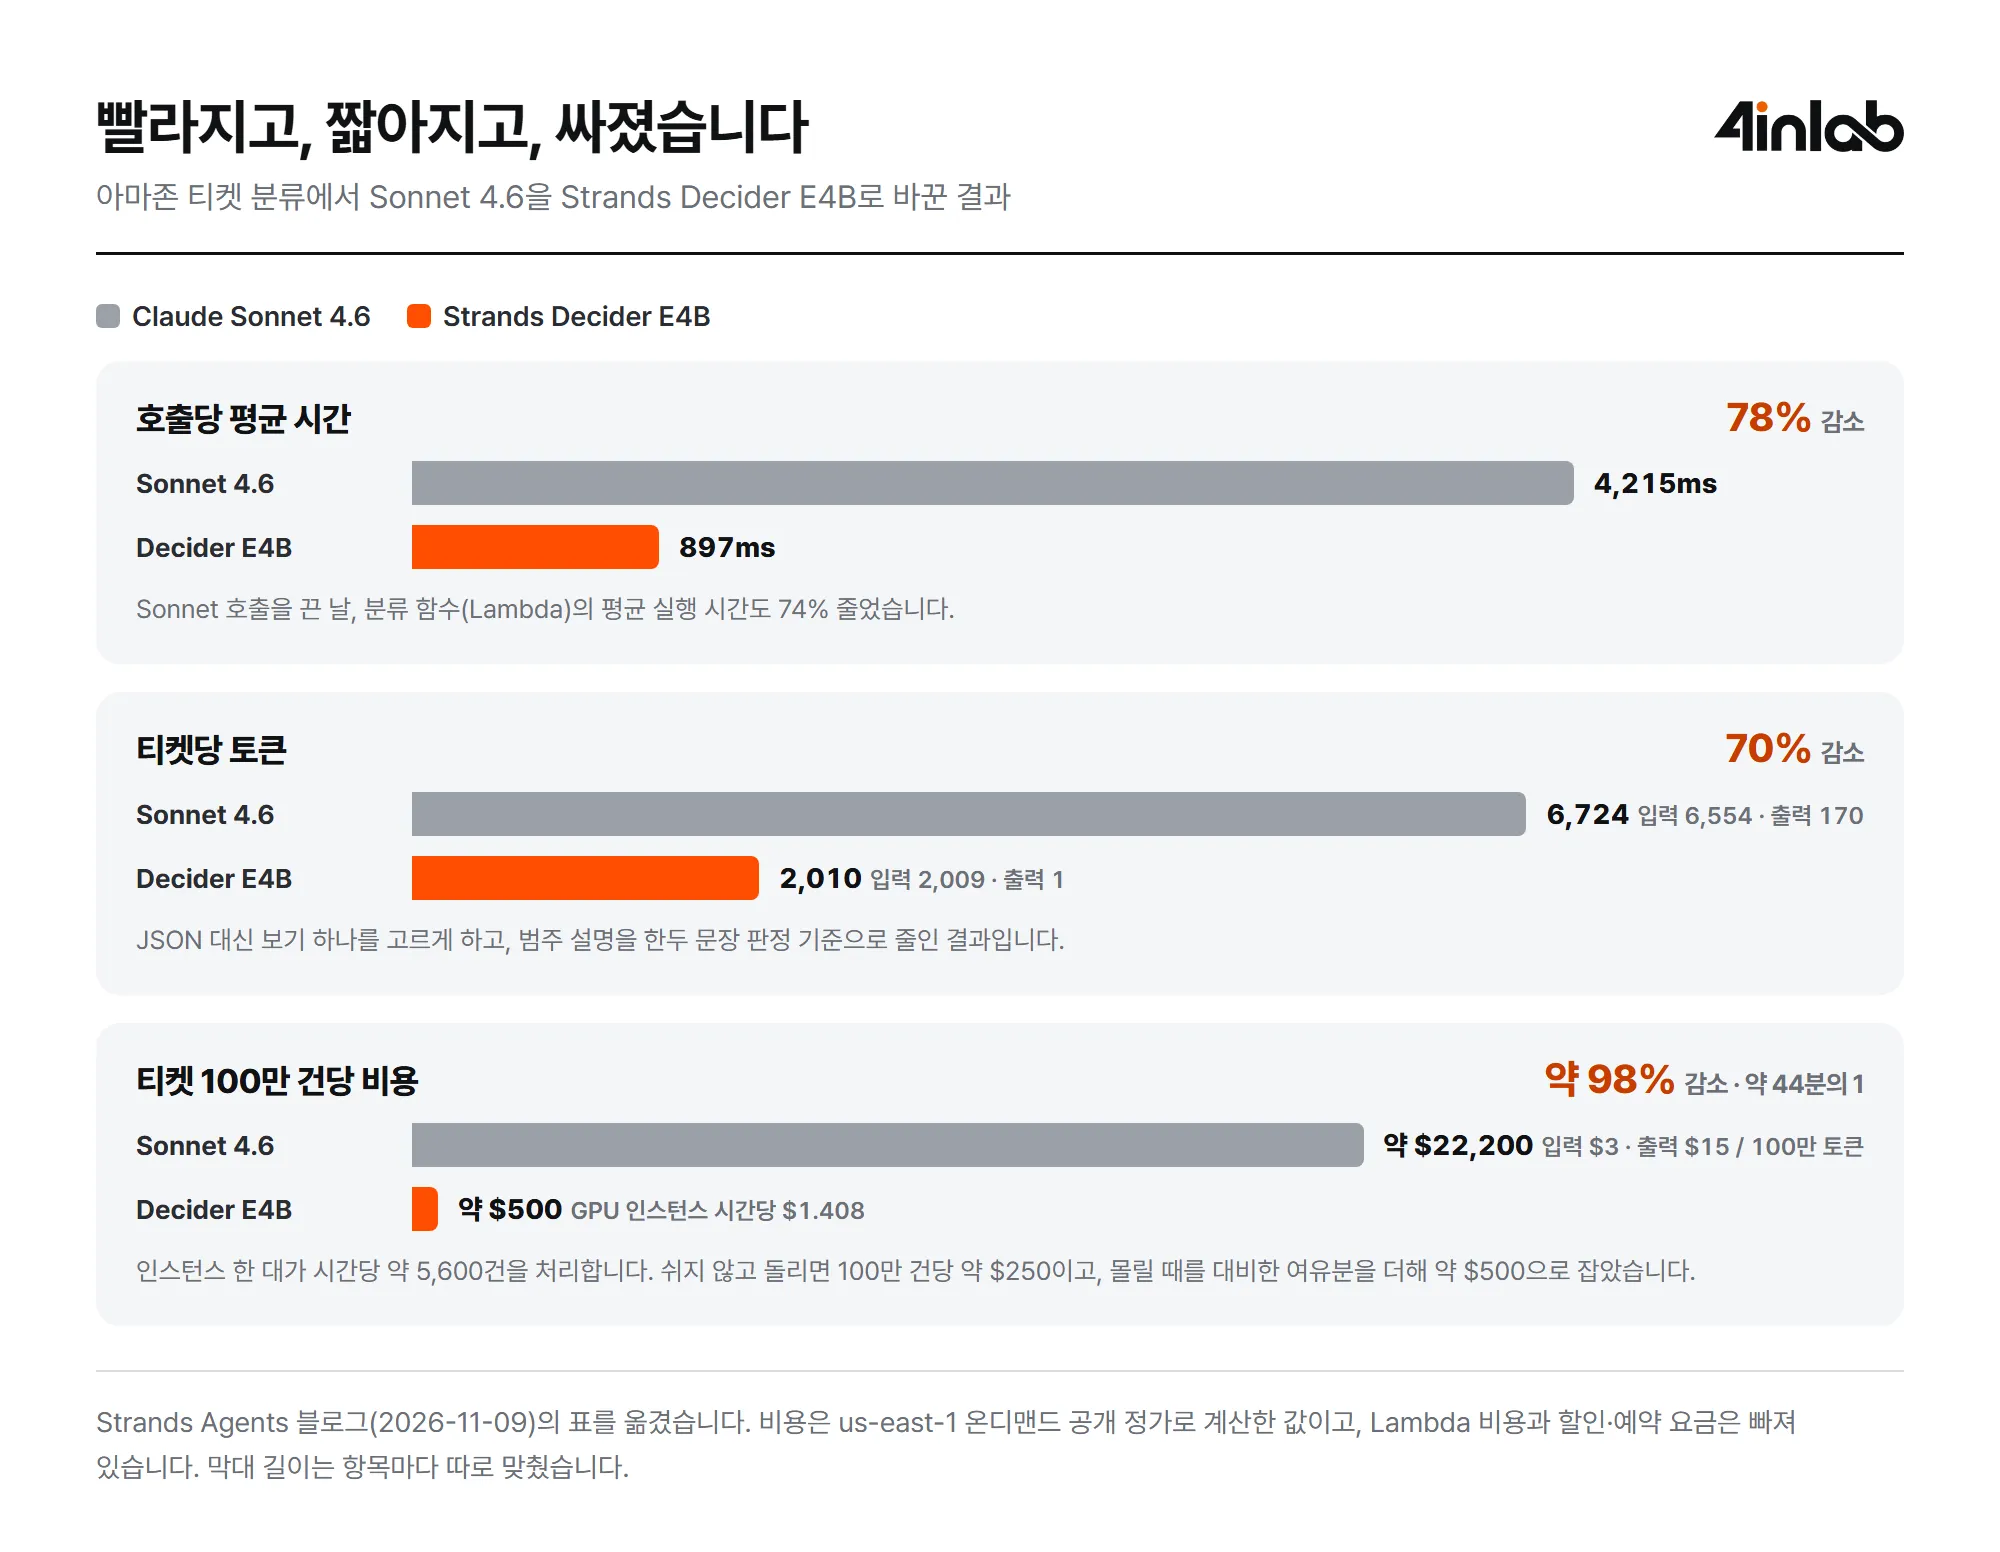
원문이 공개한 숫자는 세 가지입니다.
- 시간: 호출 한 번에 평균 4,215ms 걸리던 것이 897ms로 78% 줄었습니다. Sonnet 호출을 끈 날, 분류 함수의 평균 실행 시간도 74% 줄었습니다.
- 토큰: 티켓 하나에 쓰는 토큰이 6,724개에서 2,010개로 70% 줄었습니다. 출력은 170개에서 1개가 됐습니다. JSON 대신 보기 하나를 고르게 하고, 범주 설명을 판정 기준으로 줄인 결과입니다.
- 비용: 공개 정가로 계산하면 티켓 하나에 약 0.0222달러이던 비용이 약 0.0005달러가 됐습니다. 티켓 100만 건으로 치면 약 2만 2,200달러에서 약 500달러, 44분의 1 수준입니다.
비용 계산 방식은 조금 다릅니다. Sonnet은 토큰 수만큼 돈을 내고, Decider는 GPU 인스턴스를 켜 둔 시간만큼 냅니다. 인스턴스 한 대는 시간당 약 5,600건을 처리하니, 쉬지 않고 돌리면 100만 건에 약 250달러입니다. 원문은 티켓이 몰릴 때를 대비한 여유분을 더해 약 500달러로 잡았습니다. 그리고 이 교체로 1년에 수백만 달러의 토큰 비용을 아낄 것이라고 밝혔습니다.
출처: Strands Agents (새 탭에서 열림) 블로그의 표를 옮겨 그림. 비용은 us-east-1 온디맨드 공개 정가 기준
왜 이런 모델 교체가 늘어날까요?
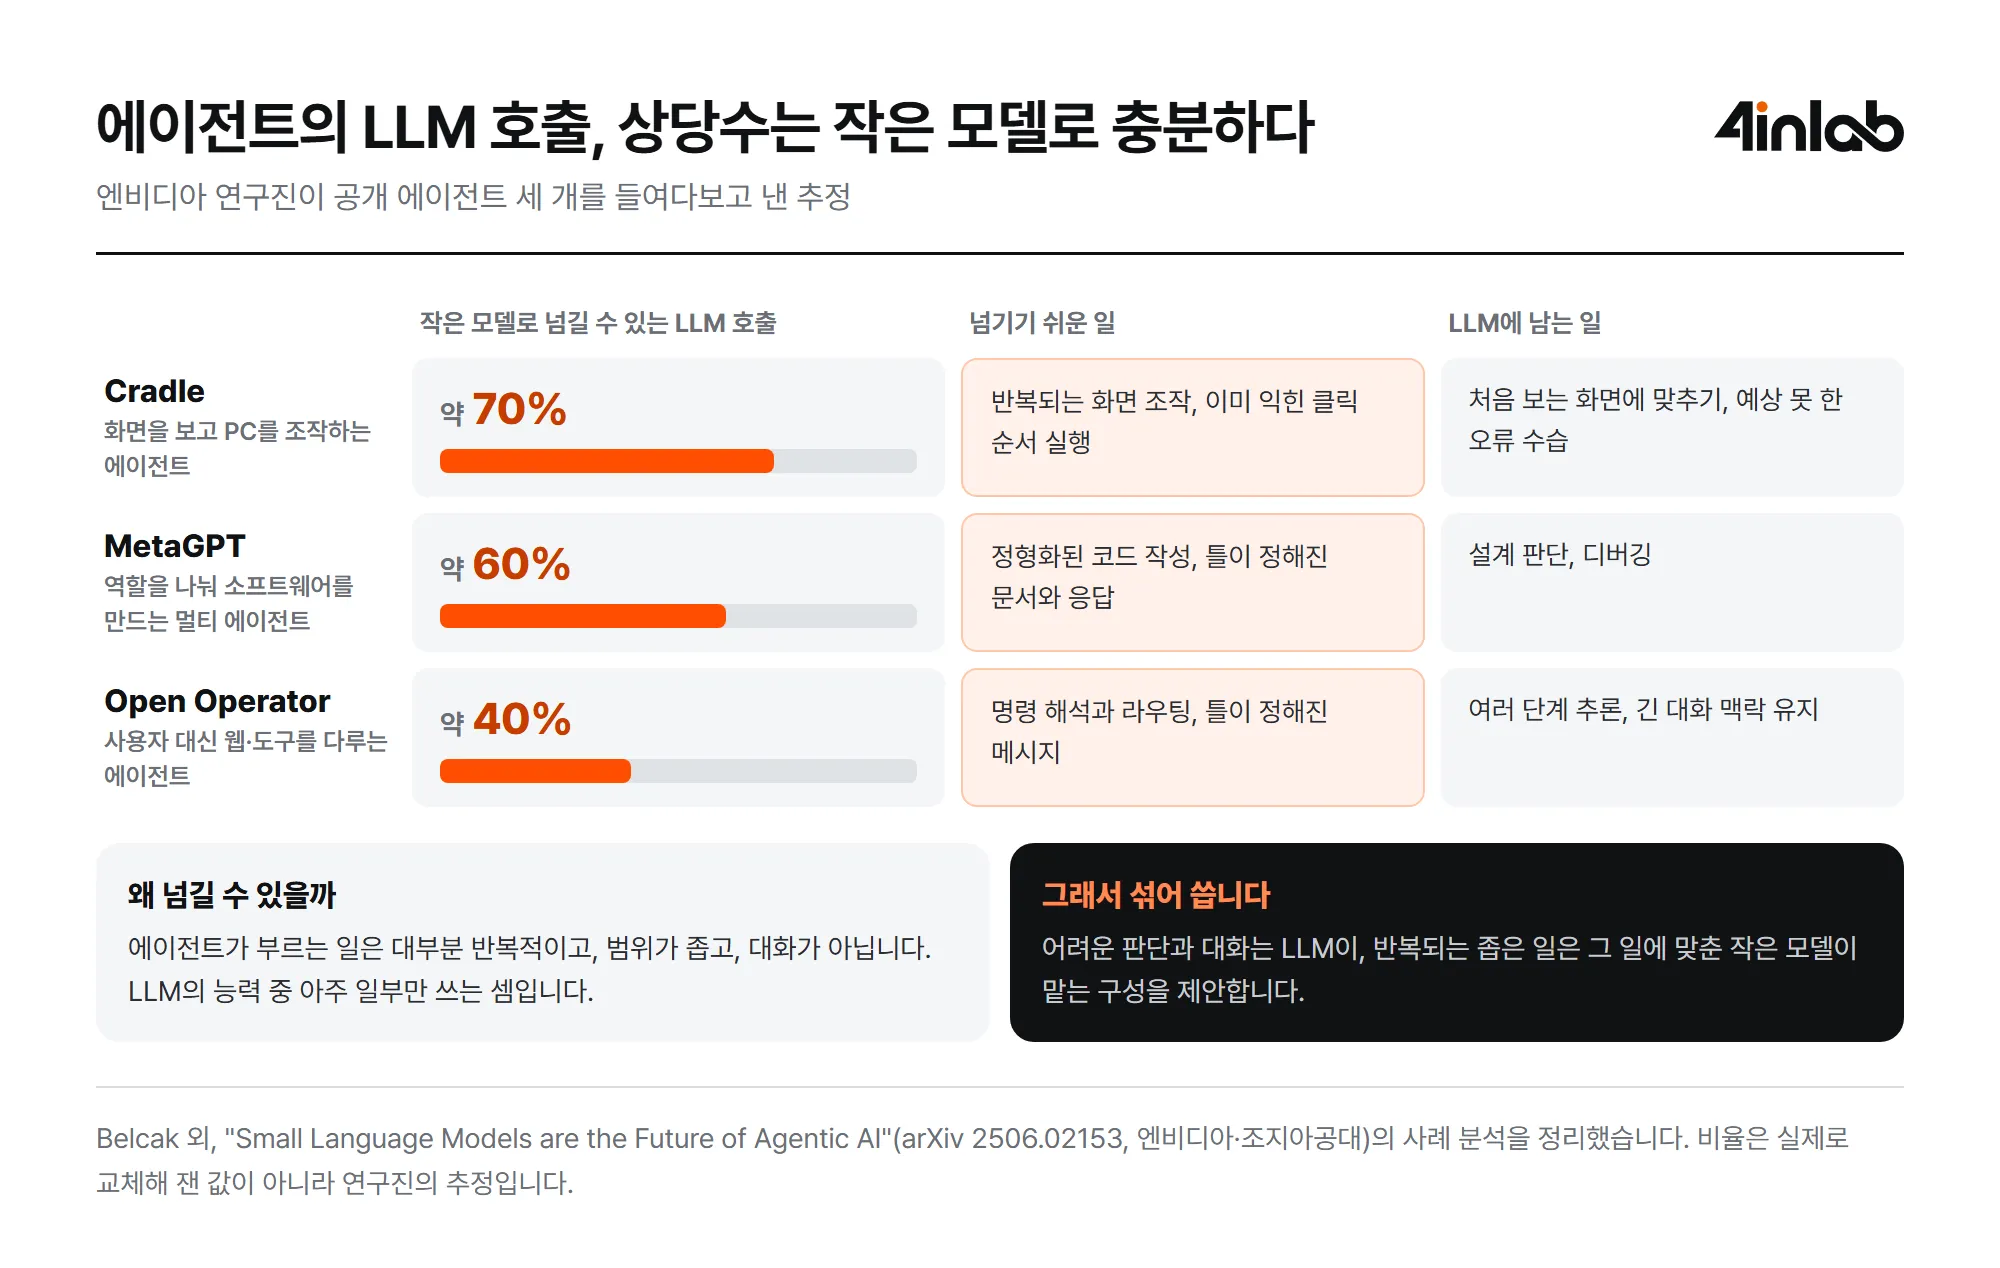
아마존만의 이야기는 아닙니다. 엔비디아 연구진은 2025년 입장 논문 (새 탭에서 열림)에서, 에이전트가 부르는 LLM 호출의 상당수는 작은 언어 모델로 충분하다고 주장했습니다. 에이전트가 맡기는 일은 대부분 반복적이고, 범위가 좁고, 대화가 아니라는 것입니다. 공개 에이전트 세 개를 들여다보고는 LLM 호출의 40~70%를 작은 모델로 넘길 수 있다고 추정했습니다. 그리고 어려운 판단과 대화는 LLM이, 반복되는 좁은 일은 그 일에 맞춘 작은 모델이 맡는 구성을 제안했습니다.
출처: Belcak 외, Small Language Models are the Future of Agentic AI (새 탭에서 열림)의 사례 분석을 정리해 그림
올해 가을에는 이 생각이 실제 모델로 쏟아져 나왔습니다. 9월 TypeSafe의 Jev를 시작으로 스탠퍼드·엔비디아 연구진의 CLM-8B (새 탭에서 열림), OpenAI의 Decisions API (새 탭에서 열림), vLLM 프로젝트의 d3 (새 탭에서 열림), 그리고 Strands Decider까지 한 달 사이에 결정 모델이 잇달아 나왔습니다. The Batch (새 탭에서 열림)도 이 흐름을 '한 가지 일을 잘하도록 만든 모델'이라는 제목으로 다루며, Jev를 따라 나온 모델들을 함께 소개했습니다.
고르기만의 이야기도 아닙니다. 정형 데이터로 예측하는 일에는 그 데이터를 위해 만든 정형 데이터 파운데이션 모델이 나오고 있습니다. LLM이 하던 일을 그 일만 잘하는 모델들이 하나씩 나눠 가져가는 그림입니다.
이 소식에 달린 댓글 중에는, 6년 전 SVM으로 비슷한 티켓 분류기를 만들었다며 LLM을 거쳐 다시 가벼운 모델로 돌아오는 흐름이 흥미롭다는 이야기도 있었습니다. 다만 같은 자리로 돌아온 것은 아닙니다. 예전 분류기는 범주마다 학습 데이터를 모아 따로 학습해야 했지만, 결정 모델은 LLM 몸통의 이해력을 그대로 쓰기 때문에 판정 기준 문장과 보기만으로 고릅니다. 아마존도 범주 설명을 다시 썼을 뿐, 분류기를 새로 학습시키지 않았습니다.
어디까지 믿고 볼 수 있을까요?
- 정확도 숫자가 없습니다. 평가에 쓴 티켓이 몇 건인지, 두 모델의 답이 얼마나 일치했는지, 'Sonnet보다 낫다'를 무엇으로 쟀는지 공개하지 않았습니다. 신뢰도 기준에 못 미친 티켓을 어떻게 처리했는지도 나오지 않습니다.
- 절감액의 근거가 없습니다. 전체 티켓 수를 밝히지 않아, '1년에 수백만 달러'는 확인할 수 없는 주장입니다. 비용은 정가로 계산했고, 분류 함수 비용과 할인·예약 요금은 빠져 있습니다.
- 다른 선택지와는 비교하지 않았습니다. 더 작고 싼 LLM이나, 같은 LLM을 더 싸게 쓰는 방법과 견줘 봤는지는 나오지 않습니다. 댓글에서도 왜 더 작은 Claude 모델은 써 보지 않았냐는 질문이 나왔습니다.
- 같은 회사의 사례입니다. AWS 팀이 AWS가 공개한 모델을 쓰고, 그 결과를 AWS 프로젝트 블로그에 올렸습니다.
- 모든 일에 통하지는 않습니다. 원문도 이 방식이 통한 조건으로 정해진 목록에서 고르는 일, 많은 처리량, 빠른 응답이 중요한 상황을 꼽습니다. 범주에 긴 설명이 필요하거나, 목록이 매주 바뀌거나, 판단에 필요한 맥락을 수천 토큰 안에 담을 수 없다면 결정 모델이 LLM을 대신하기 어렵다고 덧붙였습니다.
우리 일에는 무엇이 달라질까요?
제조 현장에도 고르는 일이 많습니다. 설비 알람이 어떤 유형인지, 불량이 어느 유형인지, 현장 요청을 어느 팀에 보낼지, 들어온 문서가 작업 지시서인지 검사 성적서인지 정하는 일입니다. 에이전트가 다음에 어떤 도구를 쓸지 정하는 것도 마찬가지입니다. 이런 일까지 모두 LLM에 맡기고 있다면, 아마존 사례에서 가져올 것이 있습니다.
- 먼저 일을 쪼갭니다. LLM에 한꺼번에 맡긴 일 중에서 정해진 목록에서 고르는 판단을 따로 떼어 봅니다.
- 범주 이름 대신 판정 기준을 씁니다. 보기마다 어떤 경우에 해당하는지 한두 문장으로 적고, 어디에도 맞지 않는 경우를 위한 보기를 둡니다.
- 나란히 돌려 보고 바꿉니다. 기존 모델과 새 모델을 함께 돌려 답이 다른 경우를 살피고, 설정 하나로 되돌릴 수 있게 만듭니다.
- 확신이 낮으면 넘깁니다. 신뢰도가 기준에 못 미치는 판단은 LLM이나 사람이 보게 합니다.
- 모델은 일마다 고릅니다. 고르는 일은 결정 모델, 정형 데이터 예측은 정형 데이터 모델, 긴 글과 어려운 판단은 LLM에 맡기는 식입니다.
LLM이 하던 일 가운데 상당수는 처음부터 글쓰기가 아니라 고르기였습니다. 그 일을 알아보는 데서 다음 모델 선택이 시작됩니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
LLM도 잠을 자야 한다고요?
배포된 LLM은 새로 배운 것을 오래 간직하지 못합니다. 다시 학습하면 예전 것을 잊고, 문맥에만 두면 세션이 끝날 때 사라집니다. 구글 리서치가 내놓은 Sleep 프레임워크가 이 문제를 어떻게 풀려 하는지 살펴봅니다.
말 잘하는 AI 말고, 선택하는 AI라고요?
Jev는 정해진 질문에 선택·점수·확률을 반환합니다. 검색 결과와 문서를 고르고 에이전트의 다음 행동을 정할 때, 코드가 검증하고 실행할 판단을 어떻게 분리할 수 있을지 살펴봅니다.
보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.