데이터도 이제 학습 없이 예측한다고요?
정형 데이터 파운데이션 모델이 무엇인지부터, 엔비디아 Kumo Tabular까지
공장과 회사의 데이터는 대부분 행과 열로 정리된 정형 데이터입니다. 공정 조건과 검사 결과, 주문과 고객 정보가 테이블에 쌓입니다. 이 데이터로 불량이 날지, 고객이 떠날지를 예측하는 일은 오랫동안 XGBoost, LightGBM 같은 그래디언트 부스팅 모델의 몫이었습니다. 문제가 생길 때마다 데이터를 모으고, 피처를 만들고, 모델을 학습하고 튜닝했습니다.
그런데 엔비디아가 9월에 공개한 Kumo Tabular (새 탭에서 열림)는 이 순서를 건너뜁니다. 정답이 붙은 행을 보여 주면 학습 없이 새 행의 답을 바로 냅니다. 그리고 정형 데이터 예측 방법을 겨루는 TabArena (새 탭에서 열림) 리더보드에서, 하이퍼파라미터를 튜닝하고 여러 모델을 묶은 그래디언트 부스팅보다 높은 점수를 받았습니다.
학습 없이 예측한다는 게 어떻게 가능할까요? 이런 모델이 무엇인지부터 짚어 보겠습니다.
정형 데이터 파운데이션 모델은 무엇일까요?
파운데이션 모델은 아주 많은 데이터로 한 번 크게 학습해 두고, 여러 문제에 그대로 가져다 쓰는 모델입니다. ChatGPT나 Claude 같은 LLM이 대표적입니다. 정형 데이터 파운데이션 모델은 이 방식을 테이블 데이터에 옮긴 것입니다. 영어로는 tabular foundation model이라고 부르고, Kumo Tabular라는 이름도 여기서 왔습니다.
핵심은 문맥 학습(in-context learning)입니다. LLM에게 "사과는 apple, 포도는 grape, 배는?"이라고 물으면, 모델을 다시 학습하지 않아도 예시를 보고 pear라고 답합니다. 정형 데이터 파운데이션 모델도 같습니다. 정답이 붙은 행들을 문맥으로 넣고 정답 칸이 빈 행을 함께 넣으면, 모델이 예시에서 규칙을 읽어 빈칸을 채웁니다.
기존 방식과 나란히 놓으면 차이가 분명합니다. 그래디언트 부스팅은 문제마다 모델을 새로 학습합니다. 불량 예측 모델과 고객 이탈 예측 모델은 서로 다른 모델이고, 데이터가 바뀌면 다시 학습하고 튜닝합니다. 정형 데이터 파운데이션 모델은 모델이 하나입니다. 문제가 바뀌면 넣는 예시만 바꿉니다.
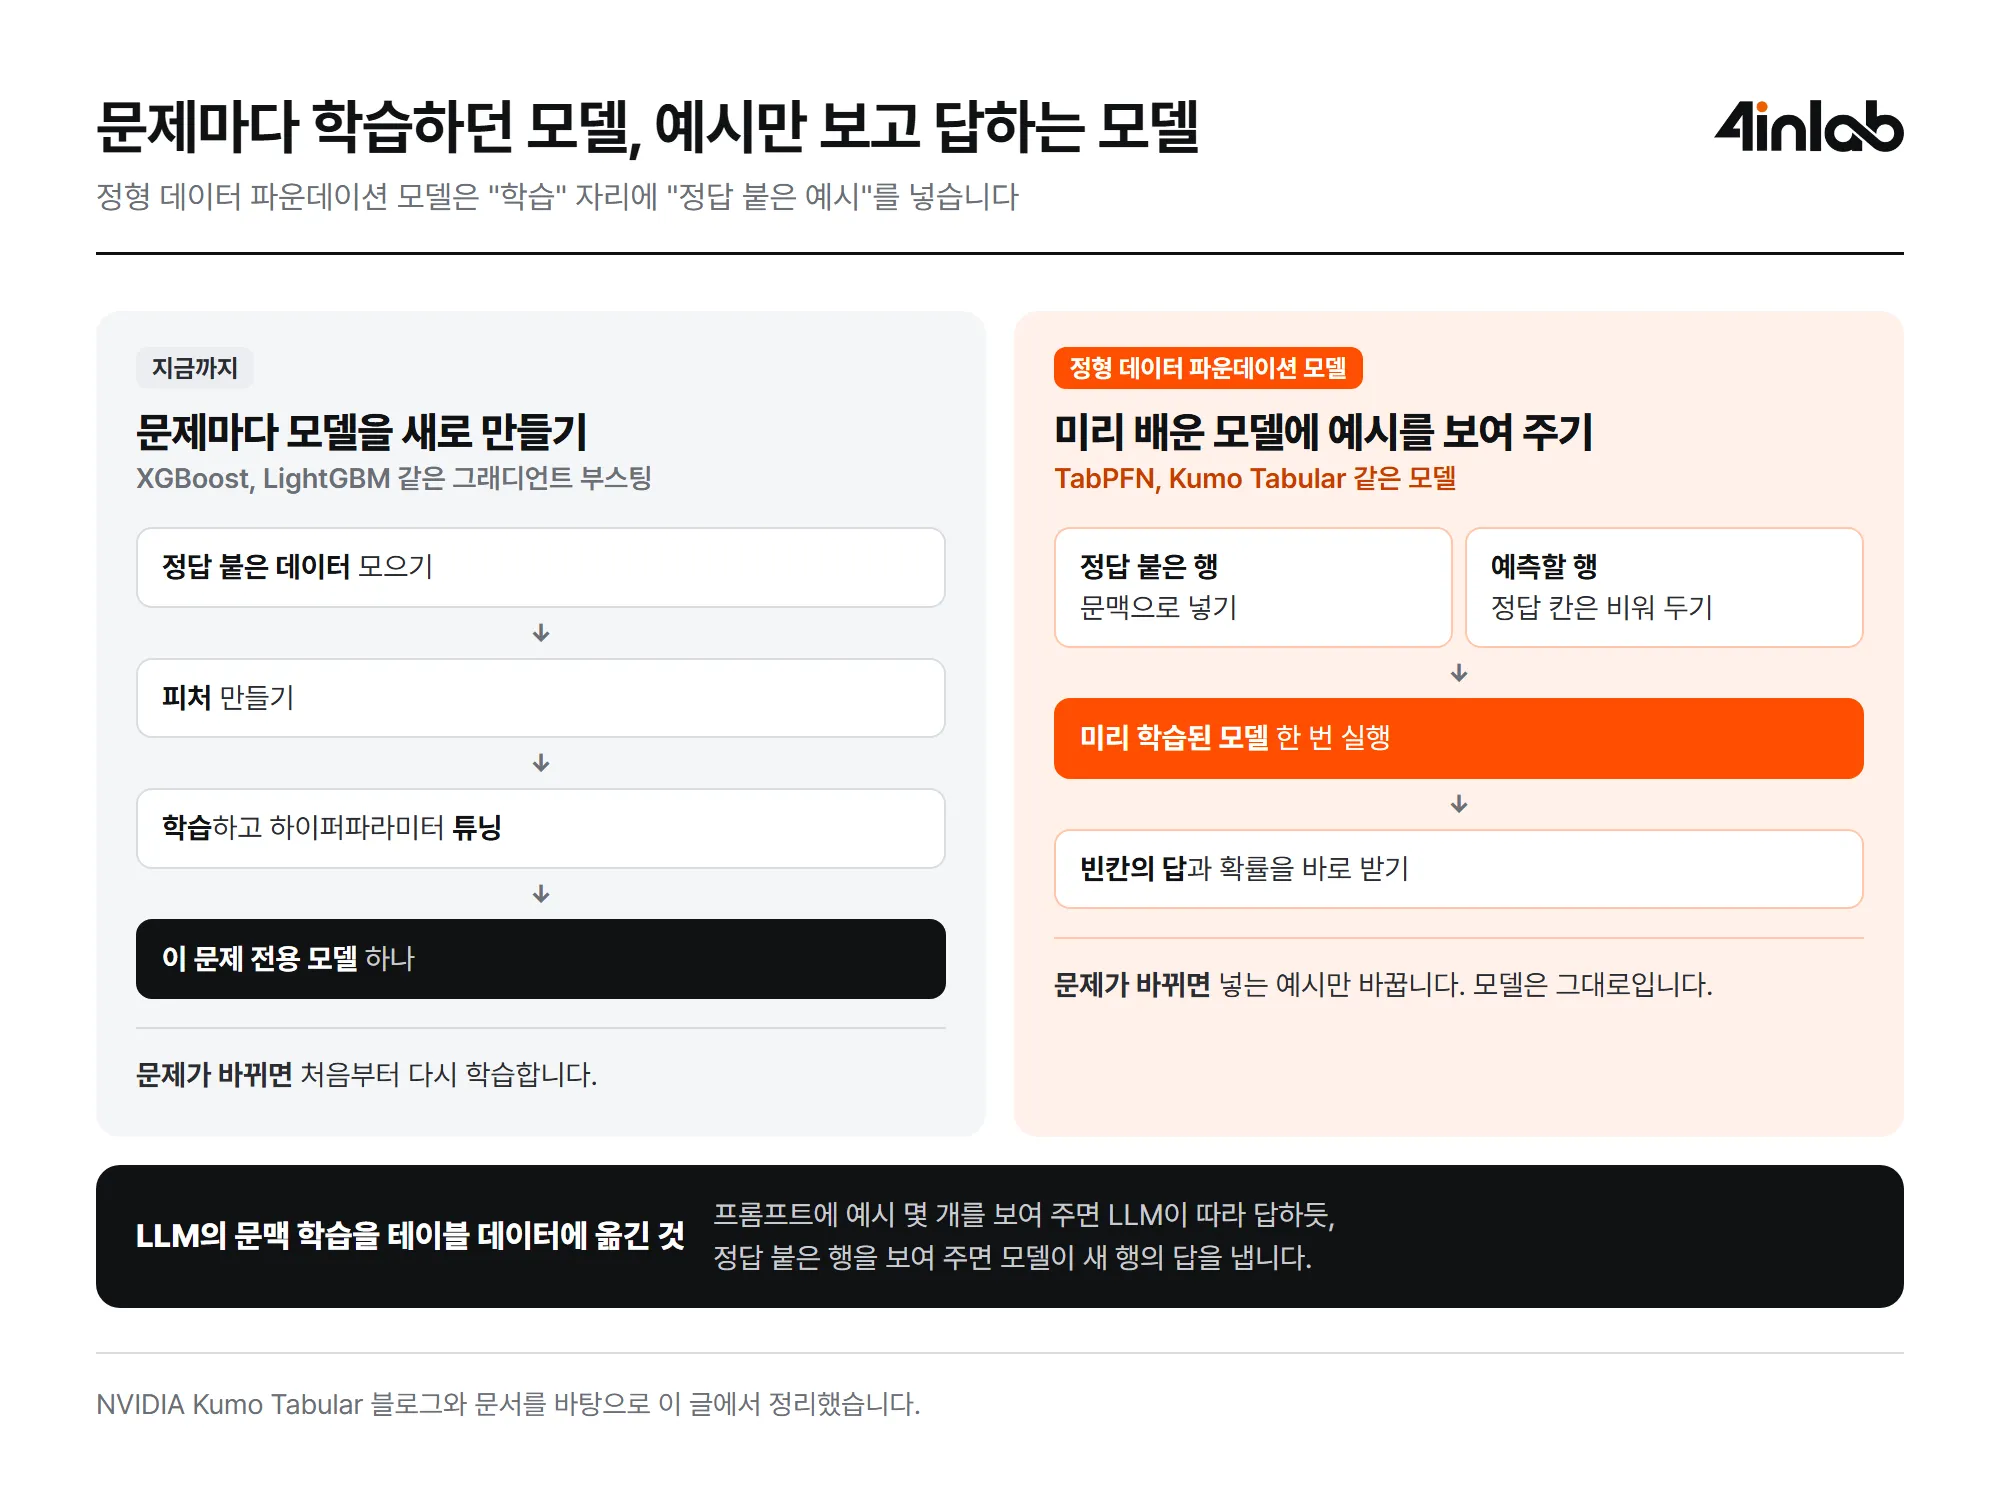
출처: NVIDIA Kumo Tabular (새 탭에서 열림) 블로그와 문서를 바탕으로 정리
이 방향을 크게 알린 것은 2025년 1월 Nature에 실린 TabPFN (새 탭에서 열림)입니다. 그 뒤로 TabICL, LimiX, Mitra 같은 모델이 이어졌고, LG의 EXAONE-Tabular도 TabArena 리더보드 상위권에 올라 있습니다. Kumo Tabular는 이 흐름에서 가장 최근에 나온 모델 가운데 하나입니다.
엔비디아 Kumo Tabular는 무엇일까요?
Kumo Tabular는 엔비디아가 9월 29일 공개한 정형 데이터 파운데이션 모델입니다. 테이블 하나를 받아 분류와 회귀를 하고, 크기는 약 2,800만, 6,200만, 2억 1,500만 파라미터의 세 가지입니다. LLM에 비하면 아주 작은 모델입니다. 가중치는 상업적 사용을 허용하는 OpenMDW-1.1 라이선스로 Hugging Face (새 탭에서 열림)에 공개됐고, 엔비디아의 오픈소스 라이브러리 structured-data-models (새 탭에서 열림)로 불러 쓸 수 있습니다.
이름의 Kumo는 엔비디아가 올해 인수한 것으로 알려진 Kumo AI와 이어집니다. 발표 저자에도 Kumo AI 공동창업자인 스탠퍼드의 Jure Leskovec가 이름을 올렸습니다. 엔비디아는 10월 GTC 베를린에서 Kumo 모델들을 기업 에이전트가 회사 데이터로 예측하게 돕는 Agent Knowledge Foundation의 한 축으로 소개했습니다. 지난 Auto Ontology 글에서 다룬 라이브러리와 같은 묶음입니다.
모델은 세 단계로 테이블을 읽습니다. 먼저 칸 하나하나를 숫자 벡터로 바꾸는데, 빈칸은 억지로 채우지 않고 빈칸이라는 표시를 남깁니다. 다음으로 같은 열 안에서 값을 비교하는 과정과 한 행 안에서 특징끼리의 관계를 보는 과정을 번갈아 거쳐 행마다 요약을 만듭니다. 마지막으로 정답 붙은 행의 요약을 문맥으로 두고, 예측할 행이 그 문맥을 참고해 답을 냅니다. 분류는 클래스별 확률을, 회귀는 예측값과 함께 얼마나 불확실한지를 돌려줍니다.
실제 데이터 없이 어떻게 배웠을까요?
Kumo Tabular는 사전 학습에 실제 데이터를 쓰지 않았습니다. 대신 컴퓨터로 가짜 테이블을 만들어 배웠습니다.
먼저 어떤 값이 어떤 값의 원인이 되는지 무작위 인과 그래프를 그리고, 원인 쪽에 잡음을 넣어 값을 흘려보내 열과 정답을 만듭니다. 여기에 빈칸, 이상치, 범주가 아주 많은 열처럼 현실 데이터의 지저분함을 일부러 섞고, 작은 트리 모델로도 정답을 맞힐 수 없는 테이블은 배울 게 없다고 보고 버립니다. Large 모델은 이렇게 만든 테이블을 약 1억 3,700만 개 봤습니다.
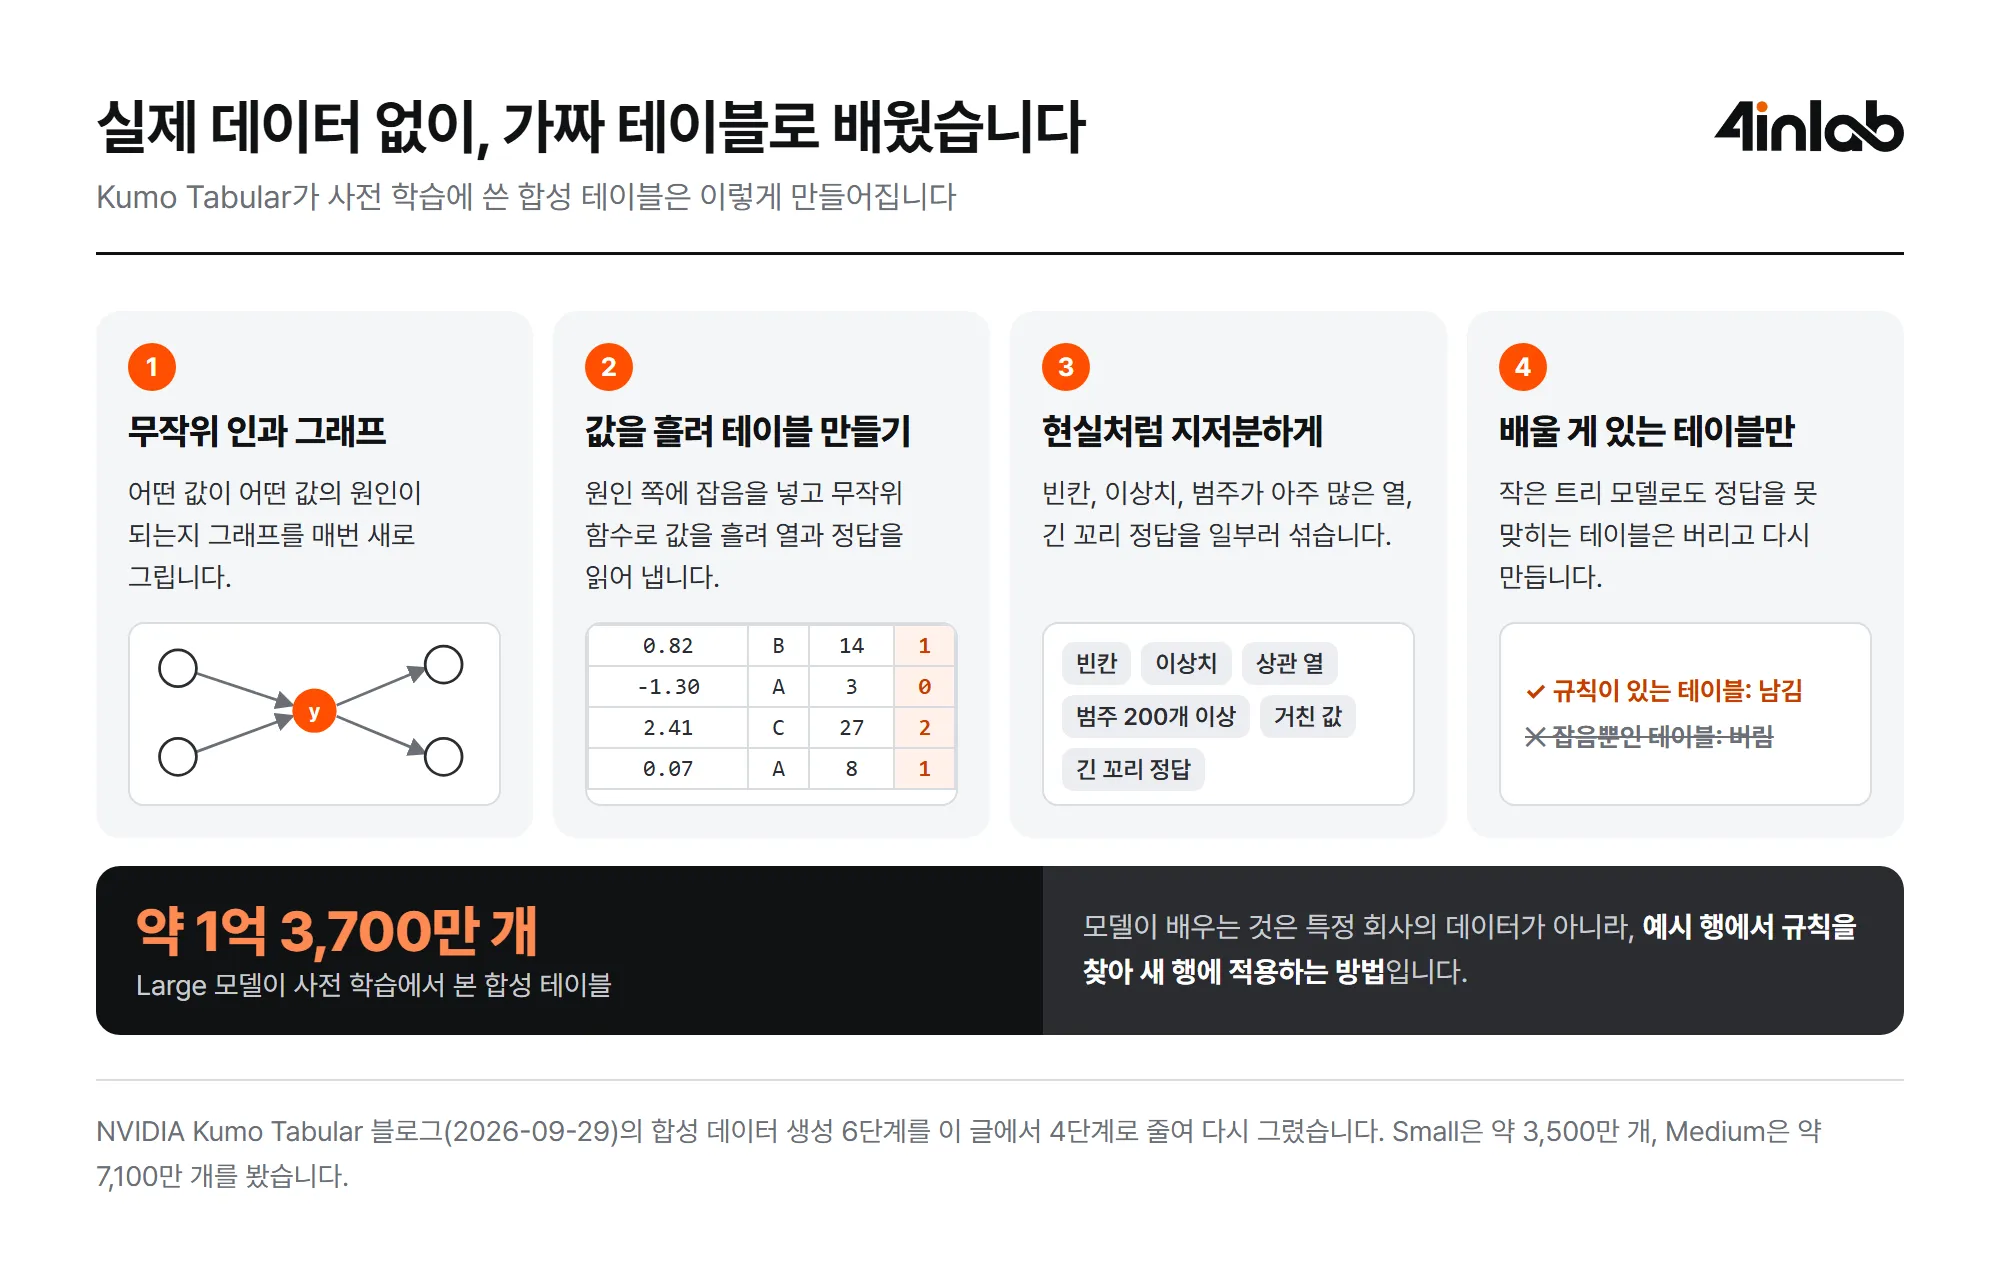
출처: NVIDIA Kumo Tabular (새 탭에서 열림) 블로그의 합성 데이터 생성 6단계를 4단계로 줄여 다시 그림
가짜 테이블로 배운 모델이 진짜 데이터를 맞히는 이유는, 모델이 배우는 대상이 특정 데이터가 아니기 때문입니다. 수많은 가짜 테이블을 풀면서 모델은 예시 행에서 규칙을 찾아 새 행에 적용하는 방법 자체를 익힙니다.
정형 데이터 파운데이션 모델이 배운 것은 어느 회사의 데이터가 아니라, 예시를 보고 규칙을 찾는 방법입니다.
다만 엔비디아는 학습 레시피와 합성 데이터 생성기를 곧 공개하겠다고만 밝혔습니다. 아직은 밖에서 사전 학습을 재현하거나, 정말 실제 데이터가 섞이지 않았는지 확인할 수 없습니다.
얼마나 잘할까요?
엔비디아는 TabArena, BeyondArena, TALENT, ScoringBench 네 벤치마크에서 1위라고 밝혔습니다. 이 가운데 TabArena 리더보드를 직접 확인했습니다. TabArena는 데이터셋 51개로 정형 데이터 예측 방법들의 성능을 겨루는 공개 리더보드입니다.
11월 6일 갱신 기준으로 Kumo Tabular Large가 Elo 1,938로 1위입니다. Medium은 3위, Small은 5위입니다. 하이퍼파라미터를 튜닝하고 여러 모델을 묶은 LightGBM(1,407), CatBoost(1,397), XGBoost(1,356)보다 500점 넘게 높고, 상위 10개가 모두 정형 데이터 파운데이션 모델입니다.
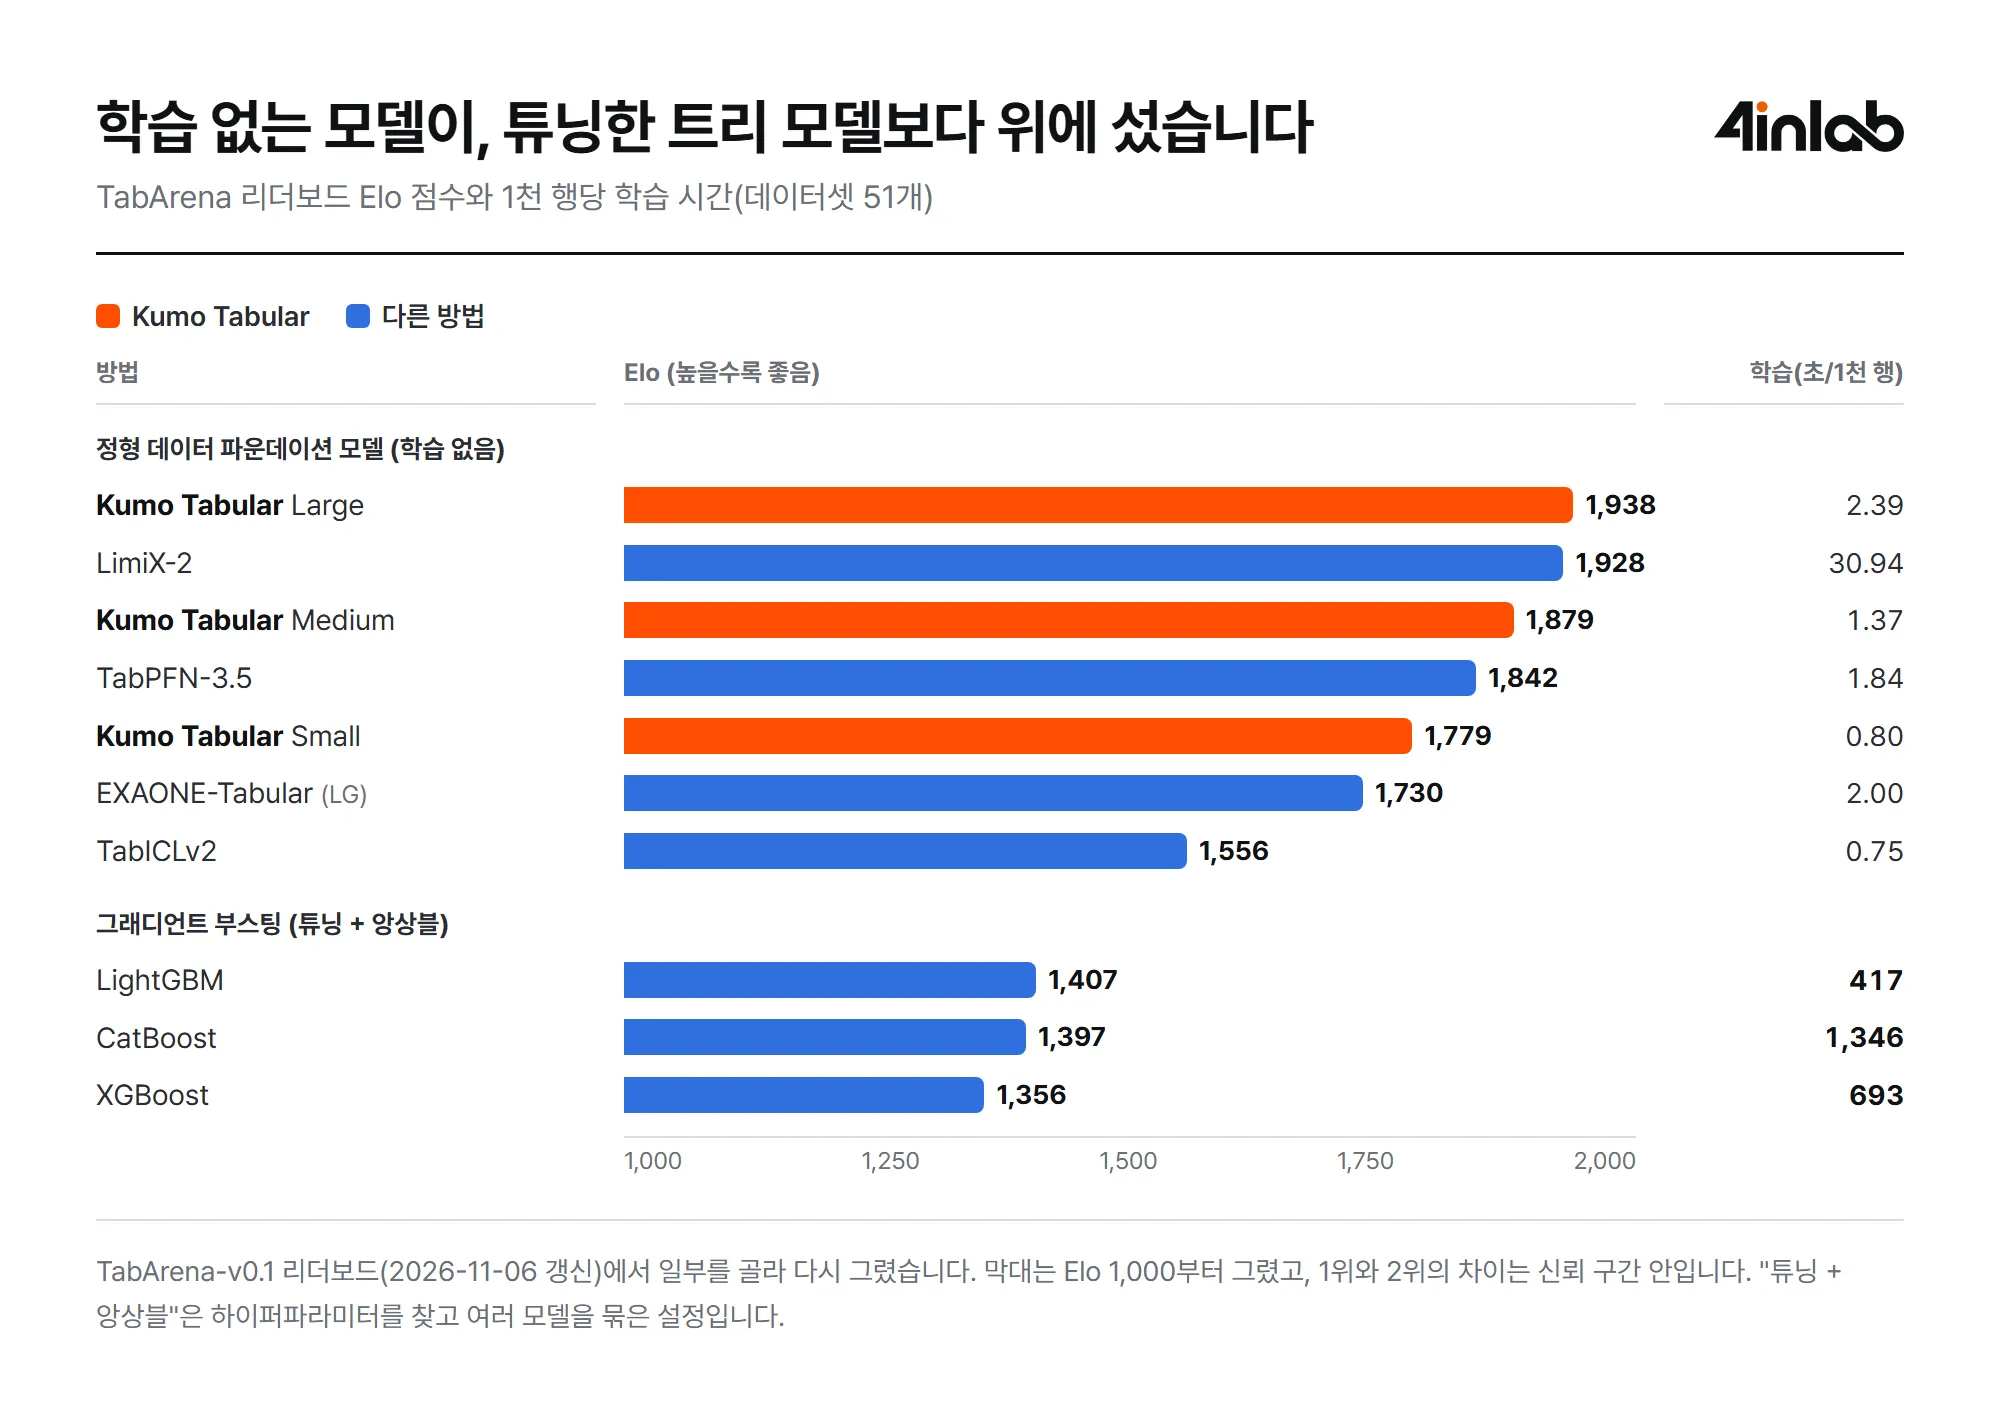
출처: TabArena (새 탭에서 열림) 리더보드(2026-11-06 갱신)에서 일부를 골라 다시 그림
다만 숫자는 조심해서 읽어야 합니다.
- 1위와 2위는 오차 범위 안입니다. LimiX-2와의 차이는 10점으로 신뢰 구간 안에 있습니다. 압도적인 1위라기보다 최상위권에 올랐다고 보는 편이 정확합니다.
- 뚜렷한 장점은 속도입니다. 리더보드가 잰 1천 행당 학습 시간이 2.39초로 LimiX-2(30.94초)보다 약 13배 빠릅니다. 튜닝하고 앙상블한 CatBoost는 같은 일에 1,346초가 걸립니다.
- 예측 속도는 트리 모델이 더 빠를 수 있습니다. 1천 행을 예측하는 데 기본 설정 CatBoost는 0.025초, Kumo Tabular Large는 0.253초가 걸립니다. 초당 수많은 행에 점수를 매겨야 한다면 여전히 트리 모델이 나을 수 있습니다.
- 리더보드가 우리 데이터를 대신하지는 않습니다. TabArena 운영진도 직접 모델을 만들고 기업에 소속돼 있다는 이해 상충을 스스로 공개하고 있습니다.
어디까지 믿고 쓸 수 있을까요?
엔비디아가 밝힌 한계도 분명합니다.
- 숫자와 범주 열만 읽습니다. 텍스트, 이미지, 날짜는 먼저 숫자나 범주로 바꿔야 합니다.
- 테이블 하나만 봅니다. 여러 테이블의 관계를 읽는 일은 Kumo Relational 같은 관계형 모델의 몫입니다.
- 크기에 한도가 있습니다. 한 번에 클래스 10개까지 예측하고, 사전 학습은 최대 100열, 문맥 6만 행까지로 했습니다. 엔비디아의 NIM으로 쓸 때는 문맥이 1만 행으로 제한 (새 탭에서 열림)됩니다.
- 분포가 다르면 흔들립니다. 학습 범위를 크게 벗어난 데이터이거나 문맥 행과 예측할 행의 분포가 다르면 정확도가 떨어질 수 있습니다. 엔비디아도 따로 떼어 둔 데이터로 정확도와 확률이 맞는지 확인하라고 권합니다.
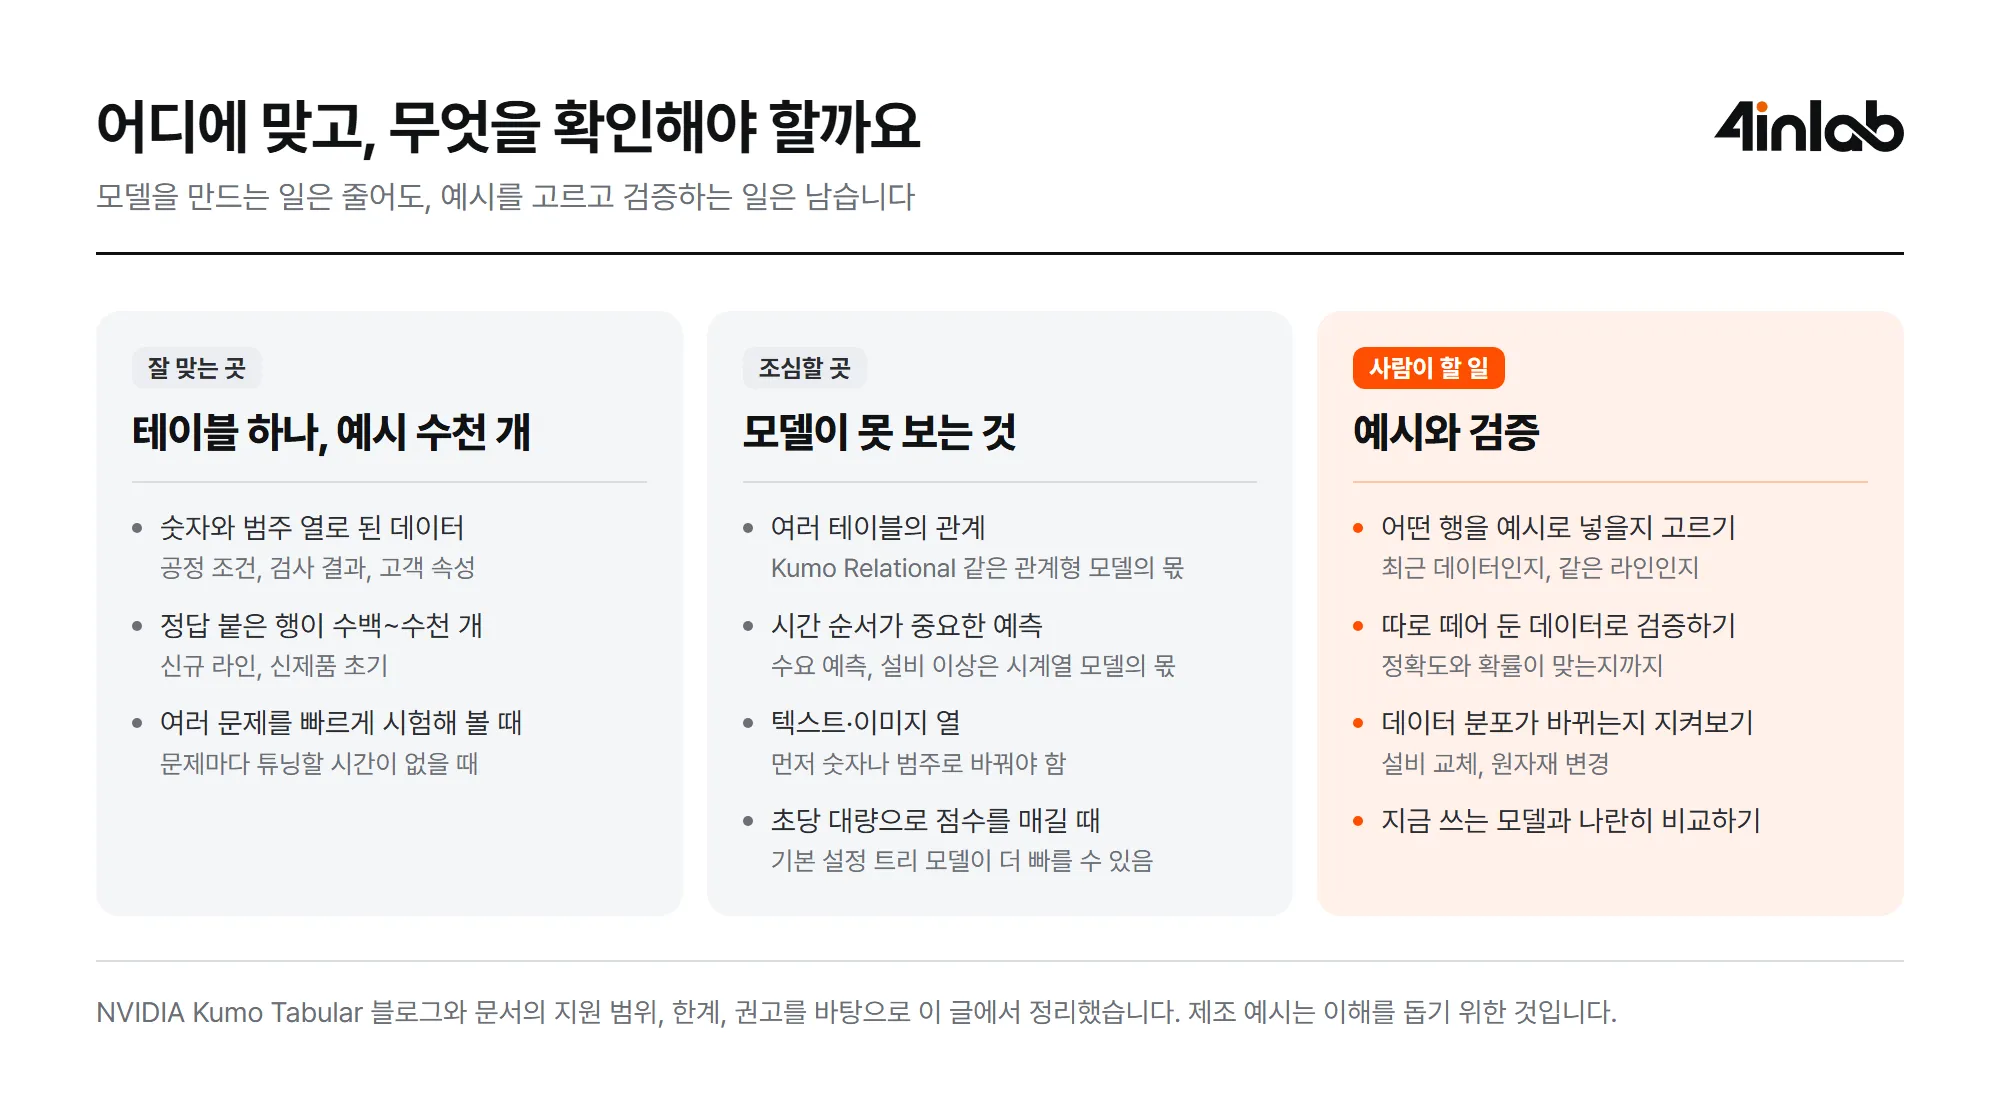
출처: NVIDIA Kumo Tabular (새 탭에서 열림) 블로그와 문서의 지원 범위와 권고를 바탕으로 정리
우리 일에는 무엇이 달라질까요?
제조 현장의 데이터도 대부분 정형 데이터입니다. 온도, 압력, 속도 같은 공정 조건과 자재 로트, 검사 결과가 쌓입니다. 지금까지는 불량 예측 하나를 만들려 해도 데이터를 모으고 모델을 학습하고 튜닝하는 데 시간이 들었습니다. 특히 신규 라인이나 신제품 초기에는 정답이 붙은 데이터가 적어 모델을 만들기 어려웠습니다. 정형 데이터 파운데이션 모델은 이런 곳에서 첫 예측을 빠르게 시험해 볼 길을 엽니다.
그렇다고 할 일이 사라지지는 않습니다. 일이 모델을 만드는 쪽에서 예시를 고르고 검증하는 쪽으로 옮겨 갈 뿐입니다.
- 어떤 행을 예시로 넣을지 정해야 합니다. 최근 데이터만 넣을지, 같은 라인의 데이터만 넣을지에 따라 답이 달라집니다.
- 따로 떼어 둔 데이터로 검증해야 합니다. 리더보드 1위가 우리 데이터에서의 1위를 뜻하지는 않습니다.
- 분포가 바뀌는 순간을 지켜봐야 합니다. 설비를 바꾸거나 원자재가 달라지면 예전 예시가 더는 맞지 않을 수 있습니다.
- 지금 쓰는 모델과 나란히 비교해야 합니다. 정확도뿐 아니라 예측 속도와 운영 비용까지 함께 봅니다.
학습 없이 예측한다는 말은 반만 맞습니다. 모델은 다시 학습하지 않아도 되지만, 어떤 예시를 보여 줄지와 그 답을 믿어도 될지는 여전히 사람이 정합니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
로봇에는 어떤 AI가 들어갈까요?
공장 로봇은 지금도 작업마다 위치를 하나하나 가르쳐야 합니다. 그런데 몇 번 보여 주면 새 일을 하는 로봇 AI가 나오고 있습니다. 로봇 파운데이션 모델이 무엇이고 무엇으로 배우는지, 지금 어디까지 왔는지 살펴봅니다.
LLM이 하던 일, 누가 가져가고 있을까?
아마존은 사내 티켓 분류에서 LLM을 빼고 결정 모델을 넣었습니다. 호출 시간은 78%, 정가 기준 비용은 약 98% 줄었다고 합니다. 무엇을 바꿨고 어떻게 갈아탔는지 살펴보고, LLM이 하던 일이 어디로 옮겨 가고 있는지 짚어 봅니다.