LLM도 잠을 자야 한다고요?
새로 배우면 예전 것을 잊는 LLM의 문제부터, 깨어 있다가 잠들어 정리하는 방법까지
LLM은 배포된 순간부터 사실상 멈춰 있습니다. 사전 학습이 끝난 날짜, 이른바 지식 기준일 이후에 일어난 일은 모델의 가중치에 쌓이지 않습니다. 대화 중에 알려 준 내용은 그 대화 안에서만 쓰이고, 세션이 끝나면 모델은 아무것도 배우지 않은 상태로 돌아갑니다.
사람은 다릅니다. 낮에 겪은 일은 잠자는 동안 정리돼 오래 가는 기억이 됩니다. 구글 리서치가 10월 말 소개한 Sleep 프레임워크 (새 탭에서 열림)는 이 방식을 LLM에 옮겼습니다. 모델은 깨어 있을 때 평소처럼 일하고, 잠자는 동안 그동안 문맥에 쌓인 기억을 가중치로 옮깁니다.
LLM에게 왜 잠이 필요한지, 지금의 LLM이 새 지식을 어떻게 다루는지부터 짚어 보겠습니다.
LLM은 왜 배운 것을 오래 간직하지 못할까요?
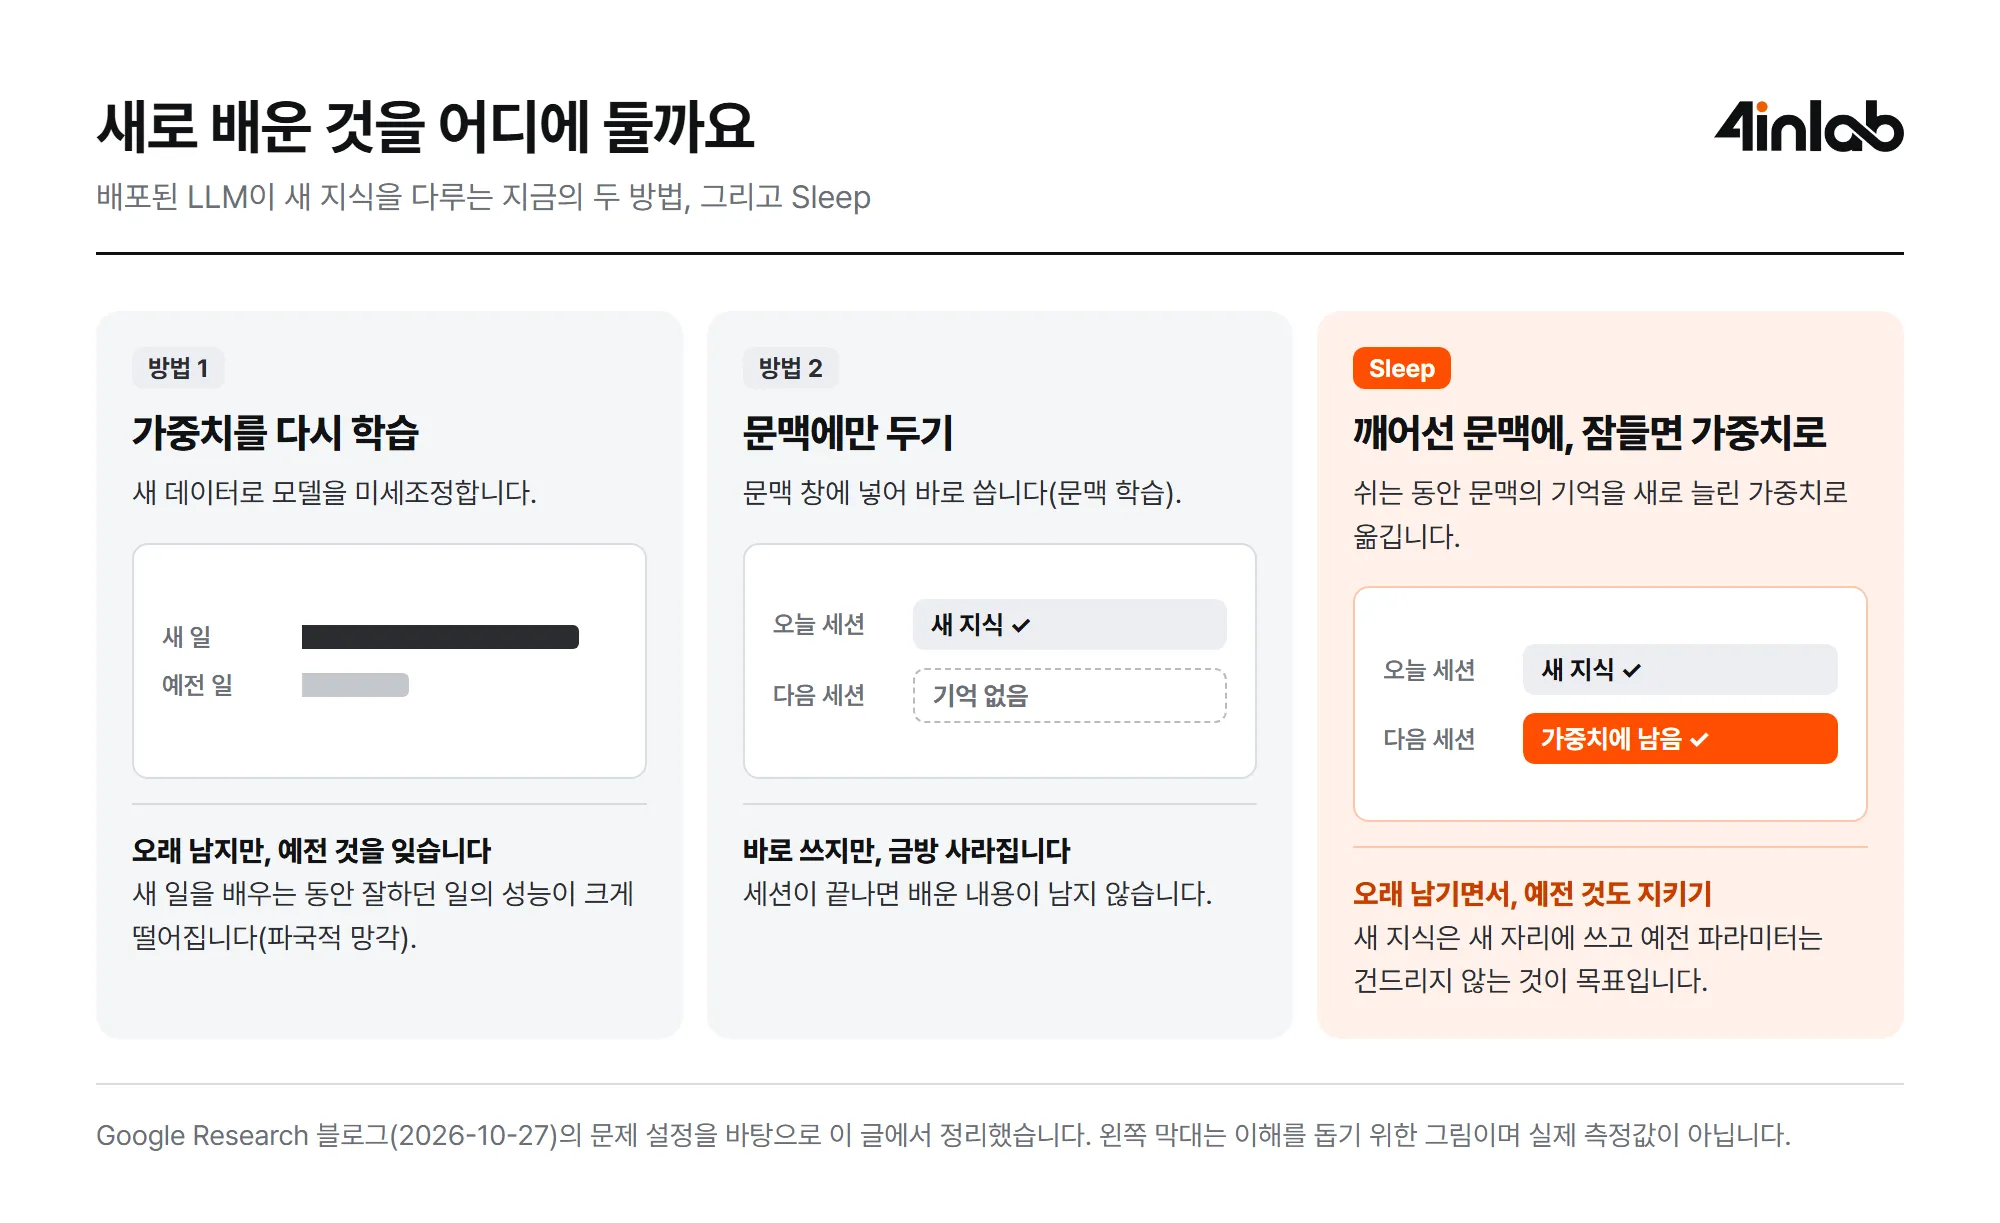
배포된 LLM에 새 지식을 넣는 방법은 크게 두 가지입니다.
첫째는 가중치를 다시 학습하는 것입니다. 새 데이터로 미세조정하면 지식이 모델 안에 오래 남습니다. 문제는 새것을 배우는 동안 예전에 잘하던 일을 잊는다는 점입니다. 이를 파국적 망각(catastrophic forgetting)이라고 부릅니다. 신경망은 여러 지식을 같은 가중치에 겹쳐 담기 때문에, 새 과제에 맞춰 가중치를 고치면 예전 과제에 필요했던 값까지 바뀝니다.
둘째는 문맥에만 두는 것입니다. 프롬프트에 자료를 넣으면 모델은 그 자리에서 읽고 바로 씁니다. 이를 문맥 학습(in-context learning)이라고 합니다. 가중치를 건드리지 않으니 예전 것을 잊을 일은 없지만, 배운 내용이 문맥 창 안에만 머물기 때문에 세션이 끝나면 사라집니다.
새 지식을 오래 남기면서 예전 능력도 지키고, 계속 배워 나가는 것을 지속 학습(continual learning)이라고 합니다. 오래된 숙제지만 LLM에서 널리 쓰이는 답은 아직 없습니다.
출처: Google Research (새 탭에서 열림) 블로그의 문제 설정을 바탕으로 정리
구글 Sleep 프레임워크는 무엇일까요?
Sleep 프레임워크는 구글 리서치의 Ali Behrouz, Vahab Mirrokni 등이 논문 Language Models Need Sleep (새 탭에서 열림)에서 제안하고, 10월 27일 블로그로 소개한 지속 학습 방법입니다. 같은 저자들이 지난해 발표한 Nested Learning (새 탭에서 열림)과 그때 나온 Hope 구조를 바탕으로 합니다.
핵심은 학습과 사용을 딱 나누지 않고, 모델이 두 상태를 번갈아 오가게 하는 것입니다.
- 깨어 있는 단계: 평소처럼 입력을 받고 답합니다. 새로 본 내용은 문맥과 빠르게 바뀌는 기억에 임시로 둡니다.
- 잠자는 단계: 새 입력을 멈추고, 임시 기억을 오래 가는 가중치로 옮기고(기억 통합) 스스로 만든 예제로 연습합니다(꿈).
이름은 사람의 잠에서 따왔습니다. 깊은 잠에서 그날의 기억이 장기 기억으로 굳고, 렘수면에서 꿈을 꾸며 새로운 연결을 찾는다는 설명에 빗댄 것입니다. 다만 구글도 선을 긋습니다. 잠과 꿈은 신경과학에서 빌린 말일 뿐이고, 실제로는 정해진 모델 구조와 사람이 정한 학습 규칙 안에서 가중치를 고치는 자동 사후 학습 과정이라는 것입니다.
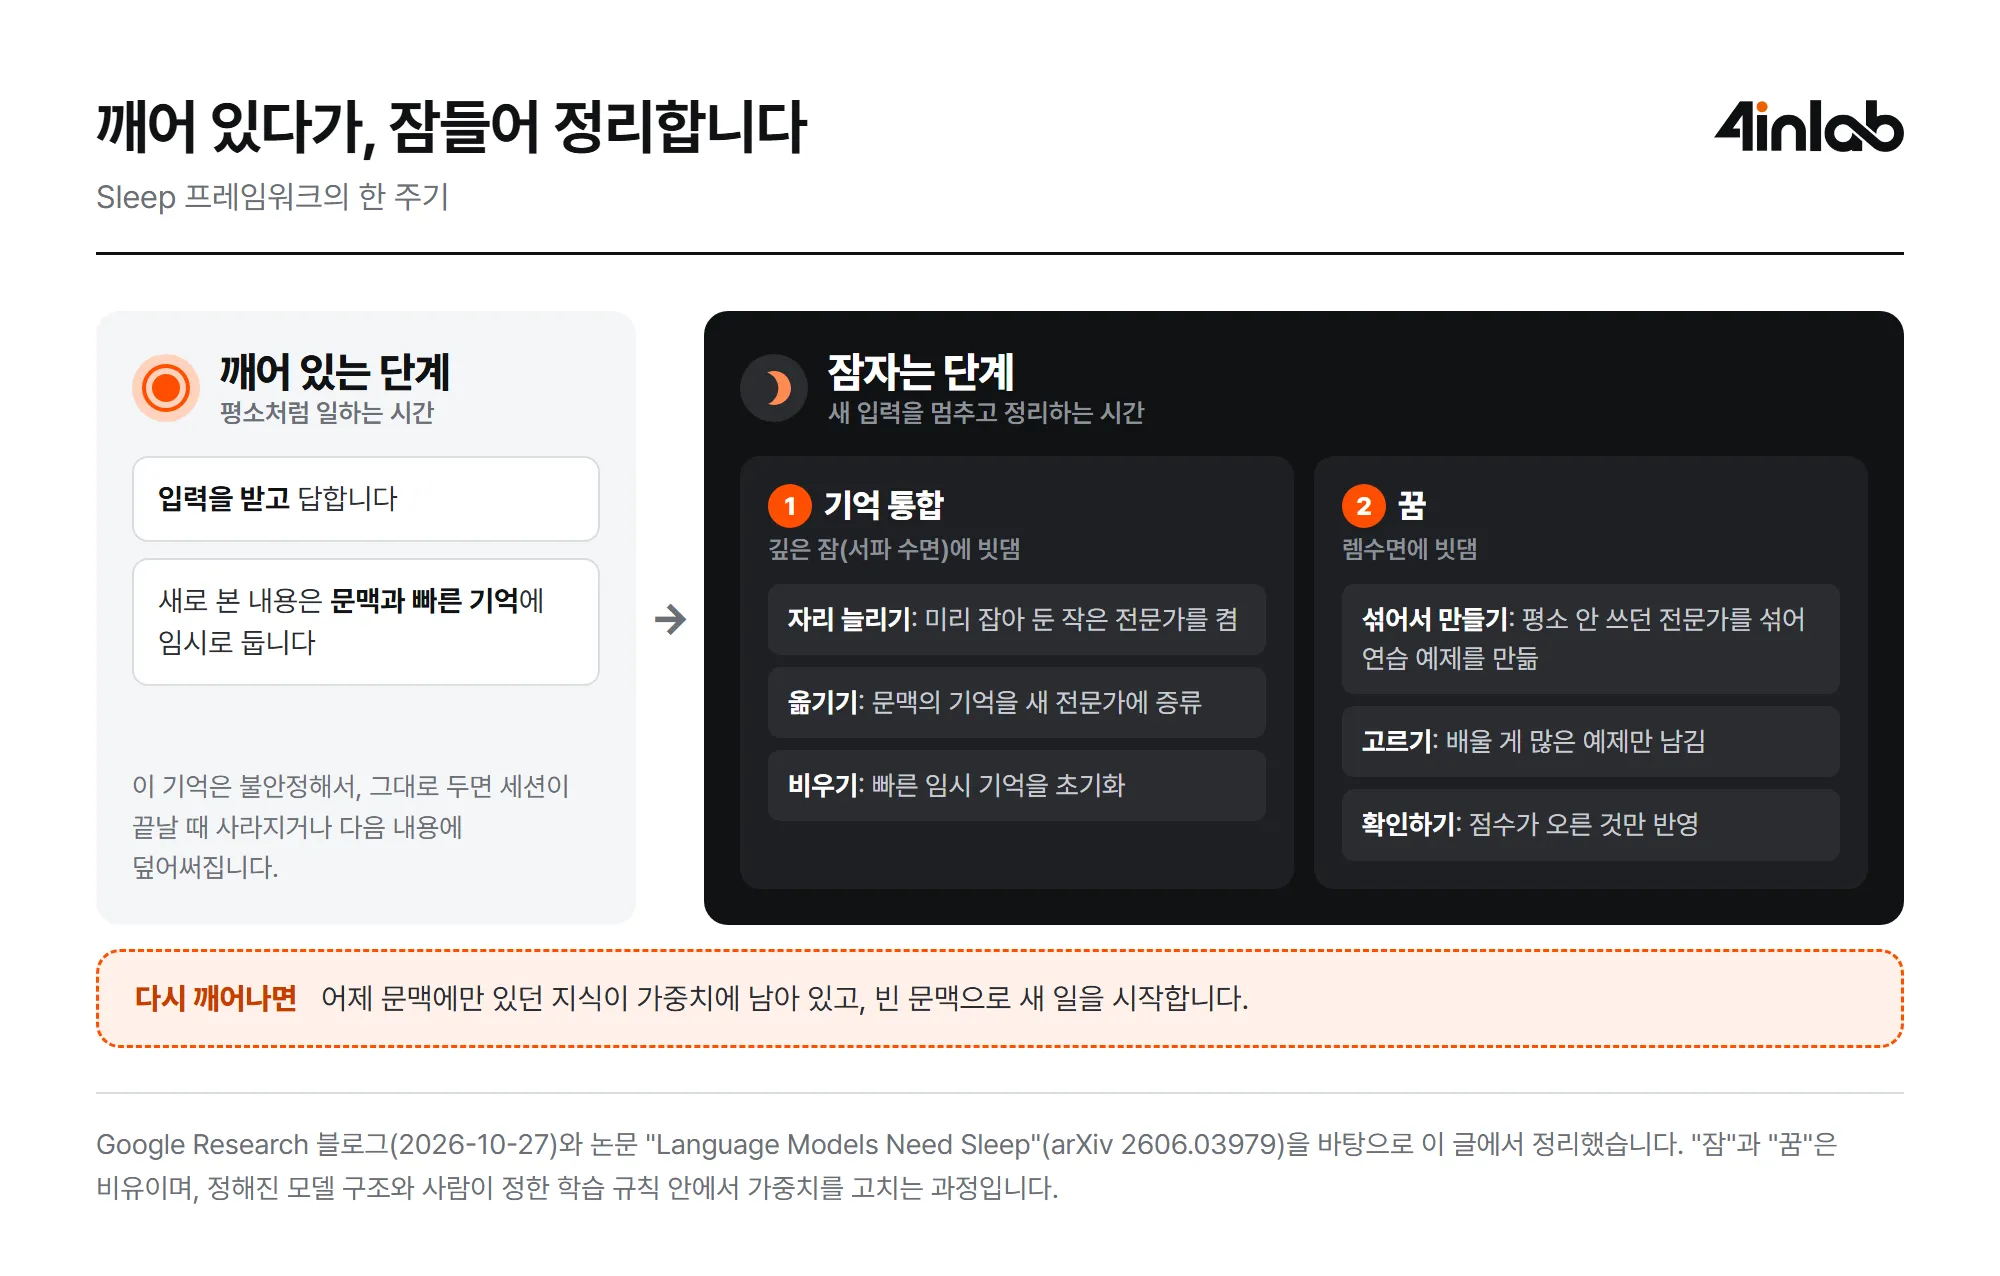
출처: Google Research (새 탭에서 열림) 블로그와 논문 (새 탭에서 열림)을 바탕으로 정리
잠자는 동안 기억은 어디로 옮겨질까요?
Sleep이 잊지 않고 배우려는 방법은 새 지식을 쓸 자리를 따로 만드는 것입니다.
모델 안에는 갱신 주기가 다른 기억 층이 있습니다. 문맥은 토큰마다 바뀌는 가장 빠른 기억이고, 그 아래로 자주 갱신되는 블록부터 드물게 갱신되는 블록까지 층이 이어집니다. Nested Learning에서 연속체 기억 시스템이라고 부른 구조입니다. 잠자는 단계에서는 빠른 층의 기억을 느린 층으로 세 단계에 걸쳐 옮깁니다.
- 자리 늘리기: 느린 블록에 미리 잡아 둔 작은 전문가(저랭크 전문가)를 켭니다. 이 블록은 여러 전문가 가운데 일부만 골라 쓰는 MoE(Mixture of Experts) 구조라, 전문가를 하나 더 켜도 예전 파라미터는 그대로 둘 수 있습니다.
- 옮기기: 지식 시딩(knowledge seeding)이라고 부르는 증류 단계입니다. 빠른 기억에 새 지식을 담고 있는 지금 모델이 교사, 새 전문가를 붙인 모델이 학생이 되고, 학생은 새 전문가만 학습합니다. 학생이 직접 쓴 문장에 교사가 토큰마다 정답 분포를 알려 주는 온-정책 증류와, 교사가 쓴 글의 앞부분을 이어 쓰게 하고 뜻과 글자가 비슷할수록 보상하는 모방 학습을 함께 씁니다.
- 비우기: 옮긴 뒤에는 빠른 블록의 임시 기억을 초기화합니다. 시냅스 가지치기에 빗댄 단계로, 다음 깨어 있는 단계에서 새 내용을 받을 자리를 만듭니다.
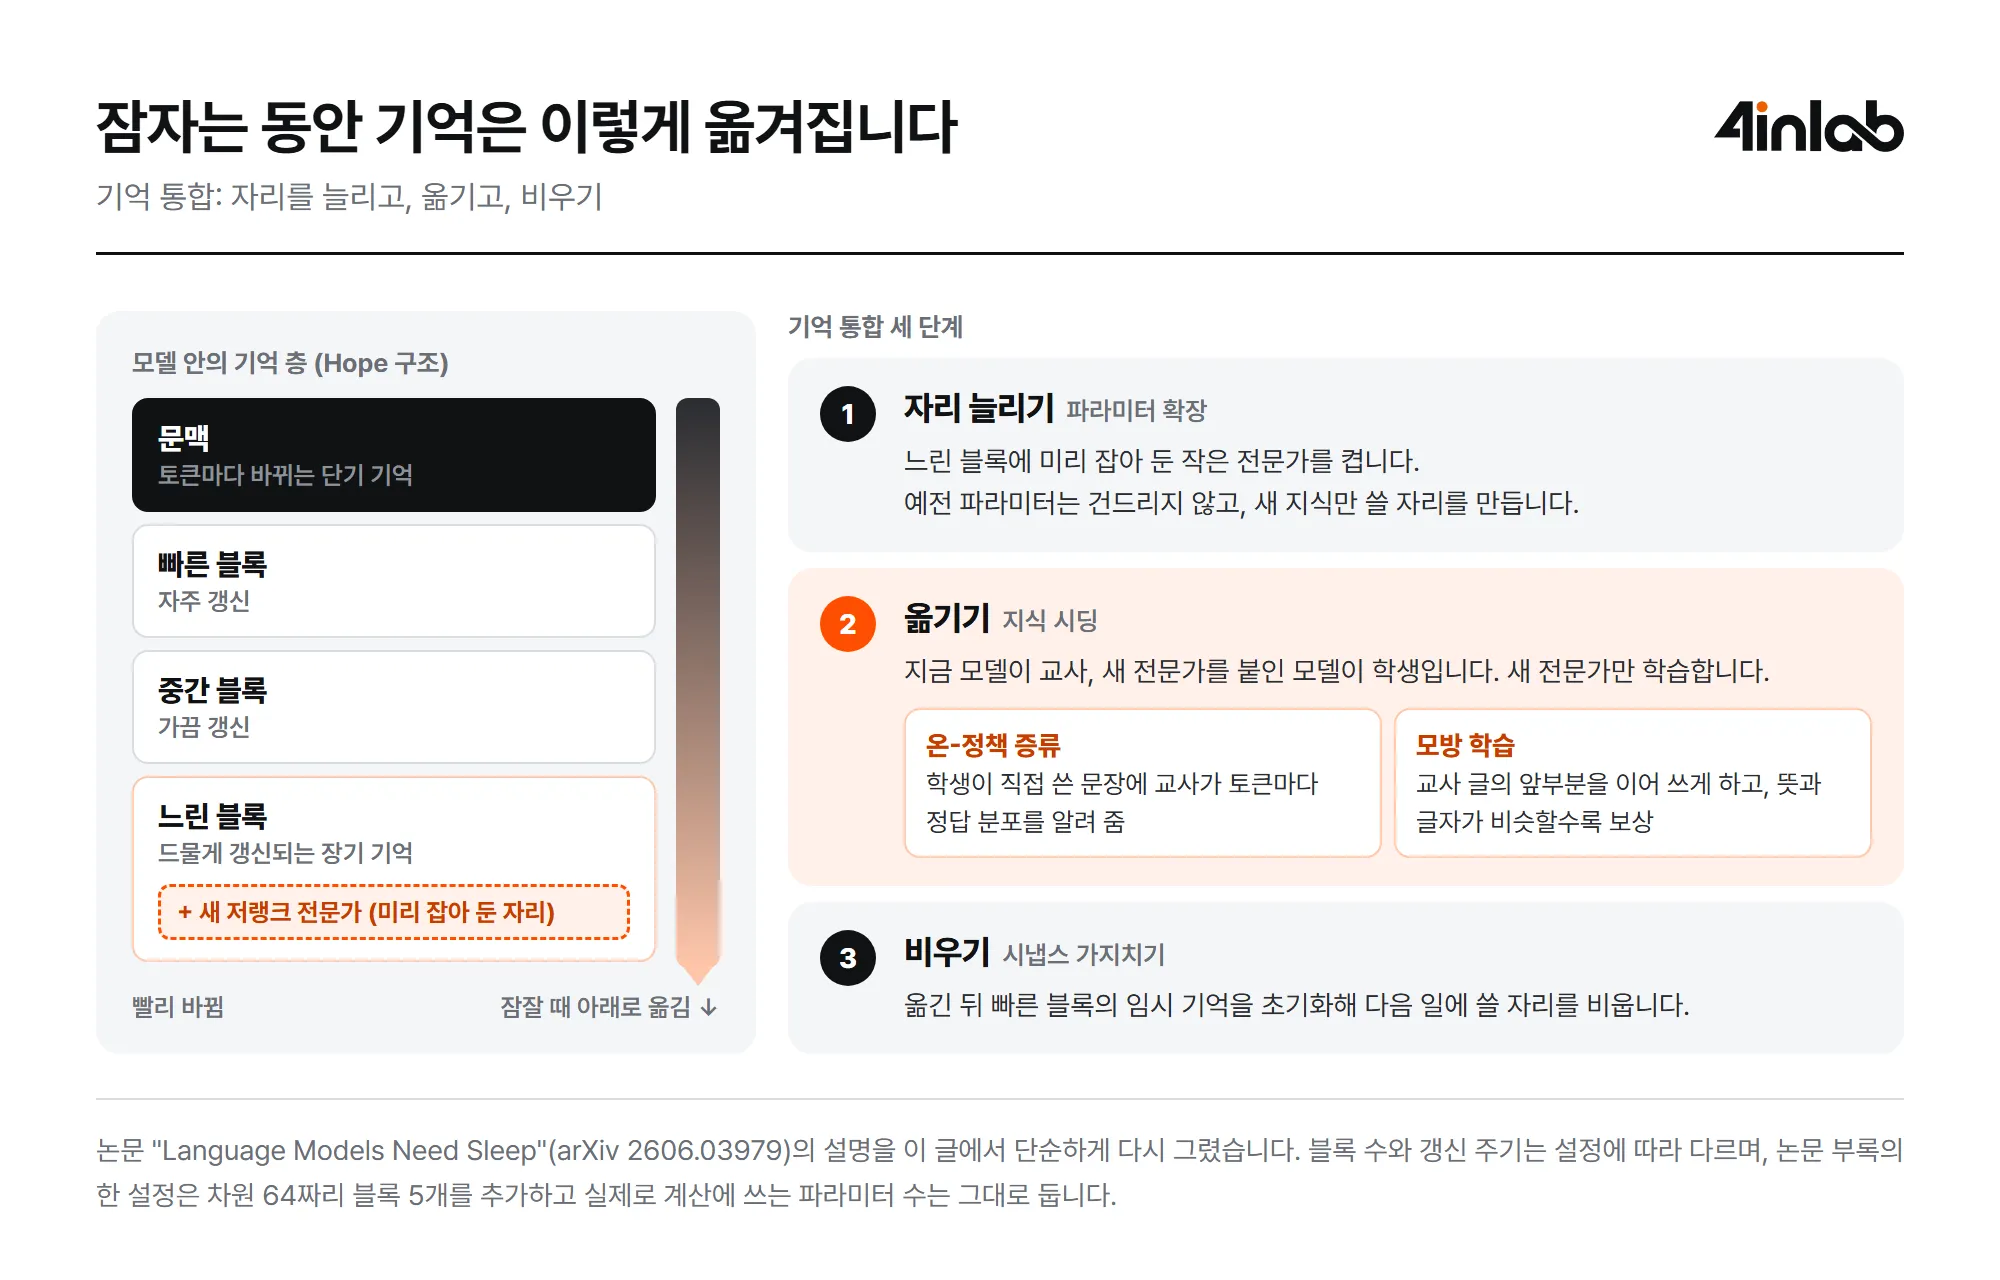
출처: 논문 (새 탭에서 열림)의 설명을 바탕으로 단순하게 다시 그림
새 지식을 기존 가중치에 덮어쓰지 않고 새 자리에 쓰기 때문에 예전 지식이 덜 흔들립니다. 블로그는 이 과정을 작은 공간으로 압축하는 문제로 볼 수 있다고 설명합니다. 단기 기억의 세부를 모두 옮기는 대신, 모델의 행동과 뜻을 가장 잘 지키는 몇 방향만 골라 담는다는 것입니다.
꿈은 왜 꿀까요?
기억 통합이 새로 배운 것을 옮겨 담는 일이라면, 꿈은 그 지식으로 연습하는 단계입니다.
- 섞어서 만들기: 모델이 스스로 연습용 예제("꿈")를 만듭니다. 이때 MoE 라우터가 평소에는 고르지 않던 전문가를 무작위로 섞어, 서로 다른 지식을 이어 붙인 예제가 나오게 합니다.
- 고르기: 만든 예제 가운데 기울기를 기준으로 배울 게 많은 것만 남깁니다.
- 확인하기: 고른 예제로 미세조정해 보고, 실제 과제 점수가 오른 경우에만 보상을 줘 강화학습으로 다듬습니다. 모델이 스스로 학습 데이터를 만들어 가중치를 고치는 MIT의 SEAL 방식을 따른 것입니다.
꿈의 효과는 실험에서 뚜렷했습니다. 새 사실을 넣는 실험에서 꿈 단계를 빼자 정확도가 48.9%에서 35.7%로 떨어졌습니다. 옮겨 담기만 해서는 새 사실을 꺼내 쓰기 어렵다는 결과입니다.
이 흐름은 지난 RSI 글에서 다룬, 스스로를 개선하는 AI와도 닿아 있습니다. 다만 Sleep의 자기 개선은 정해진 구조와 규칙 안에서, 점수가 오른 예제만 받아들이는 좁은 범위의 개선입니다.
얼마나 잊지 않았을까요?
가장 눈에 띄는 결과는 처음 보는 언어의 번역입니다. 사전 학습에서 보지 못한 만주어와 칼라망어를 차례로 배우게 한 뒤, 두 언어를 영어로 옮기는 점수(ChrF)를 쟀습니다. 문맥 학습은 만주어만 배웠을 때 20.9였지만, 칼라망어까지 배우자 10.1로 떨어졌습니다. Sleep은 두 언어를 모두 배운 뒤에도 만주어 23.9, 칼라망어 38.1로 성능이 거의 떨어지지 않았습니다. 블로그는 문맥 학습뿐 아니라 Cartridges와 지도 미세조정(SFT)도 순차 학습에서 심한 파국적 망각을 보였다고 밝혔습니다.
다른 실험에서도 결과는 같은 방향이었습니다.
- 새 사실 넣기: SQuAD 문단을 학습시킨 뒤 문맥 없이 질문했을 때 48.9%로, 기본 모델(31.9%)과 SEAL(46.7%)보다 높았습니다.
- 수학 추론: Qwen3-8B에 적용하자 AIME-24 점수가 73.8에서 79.2로 올랐고, SFT, GRPO, 온-정책 자기 증류(OPSD)보다 높았습니다.
- 분류 클래스 늘리기: 분류할 클래스를 차례로 늘려 가는 실험에서 CLINC 97%, Banking 92%, DBpedia 89%로 비교한 방법 가운데 가장 높았습니다.
- 긴 문맥: BABILong에서 1,000만 토큰까지 거의 완벽에 가까운 점수를 유지했다고 밝혔습니다.
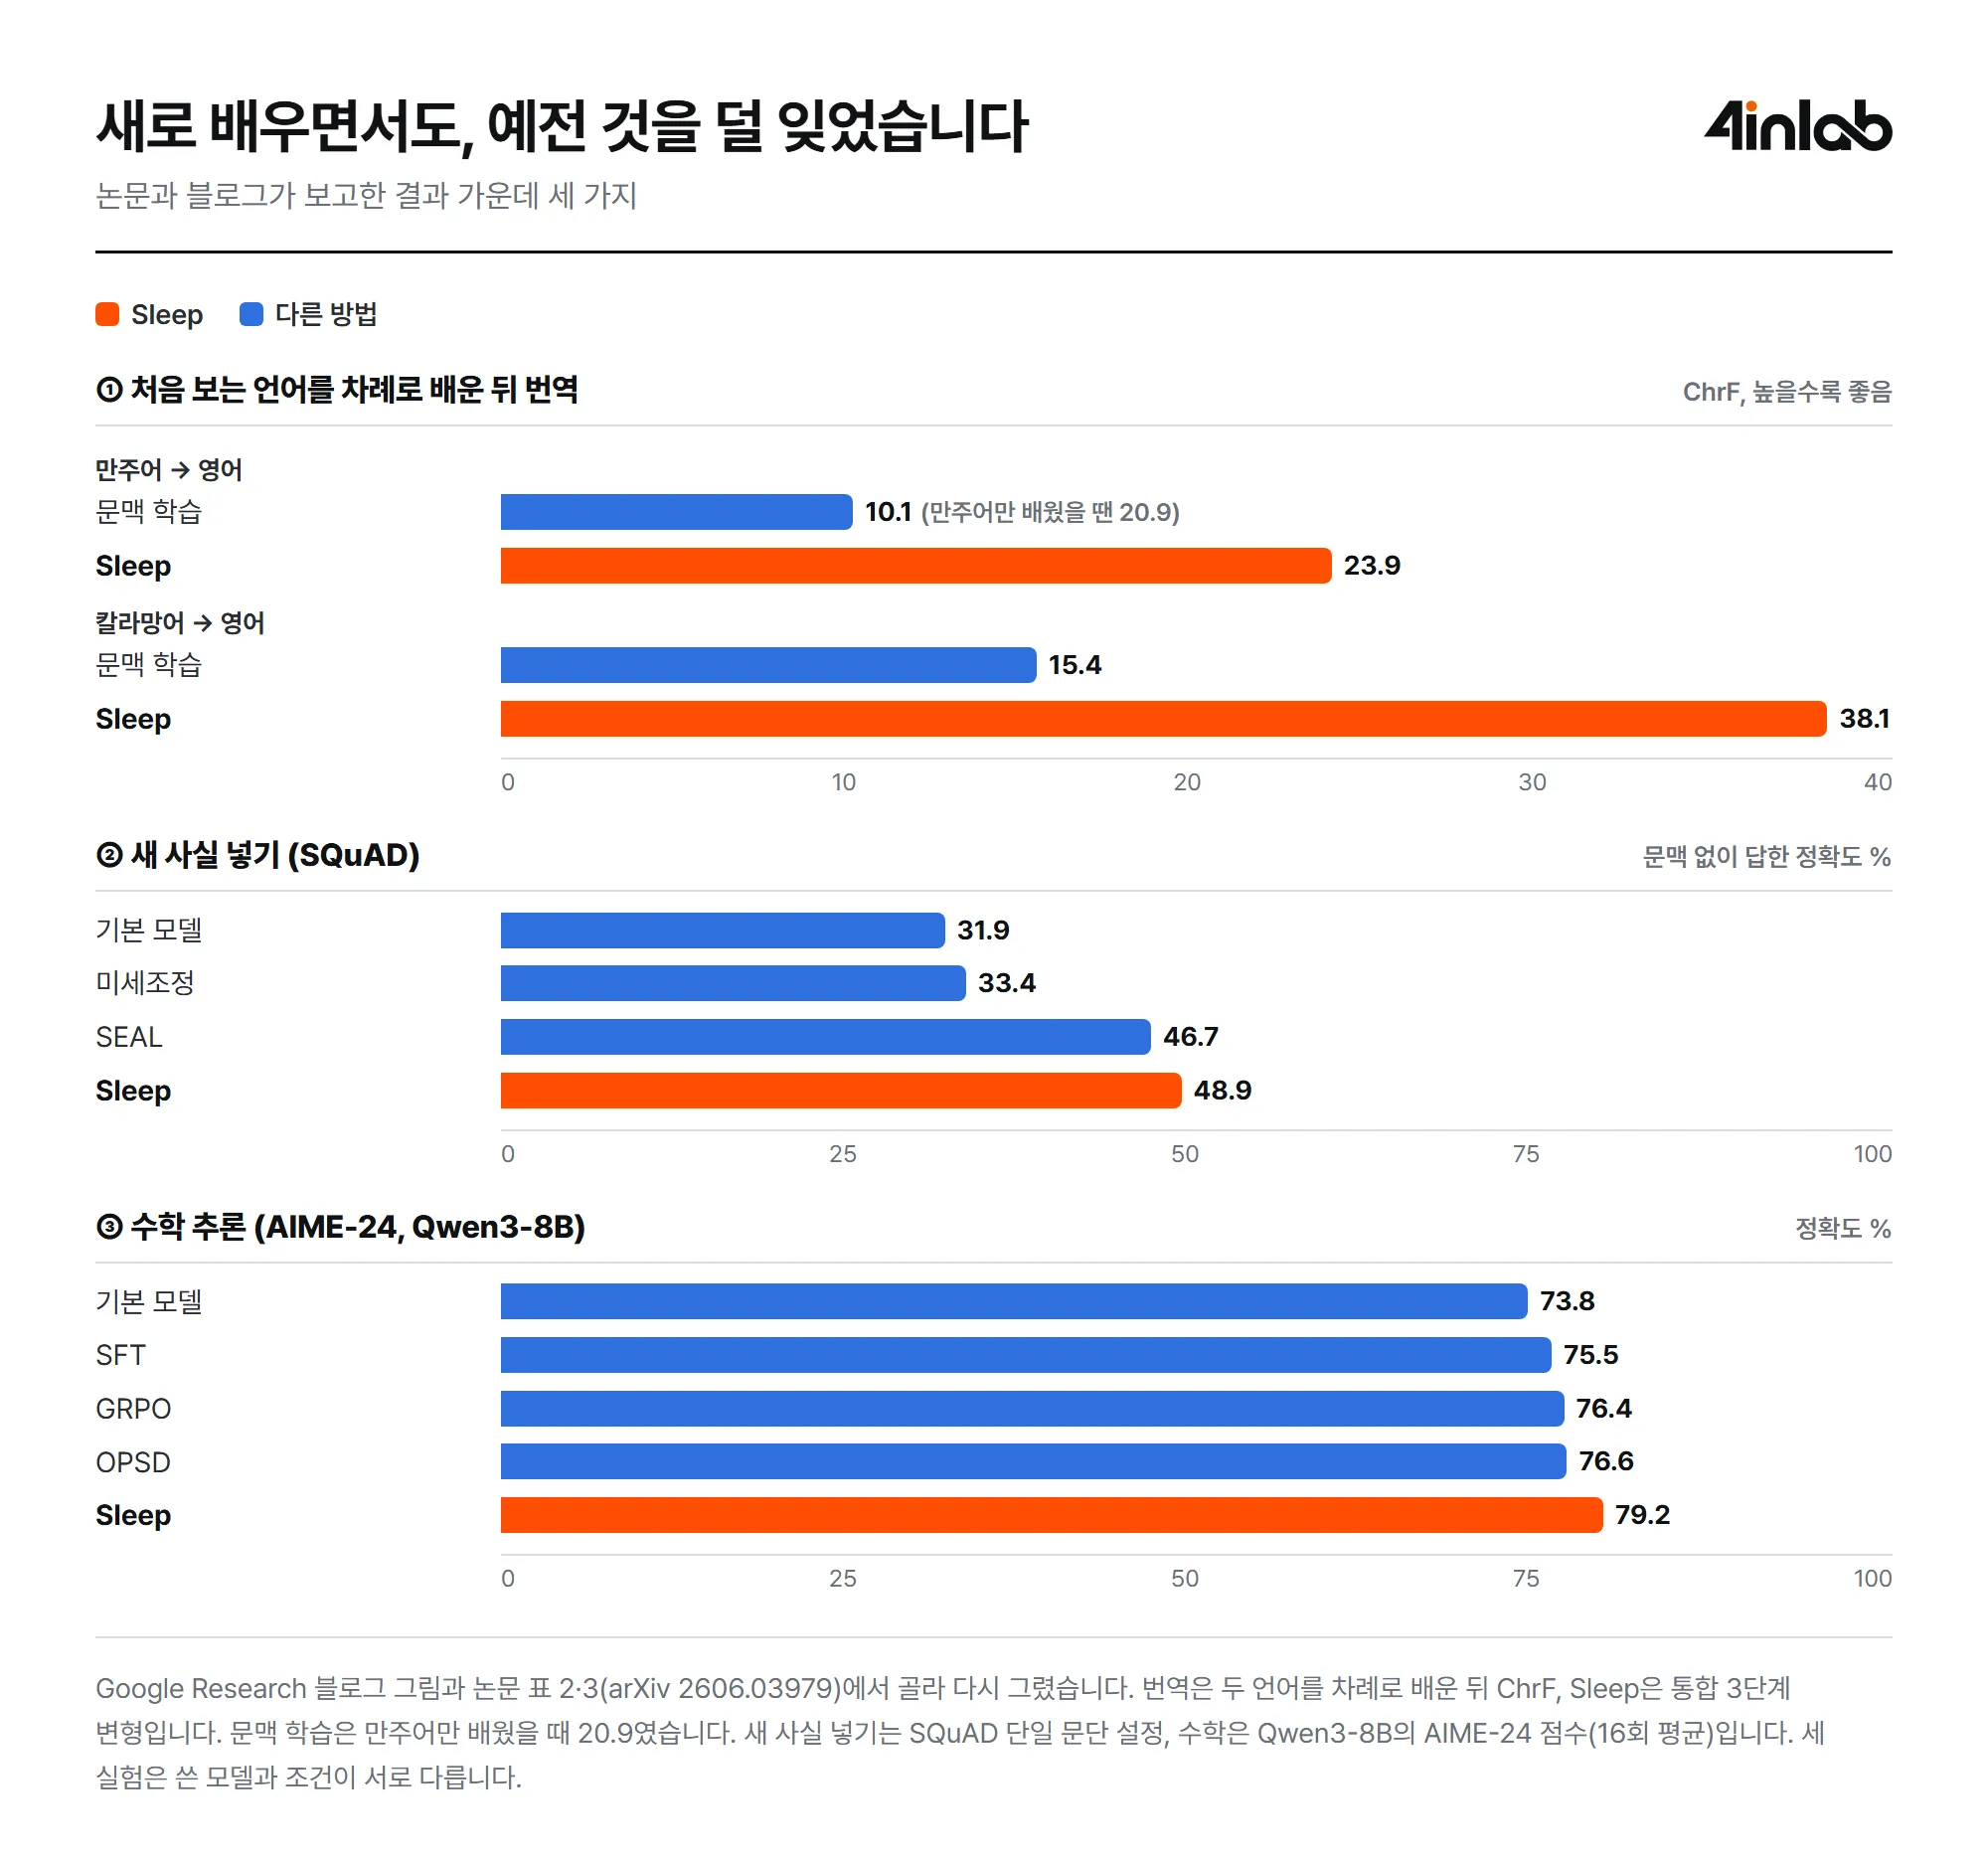
출처: Google Research (새 탭에서 열림) 블로그 그림과 논문 (새 탭에서 열림) 표 2·3에서 일부를 골라 다시 그림
어디까지 믿고 볼 수 있을까요?
숫자는 인상적이지만, 읽을 때 조심할 점도 있습니다.
- 실험마다 모델이 다릅니다. 수학은 Qwen3, 분류는 Llama 3B와 8B, 몇 개 예시로 푸는 추론은 Llama-3.2-1B로 쟀습니다. 한 모델이 모든 결과를 낸 것이 아니고, 대부분 80억 파라미터 이하의 모델입니다.
- 비교 조건이 같지 않은 실험이 있습니다. 긴 문맥 실험에서 GPT-4는 미세조정 없이 비교됐고, 1,000만 토큰 결과는 표 없이 그림으로만 제시됐습니다.
- 잠에도 비용이 듭니다. 꿈 단계에서는 예제마다 미세조정을 돌려 점수를 확인합니다. 논문도 비용 때문에 꿈의 수를 적게 잡았다고 적었습니다. 같은 성능에 이르기까지 SFT가 3.6~4.8배 더 오래 걸렸다고 하지만, 같은 학습 스텝 수로 비교하면 SFT가 더 빠릅니다.
- 아직 재현하기 어렵습니다. 공식 코드나 가중치 공개는 찾지 못했습니다. Hope와 MoE를 합친 구조라 지금 쓰는 모델에 바로 붙이기도 어렵고, 논문에는 한계를 따로 다룬 절이 없습니다.
우리 일에는 무엇이 달라질까요?
제조 현장의 AI는 배포한 뒤에도 계속 새 정보를 만납니다. 설비를 바꾸고, 새 제품이 들어오고, 처음 보는 불량이 생기고, 작업 기준이 고쳐집니다. 지금은 대개 문서를 검색해 문맥에 넣는 RAG로 버티거나, 데이터를 모아 주기적으로 다시 학습합니다. 앞의 방법은 세션마다 다시 찾아 넣어야 하고, 뒤의 방법은 예전에 잘하던 판단을 잊을 위험을 안고 갑니다.
Sleep이 보여 주는 것은 특정 기법보다 운영 방식에 가깝습니다. 일하는 시간과 정리하는 시간을 나누고, 정리할 때는 새 지식을 새 자리에 쓰고, 정말 나아졌는지 확인한 것만 받아들입니다. 공장의 비가동 시간이나 야간 배치와도 잘 맞는 그림입니다.
그렇다고 바로 가져다 쓸 수 있는 기술은 아닙니다. 지금 할 수 있는 일은 이런 방식에 대비해 두는 것입니다.
- 무엇을 기억할지 정해야 합니다. 하루 동안 쌓인 문맥 가운데 오래 남길 지식과 흘려보낼 대화를 가르는 기준이 먼저입니다.
- 잊지 않았는지 확인할 시험이 있어야 합니다. 새 지식을 넣은 뒤에도 예전 판단을 그대로 하는지 볼 평가 세트를 따로 둡니다.
- 되돌릴 수 있어야 합니다. 정리한 뒤 성능이 떨어지면 잠들기 전 상태로 돌아갈 수 있게 모델 버전을 관리합니다.
LLM이 잠을 자게 되더라도, 무엇을 기억할 가치가 있는지와 정리한 결과를 믿어도 될지는 여전히 사람이 정합니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
LLM이 하던 일, 누가 가져가고 있을까?
아마존은 사내 티켓 분류에서 LLM을 빼고 결정 모델을 넣었습니다. 호출 시간은 78%, 정가 기준 비용은 약 98% 줄었다고 합니다. 무엇을 바꿨고 어떻게 갈아탔는지 살펴보고, LLM이 하던 일이 어디로 옮겨 가고 있는지 짚어 봅니다.
보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
로봇에는 어떤 AI가 들어갈까요?
공장 로봇은 지금도 작업마다 위치를 하나하나 가르쳐야 합니다. 그런데 몇 번 보여 주면 새 일을 하는 로봇 AI가 나오고 있습니다. 로봇 파운데이션 모델이 무엇이고 무엇으로 배우는지, 지금 어디까지 왔는지 살펴봅니다.