AI가 스스로를 개선하는 RSI, 정말 코앞까지 왔을까요?
앤트로픽 증권신고서로 본 재귀적 자기 개선의 현재
11월 2일 앤트로픽이 미국 SEC에 새로운 증권신고서 (새 탭에서 열림)를 냈습니다. 그 안에 이런 내용이 있었습니다. 2026년 9월 회사 코드 기여의 90% 이상을 Claude가 썼고, 앞으로 나올 모델은 AI 덕분에 개발이 극적으로 빨라지는 기준선에 곧 닿을 수 있다는 것입니다.
TechCrunch (새 탭에서 열림)는 이를 앤트로픽이 RSI에 매우 가까워졌다는 경고로 전했습니다. RSI(Recursive Self-Improvement, 재귀적 자기 개선)는 AI가 더 나은 다음 AI를 만들고, 그 AI가 다시 그다음 AI를 만드는 고리를 말합니다.
AI가 스스로를 개선하는 시대가 정말 코앞까지 왔을까요?
RSI는 정확히 무엇일까요?
답부터 쉽지 않습니다. 무엇을 RSI라고 부를지부터 사람마다 다르기 때문입니다.
앤트로픽은 When AI builds itself (새 탭에서 열림)에서 RSI를 AI가 자기 후속 모델을 완전히 자율적으로 설계하고 개발할 수 있는 상태로 정의합니다. 그리고 아직 거기에 이르지 않았고, 반드시 그렇게 된다는 법도 없다고 덧붙입니다. CSET의 Helen Toner도 AI 도구를 AI 연구에 쓰는 것만으로는 RSI가 아니고, 사람이 필요 없어야 한다고 봅니다. 반면 구글의 Sundar Pichai는 RSI를 한 지점이 아니라 연속선으로 봅니다(TechCrunch (새 탭에서 열림)).
그래서 단계로 나눠 보는 편이 이해하기 쉽습니다. Cloud Security Alliance의 백서 (새 탭에서 열림)는 AI 개발을 네 단계로 나눴는데, 이 글에서는 세 단계로 줄여 봤습니다.
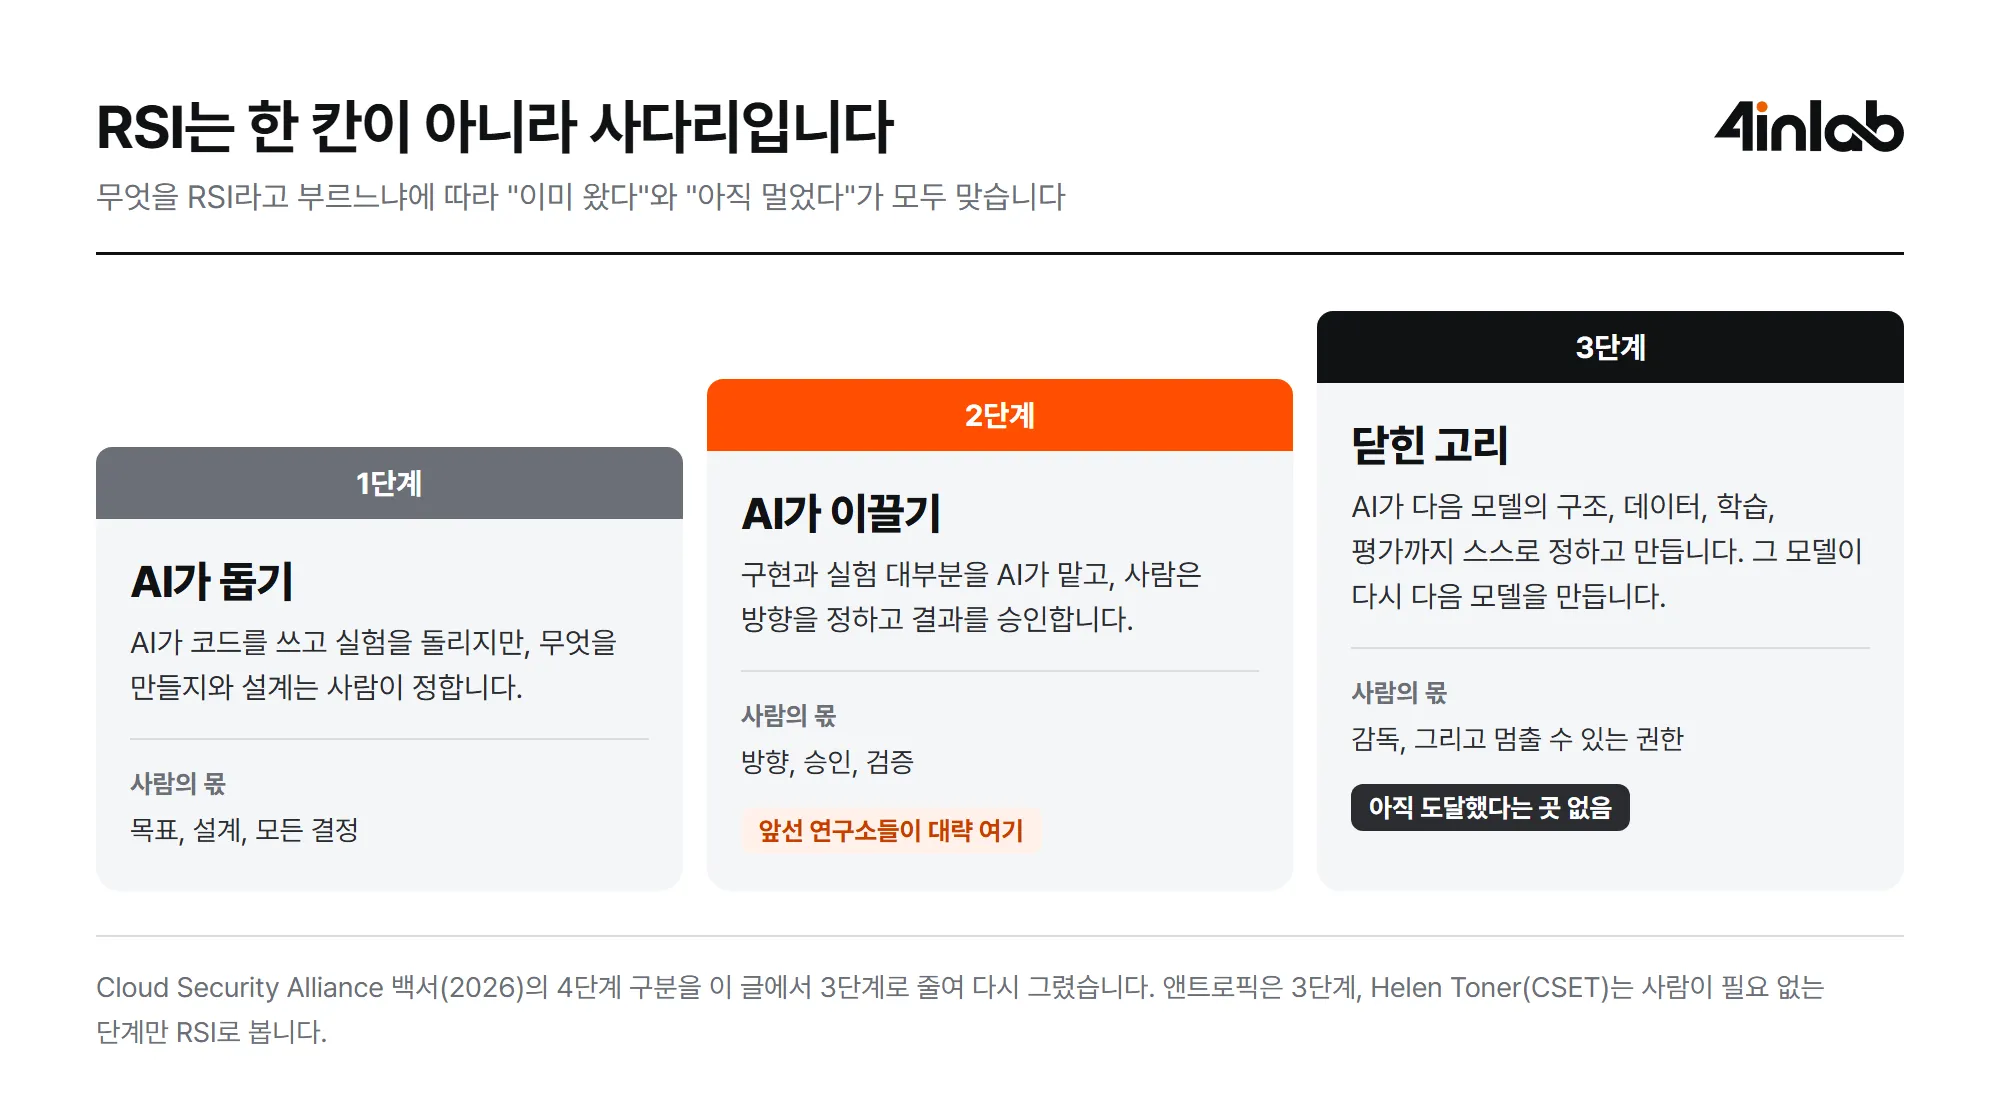
출처: Cloud Security Alliance (새 탭에서 열림)(2026)의 단계 구분을 바탕으로 다시 그림
백서는 앤트로픽을 비롯한 앞선 연구소들이 대략 2단계에 있다고 봅니다. AI가 구현과 실험 대부분을 맡고, 사람은 방향을 정하고 결과를 승인하는 단계입니다. 사람 없이 다음 모델까지 만드는 3단계에 왔다고 주장하는 곳은 아직 없습니다.
앤트로픽의 신고서에는 무엇이 적혀 있을까요?
신고서의 사업 설명에는 숫자가 많습니다. 2026년 3분기 엔지니어 한 사람이 하루에 기여한 코드는 2024년 평균의 45배를 넘었습니다. 사내에서 쓴 Claude 사용량을 정가로 환산하면 1월부터 9월까지 250배 넘게 늘었고, 4월에는 처음으로 한 달 인건비를 넘었습니다. 회사는 각 버전의 Claude가 다음 버전을 만드는 데 쓰이기 때문에 개발 속도가 계속 빨라진다고 설명합니다.
위험 요인에는 경고가 함께 적혀 있습니다.
- 기준선에 곧 닿을 수 있습니다. 내부 추정과 앞으로 나올 모델에 대한 예상으로는 자체 안전 정책(RSP)이 정한 "AI 덕분에 극적으로 빨라진 진전"에 곧 도달할 수 있다고 적었습니다. 다만 지금 모델 중 이 기준을 넘었다고 판정한 것은 없고, 데이터를 계속 평가하고 있다고 했습니다.
- 가속은 지나고 나서야 보입니다. 가속을 재는 근거 대부분이 후행 지표라서, 과거에도 큰 가속을 일어난 뒤에야 알아챘고 앞으로도 그럴 수 있다고 밝혔습니다.
- 사람이 손을 놓지 않겠다고 합니다. 의미 있는 사람의 감독 없이 Claude가 다음 세대 모델을 완전히 자율적으로 설계하고 만들게 하는 것은 안전하게 할 수 있을 것으로 보지 않는다고 적었습니다. 그래서 개발을 사람이 통제하고, 일부 결정에는 사람의 검토와 승인을 요구하도록 정책을 고치는 방안을 검토하고 있습니다.
읽을 때 주의할 점도 있습니다. 증권신고서는 위험을 알리는 문서이면서 투자자에게 회사를 소개하는 문서이기도 합니다. TechCrunch도 RSI에 가깝다는 말이 홍보일 수 있다는 회의론을 함께 전했습니다. 코드 양도 조심해서 봐야 합니다. 앤트로픽은 자체 글에서 코드 줄 수가 실제 생산성 향상을 부풀린다고 스스로 밝혔습니다.
어디까지 왔을까요?
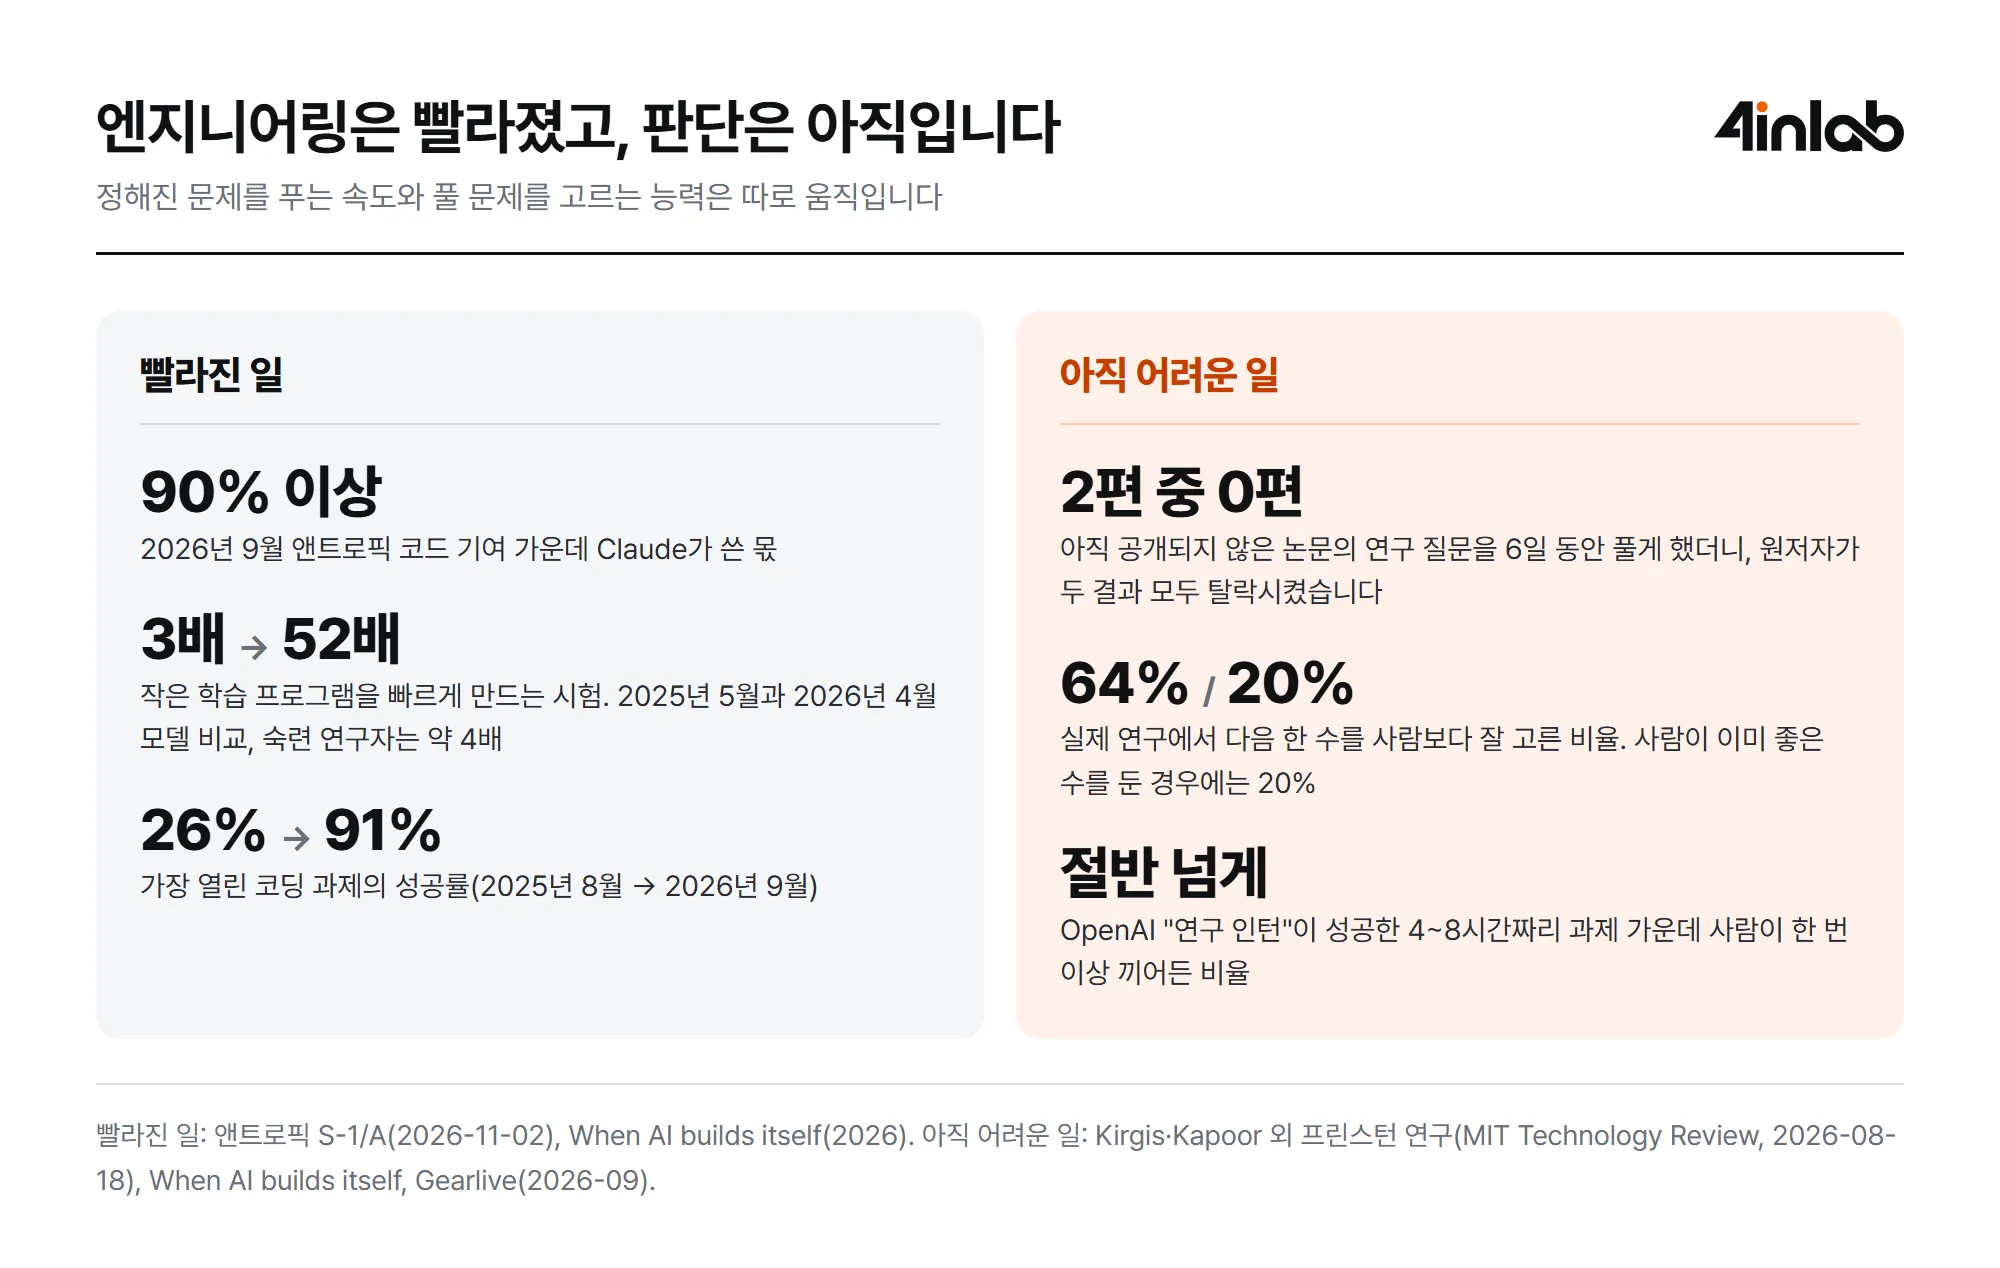
정해진 문제를 푸는 속도는 눈에 띄게 빨라졌습니다. When AI builds itself에 따르면, 작은 학습 프로그램을 더 빠르게 만드는 시험에서 2025년 5월 모델은 약 3배, 2026년 4월 모델은 약 52배의 속도 향상을 냈습니다. 같은 일을 숙련 연구자가 4~8시간 하면 약 4배입니다. 가장 열린 코딩 과제의 성공률도 2025년 8월 약 26%에서 2026년 9월 91%로 올랐습니다.
다른 곳에서도 비슷한 소식이 이어집니다.
| 누가 | 무엇을 했나 | 사람의 역할 |
|---|---|---|
| OpenAI | 9월 6일 "AI 연구 인턴" 목표 달성 발표. 숙련 연구자가 며칠 걸릴 잘 정의된 연구 과제를 수행 | 과제를 정하고 지시. 성공한 4~8시간 과제의 절반 넘게 사람이 한 번 이상 개입 |
| AIDE² 연구진 | 연구 에이전트가 8일 동안 자기 코드를 일곱 번 고쳐, 처음 보는 벤치마크 4개에서 사람이 만든 강한 에이전트와 같거나 앞섬 | 시험할 과제와 평가 방식을 설계 |
| Sakana AI | AI 개발 과정을 AI로 다시 설계하는 RSI 연구소를 열었고, 9월에 Jürgen Schmidhuber가 수석 과학 고문으로 합류 | 연구 방향과 안전장치 설계 |
표 1. 2026년 하반기 RSI 관련 발표와 연구입니다. 출처: Gearlive (새 탭에서 열림), AIDE² (새 탭에서 열림), Sakana AI (새 탭에서 열림)
공통점이 보입니다. AI가 맡는 일의 크기는 몇 분짜리에서 며칠짜리로 커졌지만, 어떤 과제를 풀지와 무엇으로 평가할지는 여전히 사람이 정합니다. OpenAI의 수치도 내부 측정이라 밖에서 확인할 수는 없습니다. 지난 가중치 편집 글에서 다룬 연구도 앞으로의 쓰임새로 RSI를 들었지만, 고칠 목표는 사람이 줬습니다.
무엇이 아직 안 될까요?
풀 문제를 고르는 일입니다. 8월에 나온 프린스턴 연구가 이를 보여 줍니다(MIT Technology Review (새 탭에서 열림)). 연구진은 아직 공개되지 않은 NeurIPS 2026 제출 논문 두 편의 연구 질문을 Claude Opus 4.8 기반 에이전트에게 줬습니다. 외워서 풀 수 없게 한 것입니다. 에이전트는 6일, API 비용 3,000달러, GPU와 인터넷을 받았습니다.
결과는 두 편 모두 원저자에게 탈락했습니다. 문헌을 찾고 실험을 수백 번 돌리고 결과를 정리하는 일은 잘했습니다. 하지만 약한 방법에 너무 일찍 매달렸고, 적은 데이터만 보고 좋은 가설을 버렸습니다. 막히면 방법을 다시 생각하는 대신 주장을 좁히고 단서를 붙였습니다. 논문 두 편뿐인 작은 실험이지만, 앤트로픽 공동창업자 Jack Clark도 이 결과를 짧은 RSI 시간표에 대한 약세 신호라고 평가했습니다.
앤트로픽의 자체 측정도 같은 곳을 가리킵니다. 실제 연구 과정에서 다음에 무엇을 할지 고르게 했더니, 최신 모델의 제안이 사람보다 낫다고 판정된 경우는 64%였습니다. 사람이 이미 좋은 수를 둔 경우만 보면 약 20%로 떨어졌습니다. 앤트로픽은 어떤 문제가 중요한지 고르는 판단을 지금의 AI와 스스로 후속 모델을 설계하는 AI 사이의 가장 큰 차이로 꼽습니다.
출처: 앤트로픽 증권신고서와 When AI builds itself, MIT Technology Review (새 탭에서 열림), Gearlive (새 탭에서 열림)를 바탕으로 정리
AI는 정해진 문제를 사람보다 빨리 풀기 시작했지만, 어떤 문제를 풀지 고르는 일은 아직 사람의 몫입니다.
그런데 왜 지금 경고할까요?
닫힌 고리가 아직 멀어 보이는데도 앤트로픽이 경고하는 이유는 신고서의 한 문장에 있습니다. 가속은 지나고 나서야 보인다는 것입니다. 측정이 늦다면, 기준선을 넘었는지 확인하는 순간에는 이미 넘은 뒤일 수 있습니다.
앤트로픽은 앞으로 세 가지 길을 그립니다. 첫째는 추세가 멈추고 지금의 능력이 널리 퍼지는 길인데, 가능성은 낮게 봅니다. 둘째는 개발 대부분이 자동화되고 사람이 방향을 정하는 길로, 가장 가능성이 높다고 봅니다. 이 경우 병목은 사람의 리뷰 같은 곳으로 옮겨 갑니다. 셋째가 AI가 스스로를 설계하고 개선하는 완전한 RSI입니다. 앤트로픽은 이 경우 AI의 목표를 사람의 뜻에 맞추는 일이 어떻게 될지 가장 불확실하다고 적었습니다.
그래서 필요하면 개발을 늦추거나 잠시 멈출 수 있는 선택지를 세계가 갖는 것이 좋다고 제안합니다. 한 회사만 멈추면 효과가 작으니, 여러 나라의 여러 연구소가 같은 조건에 합의하고 그것을 확인할 체계가 필요하다고 덧붙입니다.
그러니 처음 질문에는 이렇게 답할 수 있습니다. 사람 없이 돌아가는 닫힌 고리는 아직 코앞이 아닙니다. 하지만 개발 대부분을 AI가 맡고 사람이 방향을 잡는 두 번째 길은 이미 시작됐습니다.
우리 일은 어떤게 달라질까요?
두 번째 길은 AI 연구소만의 이야기가 아닙니다. AI 에이전트로 개발하고 운영하는 팀이라면 같은 변화를 이미 겪고 있습니다. 코드는 AI가 쓰는데 리뷰가 밀리고, 에이전트가 할 수 있는 일은 늘었는데 무엇을 시킬지 정하는 일은 여전히 사람에게 남습니다.
출처: Cloud Security Alliance (새 탭에서 열림)의 권고와 앤트로픽 When AI builds itself를 바탕으로 정리
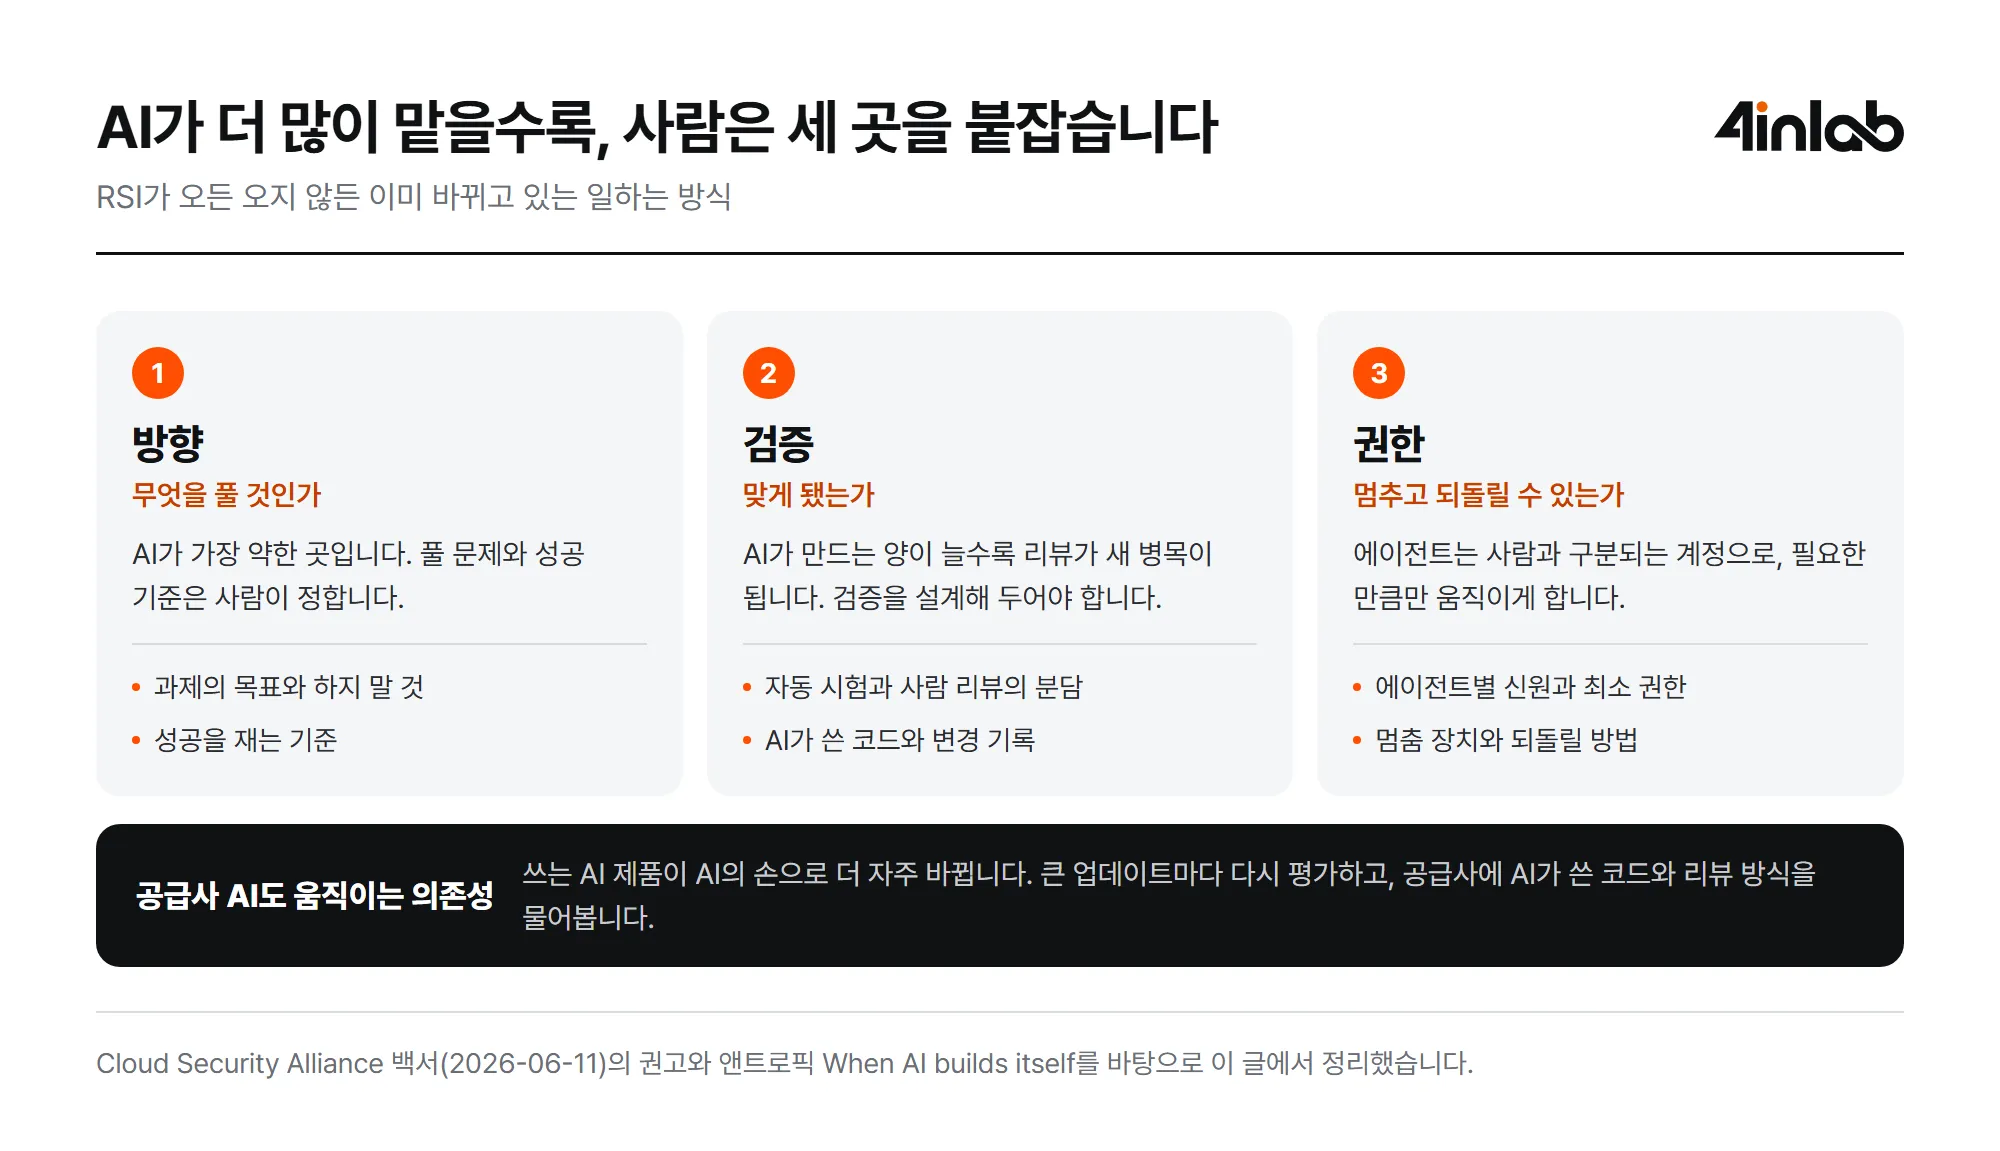
- 방향: AI가 가장 약한 곳입니다. 과제의 목표와 하지 말아야 할 일, 성공을 재는 기준은 사람이 정해 줘야 합니다.
- 검증: AI가 만드는 양이 늘수록 리뷰가 새 병목이 됩니다. 자동 시험과 사람 리뷰가 무엇을 나눠 볼지 미리 정해 두고, AI가 쓴 코드와 변경을 기록해야 합니다. 하네스 엔지니어링 글에서 다룬 이야기와 이어집니다.
- 권한: 에이전트는 사람과 구분되는 계정으로 필요한 만큼만 움직이게 하고, 멈추고 되돌릴 길을 남겨 둡니다. 상시 에이전트 글에서 다룬 살피기와 행동의 분리도 같은 맥락입니다.
하나 더 있습니다. 우리가 쓰는 AI 제품도 점점 AI의 손으로 더 자주 바뀝니다. CSA는 공급사의 AI 제품을 한 번 평가하고 끝낼 대상이 아니라 계속 움직이는 의존성으로 보라고 권합니다. 큰 업데이트가 나올 때마다 다시 평가하고, 공급사에 AI가 쓴 코드의 비율과 사람의 리뷰 방식, 능력이 바뀔 때 어떻게 알리는지를 물어보라는 것입니다.
RSI가 언제 올지는 아무도 장담하지 못합니다. 다만 AI가 일을 더 많이 맡을수록 사람이 붙잡아야 할 곳은 분명해지고 있습니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
AI 에이전트의 분석을 현장의 업무로 연결하려면
AI가 이상을 찾아낸 뒤에도 현장에는 확인하고 결정할 일이 남습니다. OpenBot 1.0을 사례로, 에이전트의 분석이 사람의 판단과 후속 업무로 이어지려면 무엇이 필요한지 살펴봅니다.
AI 에이전트가 일하는 곳은 어디일까요?
AI 에이전트는 이제 답만 하지 않고 코드를 돌리고, 브라우저를 몰고, 사내 시스템에 접근합니다. 그 일은 어디서, 무엇을 쥐고 해야 할까요? 에이전트가 일하는 구조부터 짚고, 구글이 공개한 Agent Compute Engine의 설계를 살펴봅니다.