야생마처럼 똑똑해지는 AI에 하네스 엔지니어링으로 고삐 걸기
AI가 여러 단계의 일을 맡으며 드러난 문맥과 진행 상태, 도구 실패와 완료 검증의 문제를 통해 하네스 엔지니어링이 필요한 이유를 살펴봅니다.
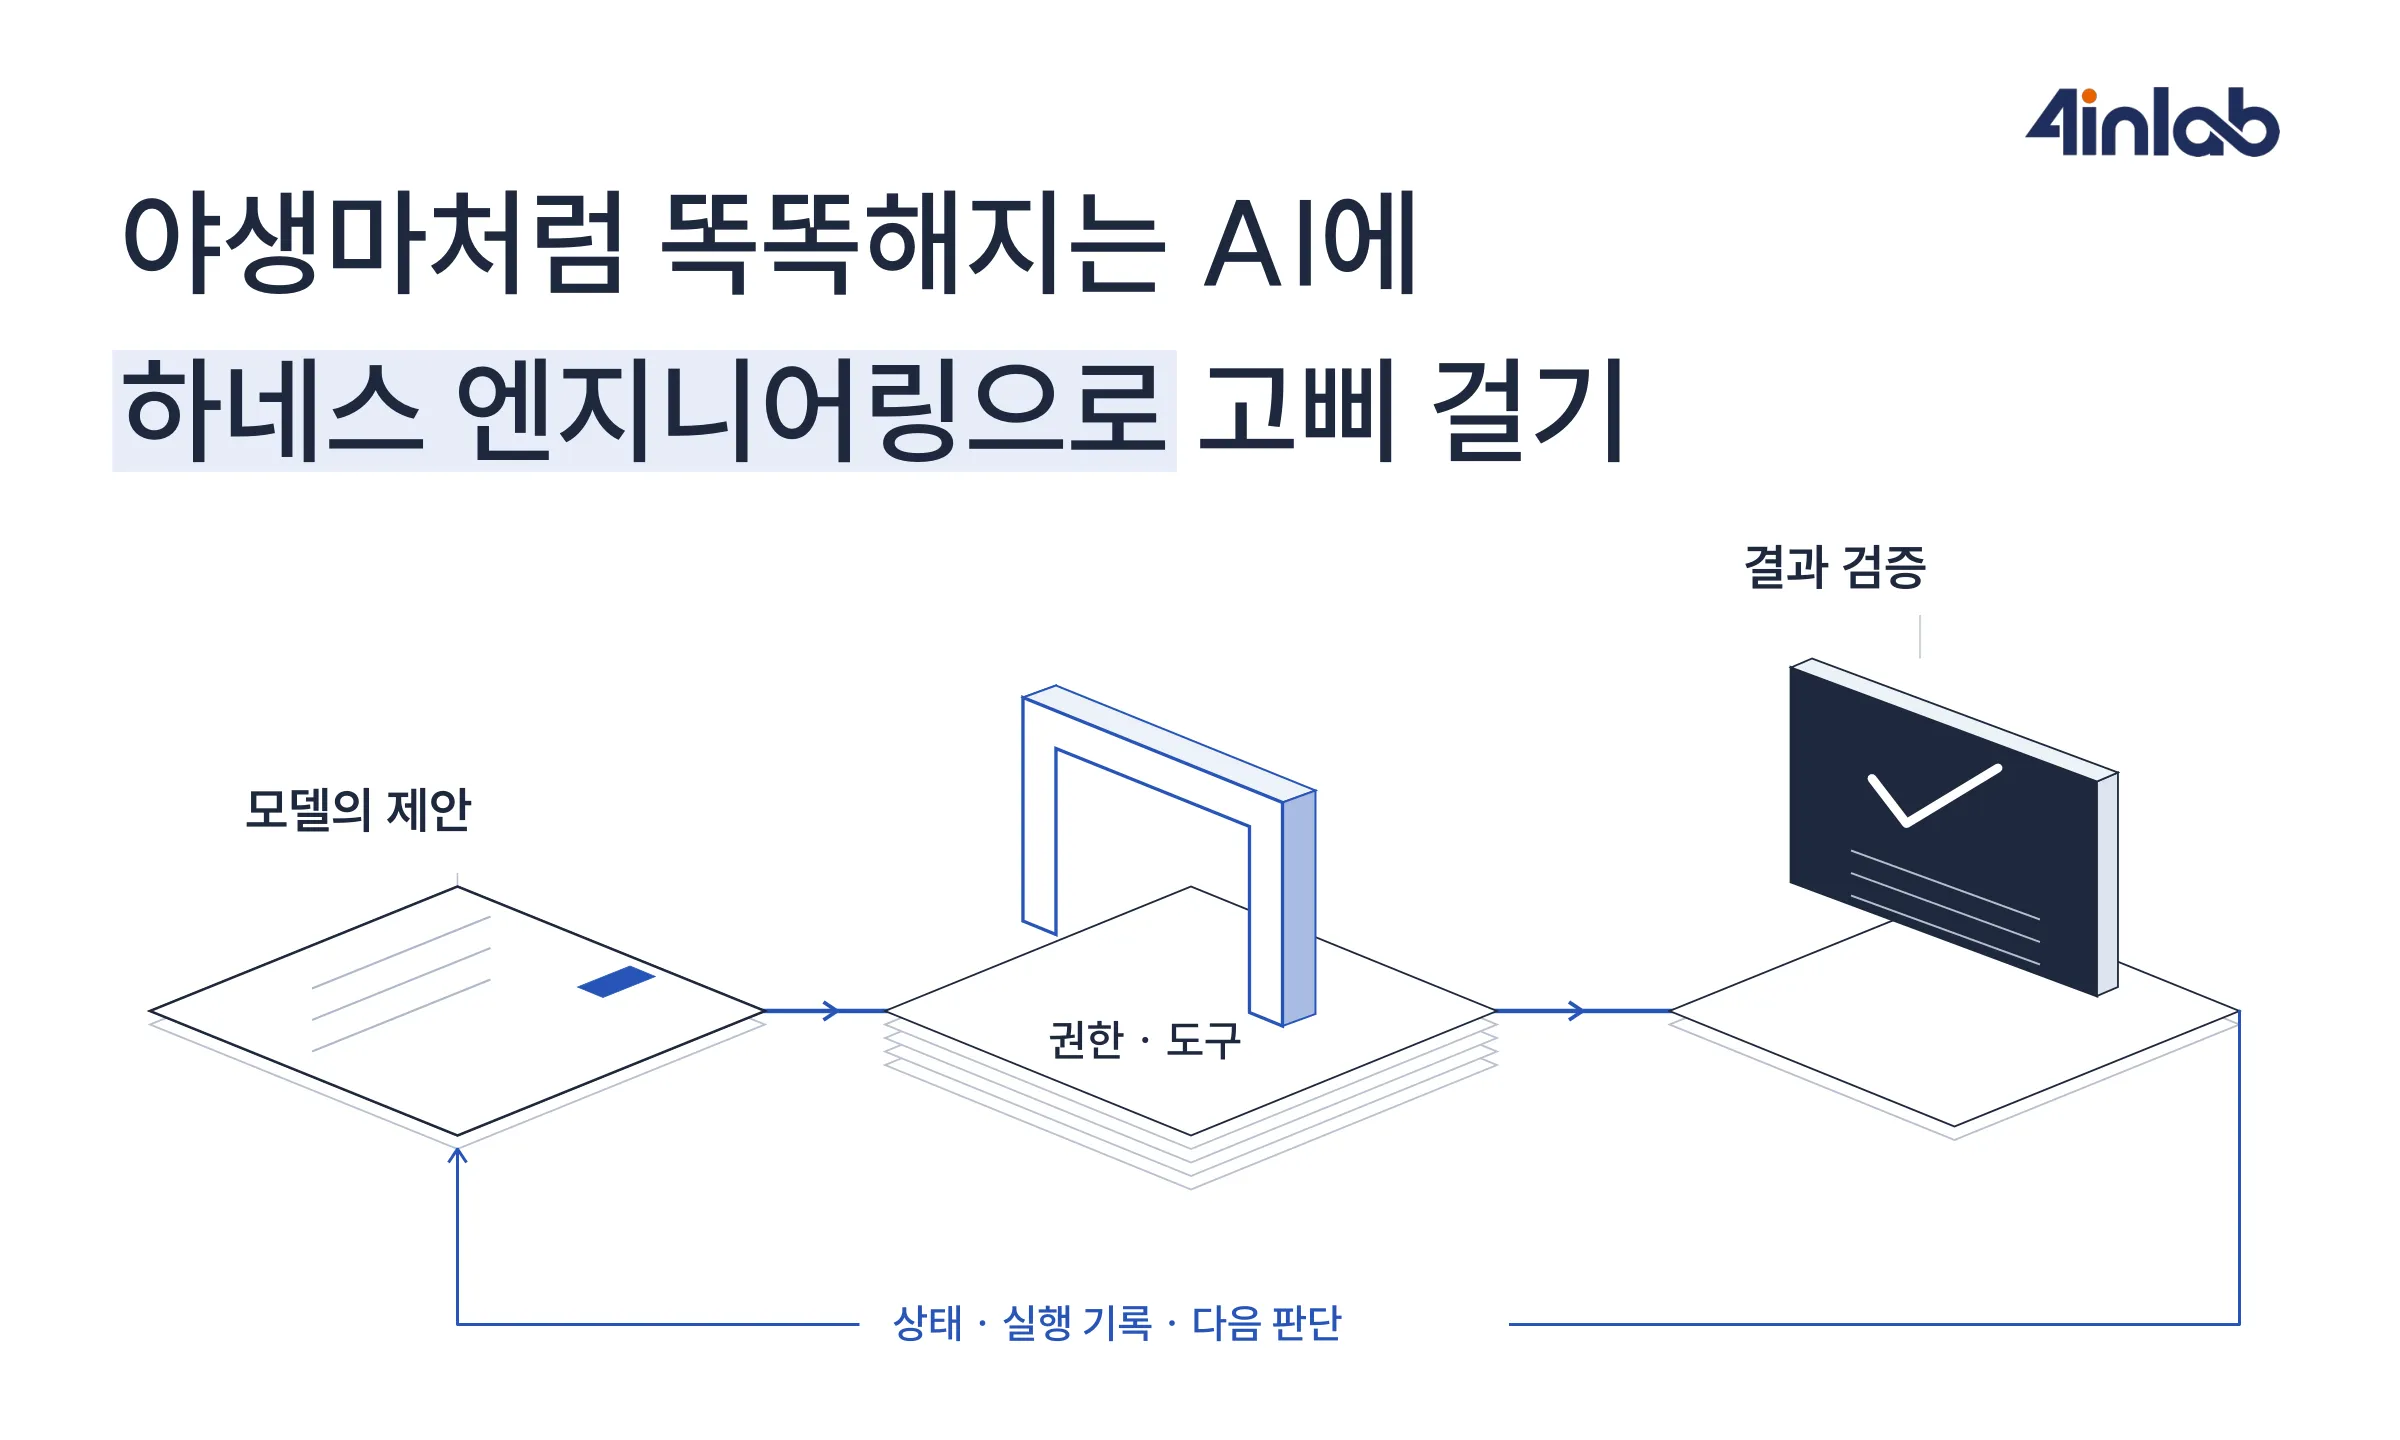
AI가 갈수록 똑똑해지는 모습을 보면, 힘껏 달릴 준비가 된 야생마가 떠오르기도 합니다. 그런데 달릴 힘이 있다는 것과 원하는 곳에 도착하는 것은 조금 다른 문제겠죠.
질문에 답하던 AI가 이제는 코드를 수정하고, 도구를 호출하고, 여러 단계를 거쳐 결과물을 만듭니다. 할 수 있는 일이 많아질수록 기대도 커집니다. 그런데 모델이 똑똑해졌다고 해서 맡긴 일이 항상 끝까지 잘 마무리되는 것은 아닙니다.
길어진 작업에서 앞선 진행 상황을 놓치거나, 도구가 실패했는데도 다음 단계로 넘어가거나, 확인하지 않은 결과를 두고 “완료했습니다”라고 답할 수 있습니다. 이런 문제를 만날 때마다 프롬프트에 주의사항을 한 줄씩 더 넣으면 충분할까요?
하네스 엔지니어링이 주목받는 배경을 이해하려면, AI에게 맡기는 일이 어떻게 달라졌는지부터 볼 필요가 있습니다. 이번 글에서는 공개된 에이전트 개발 사례를 바탕으로, 모델 바깥의 실행 환경이 왜 중요해졌는지 살펴보겠습니다.
답변 한 번에서 여러 단계의 작업으로
챗봇에 질문하고 답변을 받는 상황에서는 눈앞의 응답을 읽어 보는 것이 평가의 출발점입니다. 에이전트에게 작업을 맡기면 확인할 범위가 넓어집니다. 계획에 따라 도구를 호출했는지, 호출 결과를 제대로 읽었는지, 다음 단계에 필요한 상태를 이어받았는지, 마지막에 실제 결과물이 남았는지까지 봐야 합니다.
코드 수정을 예로 들면 ‘수정 방법을 설명하는 답변’과 ‘파일을 고치고 테스트를 실행해 검토 가능한 변경을 남기는 작업’은 다릅니다. 후자에서는 모델의 설명이 설득력 있어도 테스트를 실행하지 않았거나, 다른 파일을 수정했다면 작업을 제대로 끝냈다고 보기 어렵습니다.
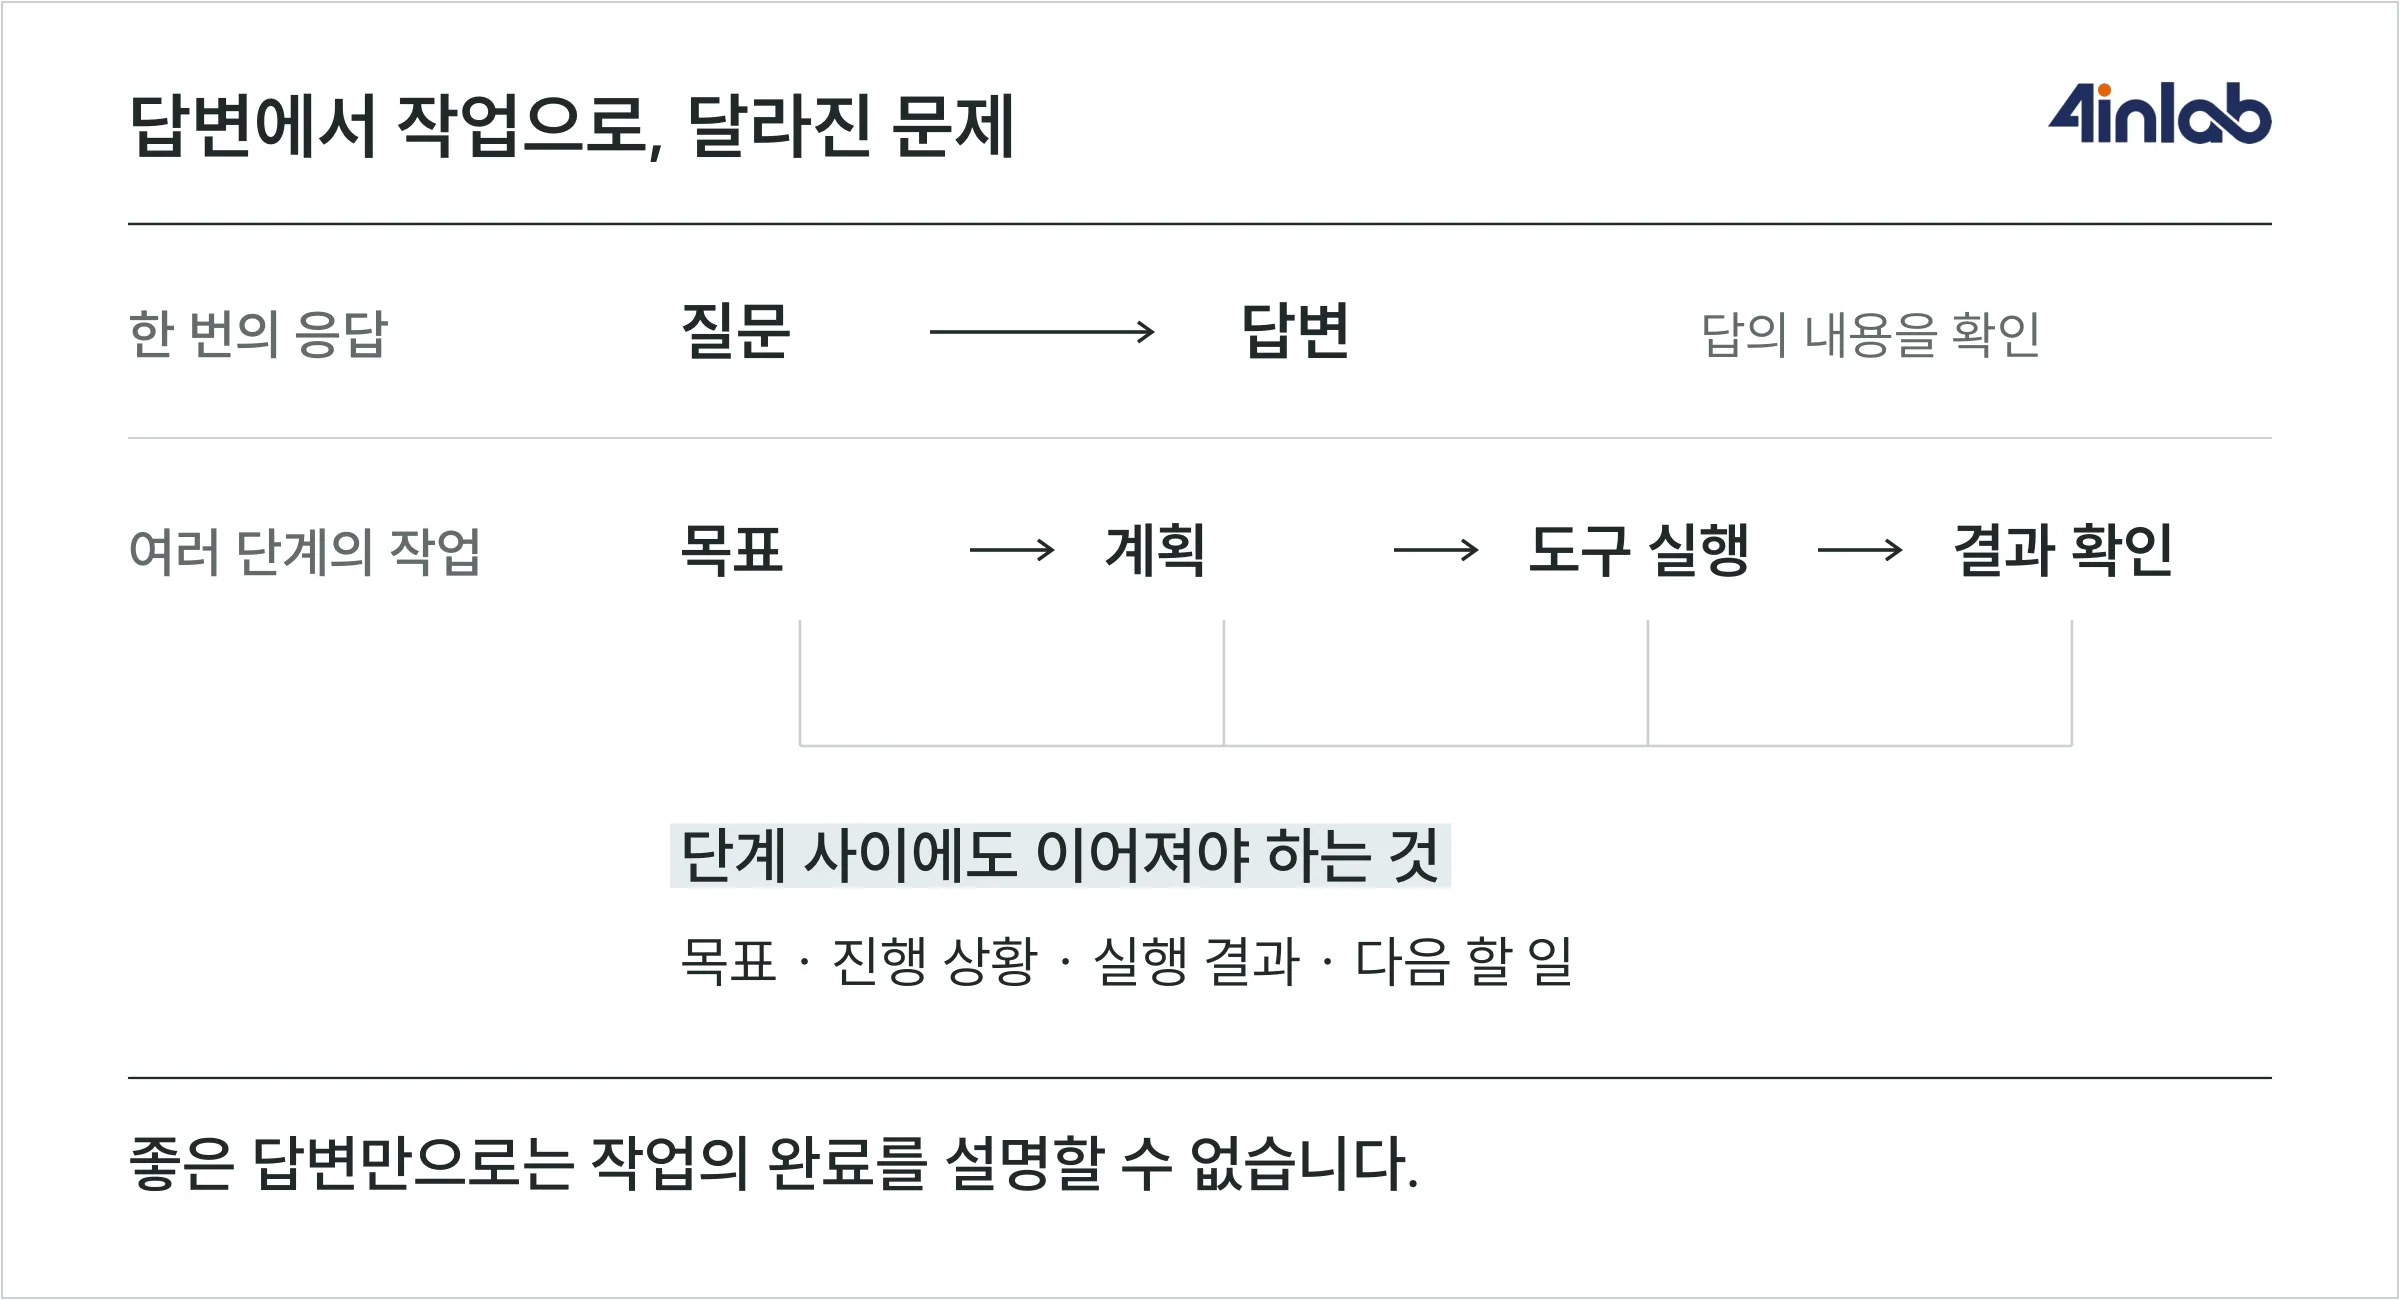
이 변화는 모델의 능력이 덜 중요해졌다는 뜻이 아닙니다. 모델의 능력을 실제 작업 결과로 연결하려면, 모델을 둘러싼 소프트웨어도 함께 설계해야 한다는 뜻입니다. 어떤 정보를 보여 줄지, 어느 도구를 허용할지, 실패하면 어떻게 멈추거나 재개할지 같은 문제입니다.
긴 작업에서 드러난 빈틈
Anthropic은 장기 실행 에이전트를 개발하면서 관찰한 어려움을 공개했습니다. 한 번의 문맥 안에서 모든 일을 하려다 실행이 끝나 버리거나, 다음 세션이 이전 작업의 상태를 제대로 파악하지 못하거나, 일부 진척만 보고 작업이 끝났다고 판단하는 문제입니다. 코딩 에이전트에서 관찰한 사례지만, 모델 호출 바깥의 설계가 필요한 이유를 보여 줍니다. Anthropic 장기 실행 에이전트의 하네스 설계 (새 탭에서 열림)
대응도 ‘더 강한 모델’ 하나로 끝나지 않았습니다. 초기 환경을 준비하고, 해야 할 기능을 목록으로 남기고, 진행 기록과 변경 내역을 다음 세션에 전달하며, 실제 동작을 테스트하도록 실행 환경을 구성했습니다. 핵심은 매번 새로 시작하는 모델 호출 사이에 작업의 연속성을 만들어 주는 데 있습니다. Anthropic 장기 실행 에이전트의 하네스 설계 (새 탭에서 열림)
OpenAI의 하네스 엔지니어링 글도 코딩 에이전트가 작업할 수 있는 저장소와 도구, 읽을 수 있는 문서, 피드백 경로를 설계하는 엔지니어링을 다룹니다. 두 사례를 함께 보면, 에이전트가 이해하고 실행하고 확인할 수 있는 환경을 만드는 일이 중요한 개발 과제로 부각됐다는 공통점을 읽을 수 있습니다. OpenAI 하네스 엔지니어링 사례 (새 탭에서 열림)
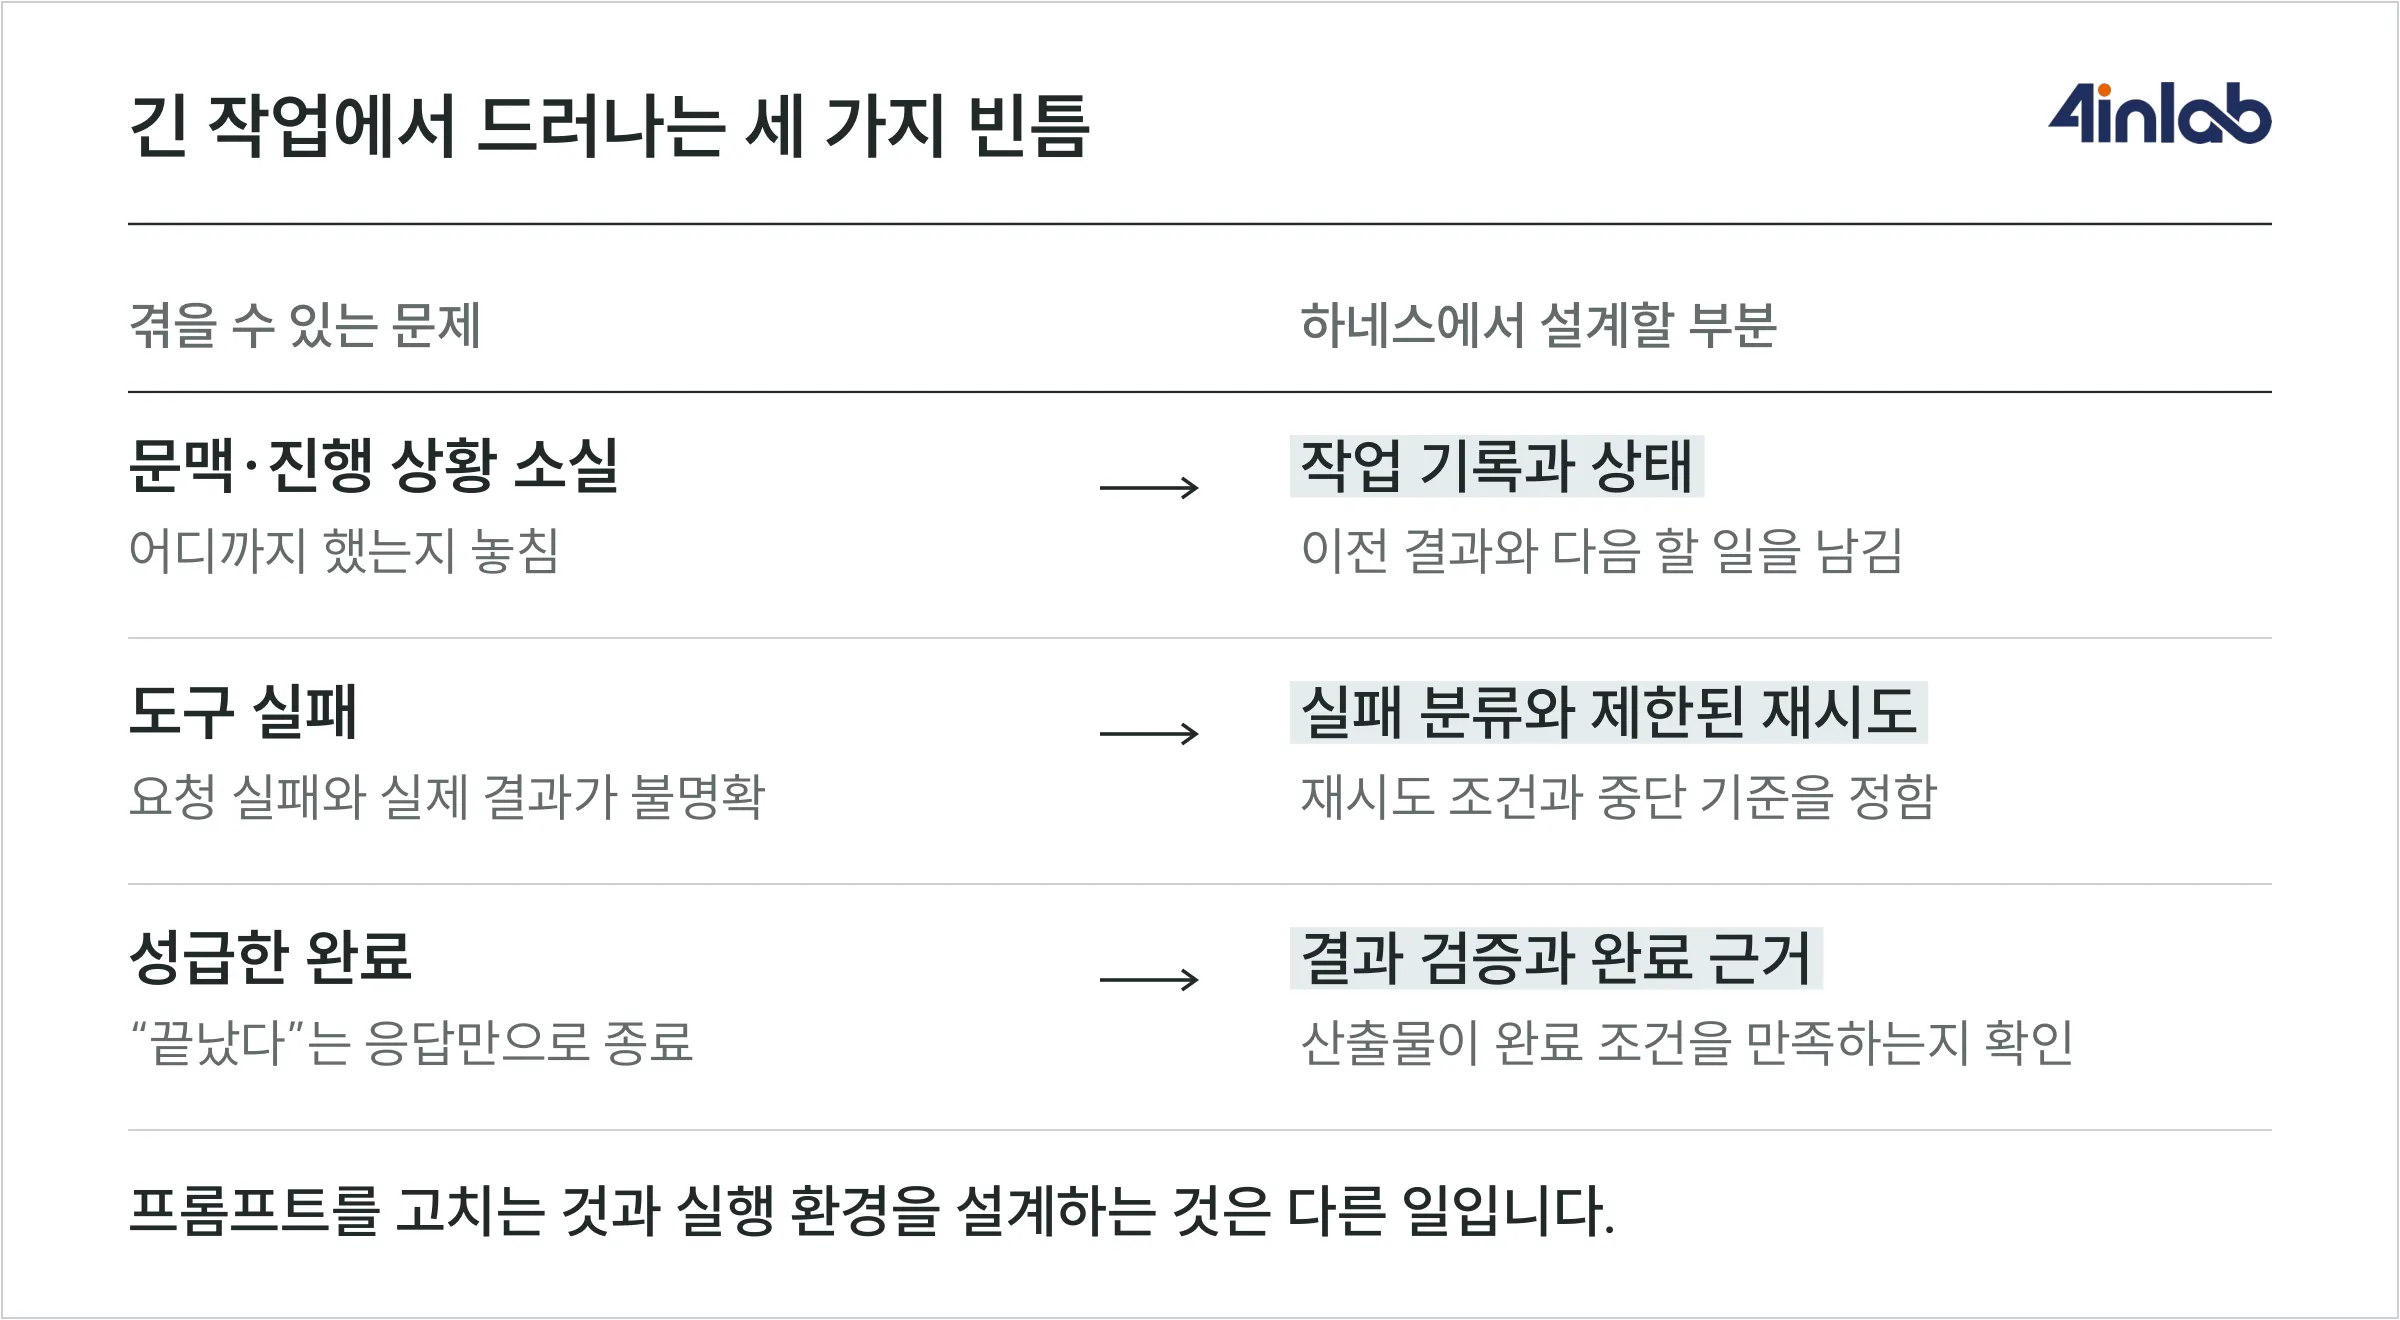
그래서 하네스 엔지니어링을 단순히 AI를 억제하는 장치로만 보면 설명이 부족합니다. 할 수 없는 행동의 경계를 정하는 동시에, 필요한 정보와 도구를 제공하고 결과를 확인할 수 있게 해 일을 이어 가도록 돕는 설계이기도 합니다.
논문에서는 인터페이스를 어떻게 바꿨을까요
2024년 SWE-agent 논문은 모델이 컴퓨터를 사용하는 인터페이스인 ACI를 연구했습니다. 사용할 명령과 실행 결과의 피드백 형식을 함께 설계합니다. SWE-agent 논문 (새 탭에서 열림)
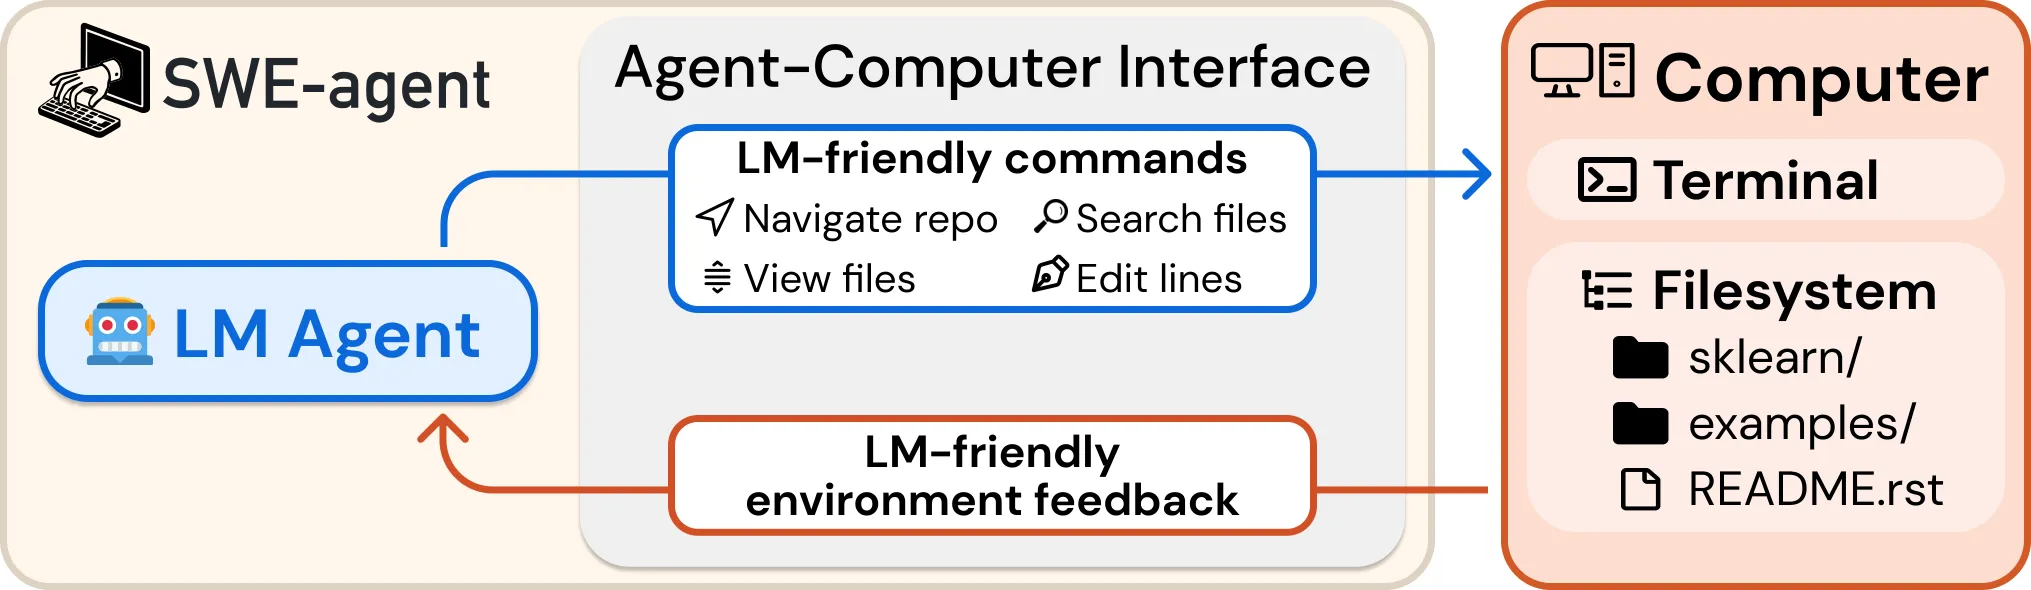
출처: Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering (2024), 원문 Figure 1 (새 탭에서 열림), CC BY 4.0 (새 탭에서 열림). 원본 이미지 확대 (새 탭에서 열림)
아래쪽 화살표는 실행 결과가 모델로 돌아오는 경로입니다. 도구 연결뿐 아니라 다음 판단에 필요한 피드백도 중요하다는 뜻이죠. ACI가 하네스 전체와 같은 개념은 아니지만, 주변 설계의 구체적인 사례로 볼 수 있습니다.
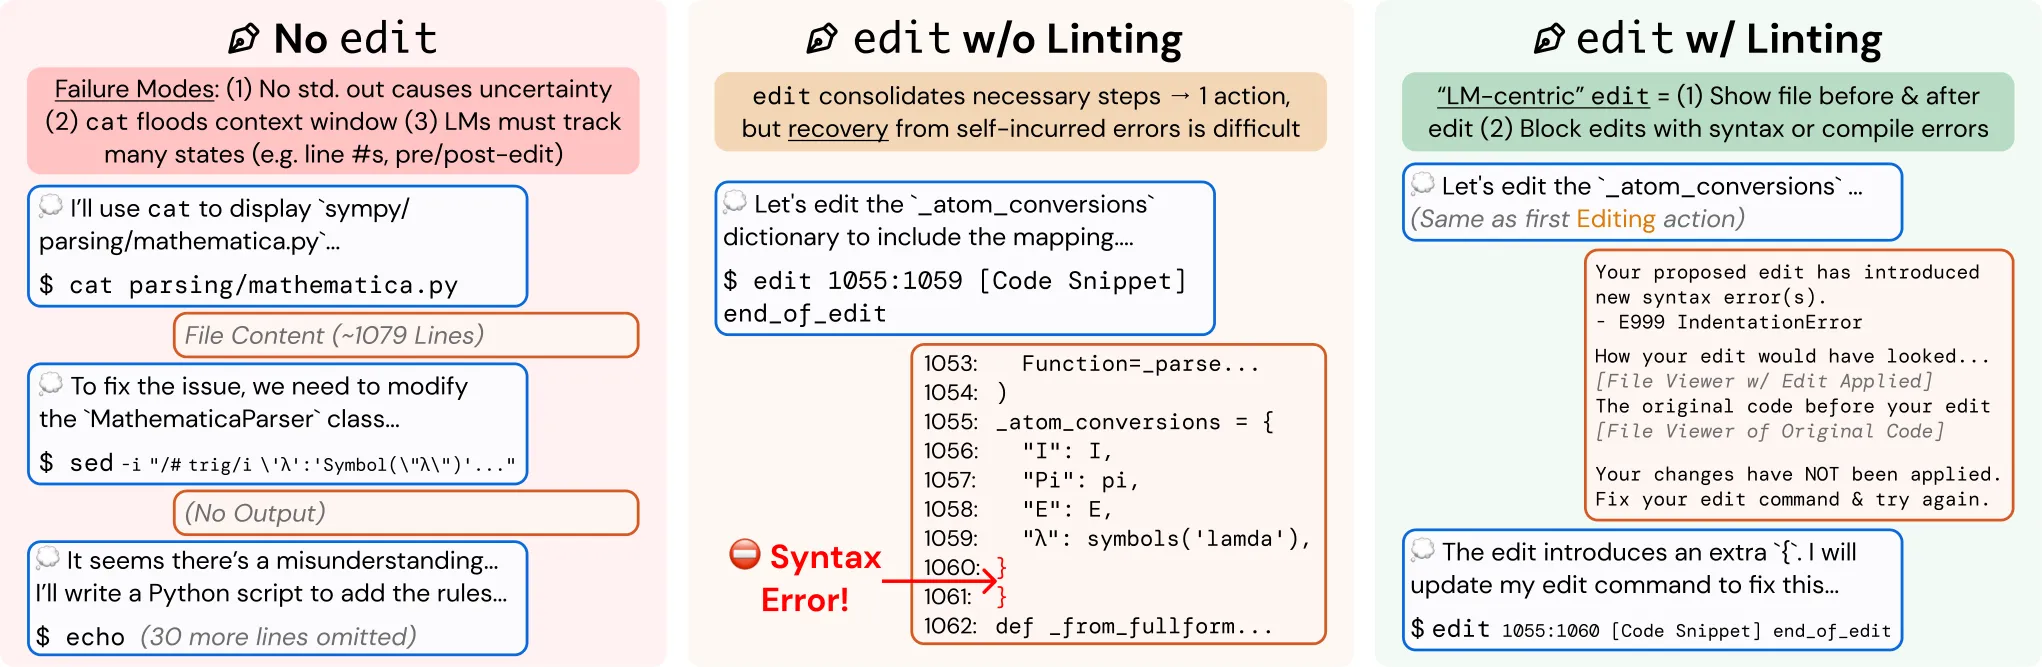
출처: Yang et al., SWE-agent (2024), 원문 Figure 6 (새 탭에서 열림), CC BY 4.0 (새 탭에서 열림). 원본 이미지 확대 (새 탭에서 열림)
두 번째 그림은 왼쪽부터 셸 명령으로 여러 번 편집하는 방식, 전용 편집 명령, 린트 검사를 더한 편집 명령입니다. 가운데에서는 편집 후 문법 오류가 생깁니다. 오른쪽은 오류가 있는 변경을 적용하지 않고, 수정할 정보를 돌려줍니다. 모델에게 주의를 당부하는 데서 나아가 복구할 경로를 마련한 셈입니다. 물론 문법 검사만으로 기능 완성을 보장하지는 않습니다. 편집 인터페이스와 린트 검사 설명 (새 탭에서 열림)
완료라는 말을 어디까지 믿어도 될까요
이해를 돕기 위해 가상의 로봇 시뮬레이션 로그 작업을 떠올려 보겠습니다. 실행 로그를 읽고 실패한 테스트 수를 정리하는 에이전트입니다. 실제 장비를 움직이는 일은 없고, 이미 만들어진 결과를 읽어 사람이 검토할 초안을 만드는 작업입니다.
요청 자체는 짧습니다. “이번 실행 결과를 정리해 줘.” 하지만 구현하는 입장에서는 몇 가지가 더 필요합니다. 어느 실행의 로그를 읽을까요? 파일을 끝까지 읽지 못하면 어떻게 할까요? 오래된 로그를 읽고도 최신 결과라고 말하지는 않을까요? 보고서에 적힌 전체 건수와 실패 건수가 원본과 맞는지도 확인해야 합니다.
여기서 ‘완료’는 한 문장보다 구체적이어야 합니다. 예를 들어 ‘지정한 실행의 로그를 읽었고, 필수 항목을 검사했으며, 원본에서 계산한 건수를 담은 초안을 만들었다’까지를 이번 작업의 완료 조건으로 둘 수 있습니다. 초안 생성 완료와 사람의 검토 완료는 서로 다른 상태로 남겨 둡니다.
완료 기준을 먼저 적어 두면, 무엇을 더 잘 말하게 할지보다 무엇을 확인해야 할지가 보입니다.
모델에게 모든 확인을 맡길 필요는 없습니다. 실행 ID의 일치, 필수 필드, 건수처럼 코드로 명확하게 검사할 수 있는 것은 코드로 확인하는 편이 낫습니다.
모델 주변에는 어떤 일이 남아 있을까요
하네스라는 말의 범위는 글이나 구현에 따라 조금씩 다릅니다. 여기서는 모델을 호출하고, 필요한 정보와 도구를 제공하며, 실행 상태를 관리하고, 다음 단계와 종료 조건을 제어하는 주변 소프트웨어를 가리키겠습니다. 모든 AI 소프트웨어를 하나의 이름으로 묶기보다, 이번 작업에서 누가 어떤 책임을 맡는지 구체적으로 보는 편이 도움이 됩니다. OpenAI 에이전트 하네스의 역할 (새 탭에서 열림)
모델에는 “어떤 정보가 부족한가”, “허용된 다음 단계 중 무엇을 제안할까”처럼 문맥을 읽는 일을 맡길 수 있습니다. 하네스에는 ‘이 도구를 호출할 권한이 있는가’, ‘시간 한도를 넘었는가’, ‘필수 검증을 통과했는가’를 확인하는 규칙을 둡니다. 역할을 나눠도 모델의 판단이 언제나 맞는 것은 아니므로, 잘못 제안했을 때의 경로까지 필요합니다.
앞서 Agent Lightning을 살펴봤다면 비슷하게 느껴질 수도 있습니다. 에이전트의 실행을 기록하고 평가한다는 접점이 있기 때문입니다. 다만 이번 글의 초점은 주어진 모델로 작업을 어떻게 운영할지에 있습니다. Agent Lightning은 실제 하네스에서 에이전트를 실행하며 얻은 상호작용을 학습 데이터로 활용해 에이전트를 최적화하는 프레임워크입니다. 현재 v1.0의 공식 설명도 도구와 문맥, 제어 흐름, 환경을 학습 과정에 유지하는 점을 강조합니다. 운영 중 남긴 기록이 학습이나 평가의 재료가 될 수 있다는 점에서 연결되지만, 하네스와 Agent Lightning을 서로 대체하는 개념으로 볼 필요는 없습니다. Microsoft Agent Lightning 공식 저장소 (새 탭에서 열림)
작업을 맡기기 전에 정할 세 가지
무엇을 받아서 어디까지 할까요
‘계약’이라고 해서 복잡한 명세서부터 만들자는 것은 아닙니다. 이 작업에서 받아도 되는 입력, 사용할 수 있는 도구, 끝났다고 판단할 근거를 짧게 적어 보는 것입니다.
| 항목 | 가상 로그 요약 작업의 기준 |
|---|---|
| 입력 | 요청에서 지정한 시뮬레이션 실행의 로그 |
| 허용 도구 | 승인된 위치의 로그 읽기와 검토용 초안 생성 |
| 제외 작업 | 장비 명령 실행, 원본 수정, 외부 전송 |
| 검증 | 실행 ID와 필수 항목 확인, 전체·실패 건수 계산 |
| 종료 상태 | 검토 대기 또는 사유를 남긴 보류 |
표 1. 설명을 위한 실행 계약 예시입니다. 실제 업무에서는 데이터 접근 범위와 검증 기준을 별도로 정해야 합니다.
이렇게 적어 보면 프롬프트에 넣을 안내와 프로그램이 강제해야 할 조건이 구분됩니다. ‘원본을 수정하지 마세요’라고 설명하는 것과, 읽기 전용 권한만 제공하는 것은 다릅니다. 작업에 쓰지 않는 쓰기 도구를 처음부터 연결하지 않으면, 모델이 잘못된 행동을 제안해도 실행할 수 있는 범위가 줄어듭니다. OpenAI 에이전트 안전 설계 가이드 (새 탭에서 열림)
완료 조건도 가능하면 결과물과 연결합니다. ‘보고서를 작성했다’는 모델의 문장보다, 보고서가 존재하는지, 어떤 실행의 결과인지, 계산한 값이 원본과 맞는지 확인한 기록이 더 직접적인 근거가 됩니다. 물론 필드가 존재한다고 해서 해석까지 정확한 것은 아닙니다. 실패 원인을 설명하는 문장은 별도의 근거 검토가 필요할 수 있습니다.
중간에 멈추면 어디부터 다시 할까요
로그를 읽다가 연결이 끊기는 상황은 프롬프트의 표현만으로 막기 어렵습니다. 실행 중 무엇을 끝냈는지 남기고, 어떤 실패를 다시 시도해도 되는지 정해야 합니다.
예를 들어 ‘읽기 전 → 입력 확인 → 초안 생성 → 검토 대기’처럼 상태를 나눌 수 있습니다. 상태와 함께 입력의 식별자나 버전, 검증 결과를 저장하면 재개 시점에 같은 작업을 계속하는지 확인하기 쉬워집니다. Anthropic의 장기 실행 에이전트 글도 세션 사이에 진행 상황과 작업 상태를 명시적으로 남기는 방식을 설명합니다. 다만 그 글의 코딩 에이전트 사례가 모든 업무에 그대로 적용되는 것은 아닙니다. Anthropic 장기 실행 에이전트의 하네스 설계 (새 탭에서 열림)
재시도는 특히 구분해서 봐야 합니다. 읽기 요청의 일시적인 시간 초과와, 이미 외부에 반영됐을지도 모르는 쓰기 요청은 다릅니다. 후자를 확인 없이 반복하면 같은 요청이 두 번 반영될 수 있습니다. 재시도 가능한 실패를 좁히고, 횟수와 시간에 한도를 두며, 부작용이 있는 작업은 중복 실행 방지와 결과 조회를 함께 설계해야 합니다. AWS 시간 초과와 재시도 설계 (새 탭에서 열림)
상태를 저장했다고 자동으로 안전하게 재개되는 것은 아닙니다. 기록한 입력과 현재 입력이 달라졌다면 재검증이 필요할 수 있습니다. 오래된 승인으로 새 작업을 실행하지 않도록 승인 대상도 작업 내용과 버전에 연결해야 합니다. OpenAI 승인과 재개 설계 (새 탭에서 열림)
누가 무엇을 승인할까요
사람에게 확인을 받는 경로는 중요합니다. 다만 화면에 ‘승인’ 버튼을 붙였다고 충분해지는 것은 아닙니다. 검토하는 사람이 무엇을 허용하게 되는지 알아야 하니까요.
읽기 전용 초안을 검토하는 일과 외부 시스템에 변경을 반영하는 일은 부담이 다릅니다. 후자라면 대상, 변경 내용, 예상되는 영향, 취소 가능 여부를 확인할 수 있어야 합니다. 승인 뒤에 대상이나 내용이 바뀌면 다시 확인하도록 설계할 수 있습니다. 모델이 로그나 문서에서 읽은 문장을 새 명령으로 취급하지 않게 하는 경계도 필요합니다. 외부 입력에 담긴 지시문이 도구 사용으로 이어지는 프롬프트 인젝션 위험이 있기 때문입니다. OpenAI 에이전트 안전 설계 가이드 (새 탭에서 열림)
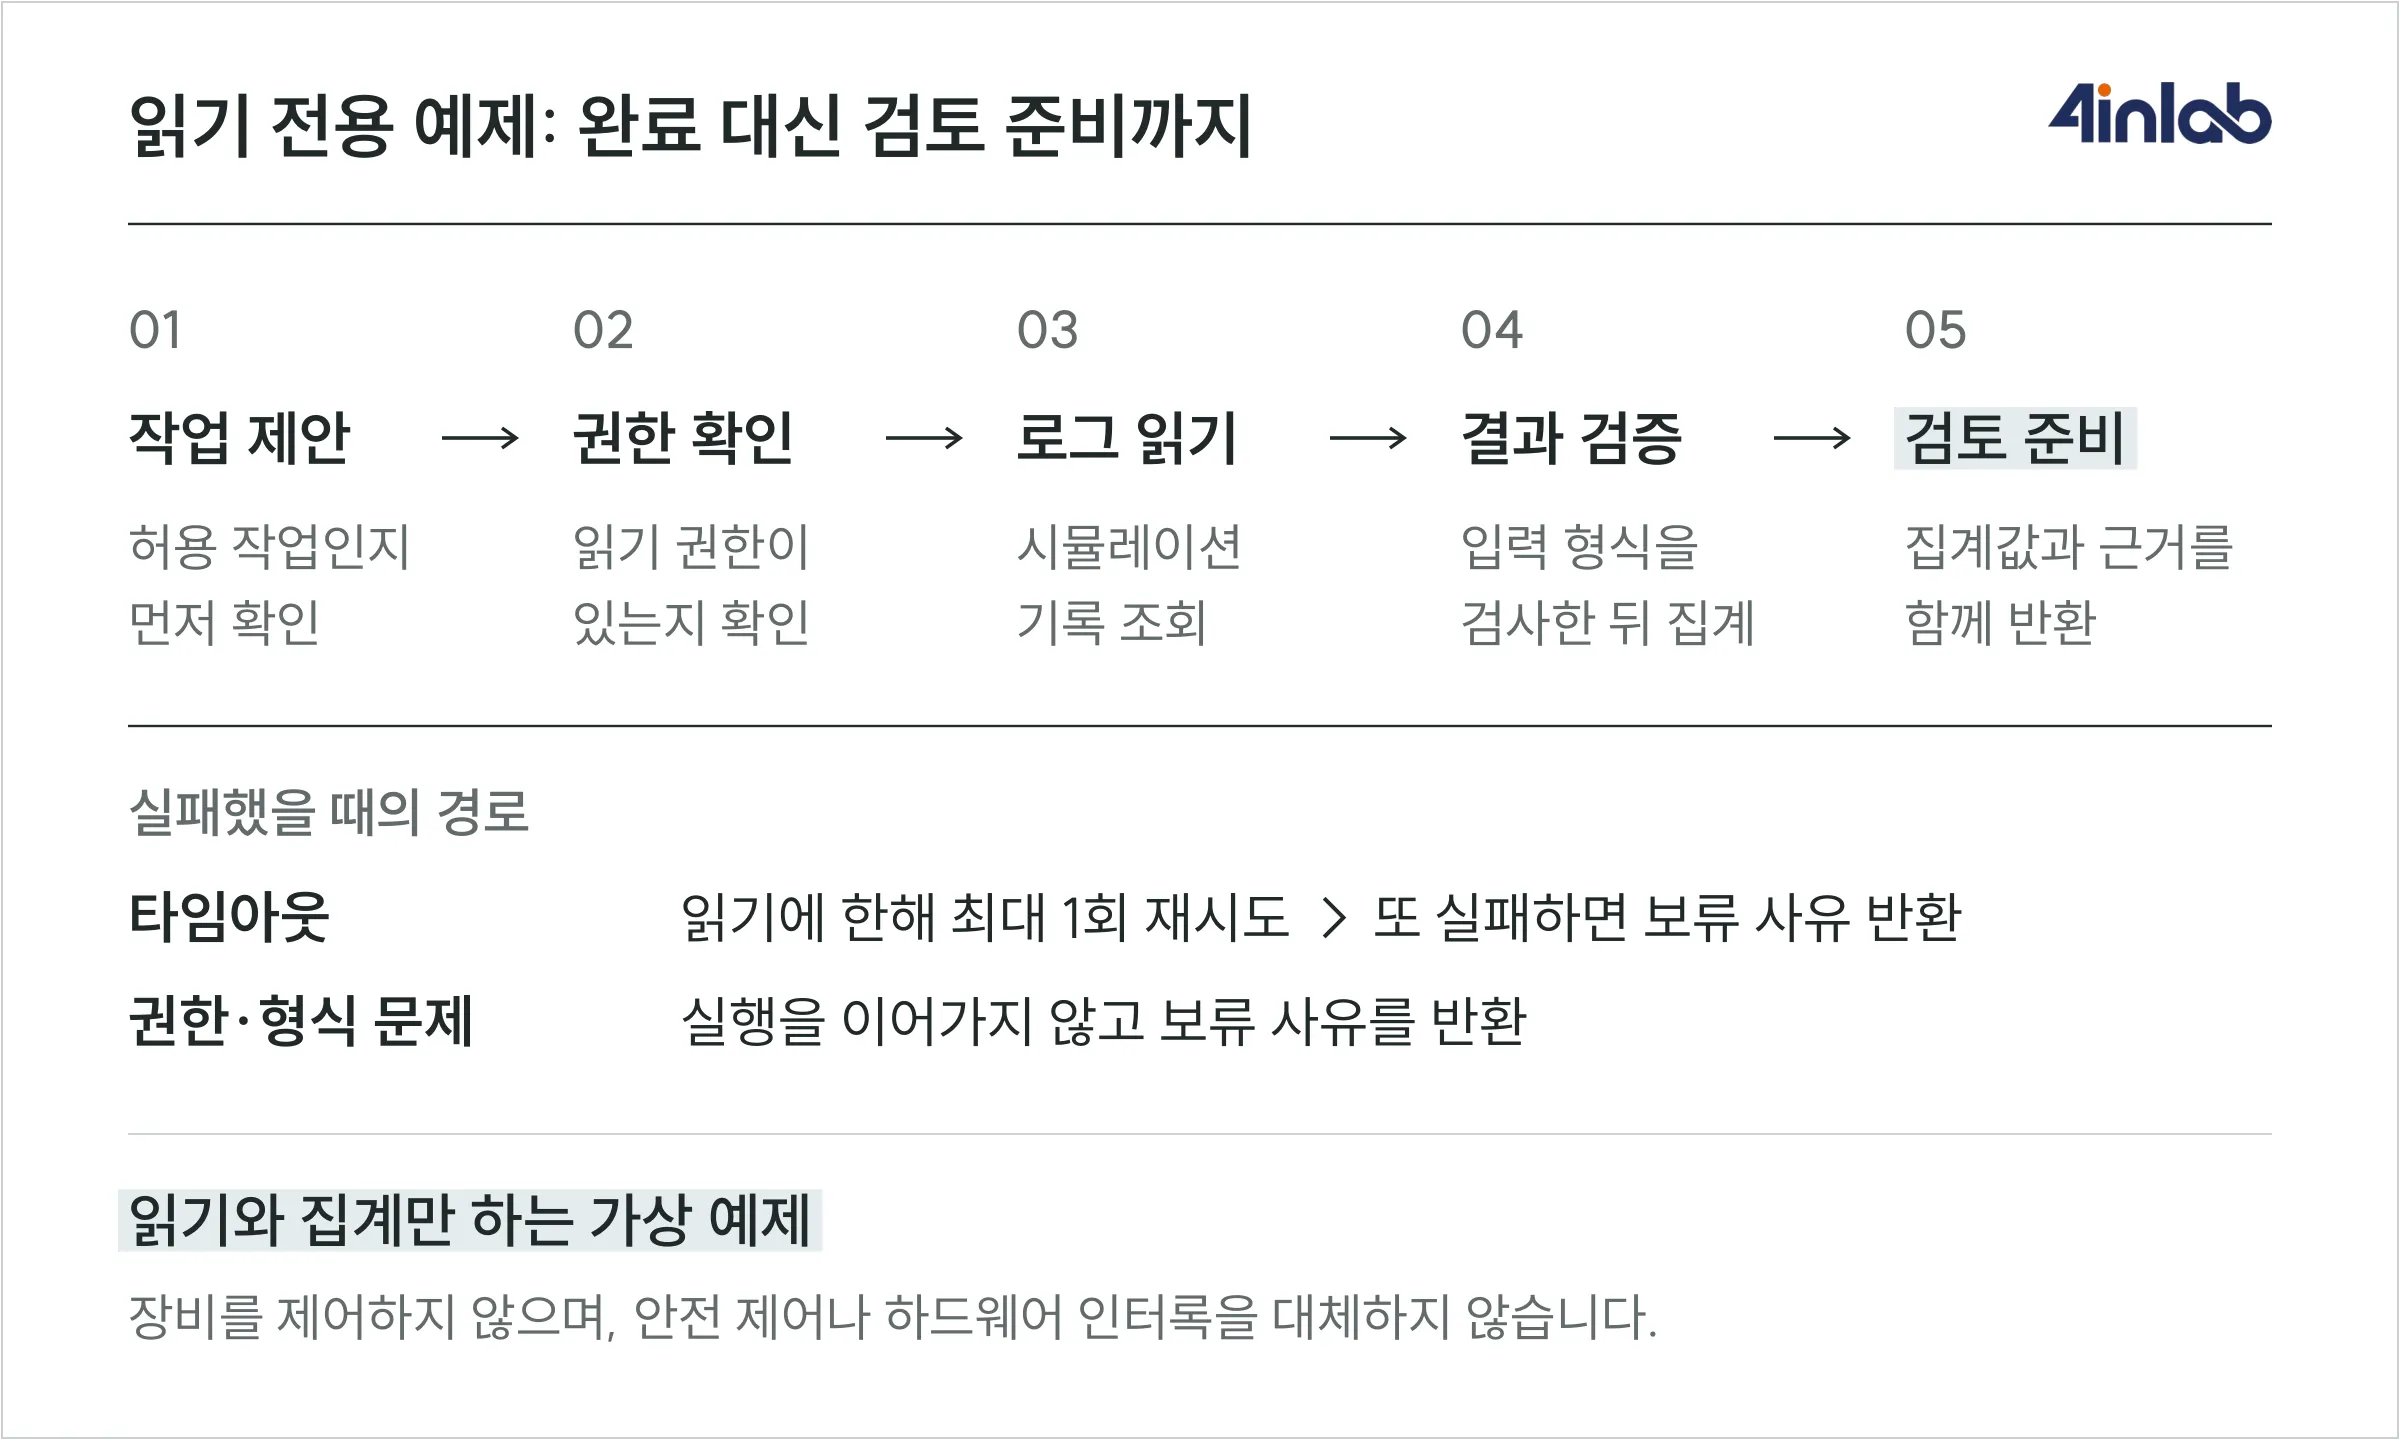
간단한 예제로 한번 확인해 볼까요?
아래 코드는 특정 모델이나 SDK 없이 실행할 수 있는 Python 예시입니다. 실제 로그 파일, 네트워크, 장비를 건드리지 않고 메모리 안의 가상 데이터를 읽습니다. proposal은 모델이 제안했다고 가정한 행동입니다.
핵심은 제안을 그대로 실행하지 않는 데 있습니다. 허용한 행동인지와 읽기 권한을 먼저 확인하고, 시간 초과만 한 번 재시도합니다. 입력 형식이 맞지 않으면 보류하고, 정상 입력이면 코드로 건수를 계산해 검토 대기 상태를 반환합니다.
"""SDK-free, read-only in-memory example. No devices, network or files."""

def run(proposal, read_log, can_read=True):
    # The proposal stands in for a model's tool choice.
    if proposal != "summarize_simulation" or not can_read:
        return {"state": "review", "reason": "permission_or_action"}
    for attempt in range(2):  # At most one retry, for this read only.
        try:
            rows = read_log()
            break
        except TimeoutError:
            if attempt == 1:
                return {"state": "review", "reason": "timeout"}
    if (not isinstance(rows, list) or not rows
        or any(not isinstance(r, dict)
               or r.get("result") not in ("pass", "fail")
               for r in rows)):
        return {"state": "review", "reason": "invalid_log"}
    total = len(rows)
    failed = sum(r["result"] == "fail" for r in rows)
    # Counts come from validated input, not a model's completion claim.
    return {"state": "ready_for_review",
            "report": f"전체 {total}건 중 실패 {failed}건",
            "evidence": {"total": total, "failed": failed}}


def fake_reader(timeouts=0, rows=None):
    calls = 0
    def read():
        nonlocal calls
        calls += 1
        if calls <= timeouts:
            raise TimeoutError("simulated")
        return rows if rows is not None else [
            {"result": "pass"}, {"result": "fail"}]
    return read


if __name__ == "__main__":
    print(run("summarize_simulation", fake_reader(timeouts=1)))
출력은 다음과 같습니다. 첫 읽기는 가상의 시간 초과를 내지만, 두 번째 읽기가 성공해 검토용 결과를 만듭니다.
{'state': 'ready_for_review',
 'report': '전체 2건 중 실패 1건',
 'evidence': {'total': 2, 'failed': 1}}
여기서 ready_for_review는 보고서의 모든 내용이 검증됐거나 사람이 승인했다는 뜻이 아닙니다. 예제는 애초에 자유로운 원인 분석 문장을 생성하지 않고, 입력에서 계산한 숫자만 씁니다. 이 덕분에 무엇을 검증했는지 좁고 분명하게 설명할 수 있습니다.
실제 구현에는 입력 출처와 실행 ID 확인, 인증된 접근 권한, 영속적인 상태 저장, 로그의 완전성 검사 등이 더 필요합니다. can_read도 인증 시스템이 아니라 권한 확인 결과를 단순화한 값입니다. 운영에 바로 쓰는 코드보다는, 모델 바깥에 어떤 규칙을 남길지 확인하는 출발점으로 보면 좋겠습니다.
잘됐을 때보다 실패했을 때를 먼저 봅니다
한 번 정상적으로 실행됐다는 사실만으로 하네스가 충분하다고 말하기는 어렵습니다. 실무에 가깝게 보려면 모델의 답변 품질과 함께, 실패했을 때 어느 상태로 이동했는지를 확인해야 합니다. Anthropic의 에이전트 평가 가이드는 최종 응답뿐 아니라 실행 과정과 환경에 남긴 결과를 구분해서 평가할 필요를 설명합니다. Anthropic 에이전트 평가 가이드 (새 탭에서 열림)
| 넣어 볼 상황 | 기대하는 동작 | 확인할 기록 |
|---|---|---|
| 정상 로그 | 검토용 결과 생성 | 원본에서 계산한 건수 |
| 한 번의 읽기 시간 초과 | 한 번 재시도 후 계속 | 호출 횟수와 다음 상태 |
| 반복되는 시간 초과 | 재시도 중단과 보류 | 중단 사유 |
| 권한 없음 또는 허용하지 않은 행동 | 읽기 전에 차단 | 도구가 호출되지 않았는지 |
| 빈 로그 또는 잘못된 필드 | 완료 처리하지 않기 | 입력 오류 사유 |
표 2. 예제 코드의 분기별 테스트 항목입니다.
위 코드는 정상 처리, 재시도 성공, 재시도 한도, 권한 차단, 허용 밖 행동, 빈 입력, 잘못된 상태값, 잘못된 자료형의 여덟 가지 테스트를 통과했습니다. 이는 작성한 코드 분기가 예상대로 동작했다는 뜻이며, 실제 에이전트의 성공률을 측정한 결과는 아닙니다.
실제 에이전트를 평가할 때는 같은 요청에서도 여러 실행이 다른 경로를 탈 수 있습니다. 정상 사례와 실패 사례를 함께 모으고, 모델이나 프롬프트, 도구 구성을 바꿀 때 다시 실행해 봐야 합니다. 성공률만 높아졌는지 보기보다 잘못 완료 처리한 비율, 검토로 넘긴 비율, 반복 호출 수와 처리 시간도 함께 보면 운영상의 변화가 드러납니다. 무엇을 성공으로 셀지는 앞서 적은 실행 계약에 맞춰야 하고요. Anthropic 에이전트 평가 가이드 (새 탭에서 열림)
다음 프롬프트를 고치기 전에
하네스 엔지니어링을 살펴보며 남는 질문은 “모델이 일을 끝냈다고 말할 때, 우리는 무엇을 확인했을까?”입니다.
처음부터 거대한 구조를 만들 필요는 없습니다. 반복할 작업 하나를 고르고, 받아도 되는 입력과 허용할 행동을 적어 볼 수 있습니다. 중간에 끊기면 어디부터 재개할지, 확인할 근거가 부족하면 어떤 상태로 남길지도요. 이 정도만 구체화해도 모델을 더 잘 활용하기 위해 필요한 부분과, 프로그램이 책임져야 할 부분을 나누기 쉬워집니다.
여러분의 에이전트가 마지막으로 “완료했습니다”라고 말한 작업을 떠올려 보세요. 그 말 대신 확인할 수 있는 결과와 기록이 남아 있나요?
참고 자료
자료 확인일은 2026년 10월 27일입니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
AI 에이전트의 분석을 현장의 업무로 연결하려면
AI가 이상을 찾아낸 뒤에도 현장에는 확인하고 결정할 일이 남습니다. OpenBot 1.0을 사례로, 에이전트의 분석이 사람의 판단과 후속 업무로 이어지려면 무엇이 필요한지 살펴봅니다.
AI 에이전트가 일하는 곳은 어디일까요?
AI 에이전트는 이제 답만 하지 않고 코드를 돌리고, 브라우저를 몰고, 사내 시스템에 접근합니다. 그 일은 어디서, 무엇을 쥐고 해야 할까요? 에이전트가 일하는 구조부터 짚고, 구글이 공개한 Agent Compute Engine의 설계를 살펴봅니다.