왜 에이전트에게 스키마 대신 온톨로지를 줘야 할까? 엔비디아 Auto Ontology로 본 답
온톨로지가 무엇인지부터, 엔비디아가 공개한 Auto Ontology까지
AI 에이전트에게 회사 데이터베이스를 연결하고 "지난달 매출이 얼마야?"라고 물으면, 에이전트는 SQL을 써서 실행하고 숫자 하나를 돌려줍니다. 문제는 그 숫자가 재무팀이 보고한 숫자와 다를 때입니다. SQL에는 문법 오류가 없었고 실행도 잘 됐습니다. 틀린 건 "매출"이라는 말의 뜻이었습니다.
엔비디아가 10월 GTC 베를린에서 공개한 오픈소스 Auto Ontology (새 탭에서 열림)는 바로 이 지점을 겨냥합니다. README 첫 문단에는 더 빨리 답한 매출 숫자도 틀리면 아무 가치가 없다는 문장이 있습니다. 엔비디아가 내놓은 답은 에이전트에게 스키마 대신 온톨로지를 주라는 것입니다.
그렇다면 온톨로지는 무엇이고, 스키마와는 무엇이 다를까요? 온톨로지부터 짚고 가겠습니다.
온톨로지는 무엇일까요?
온톨로지(ontology)는 원래 철학에서 무엇이 존재하는지를 묻는 존재론을 가리키는 말입니다. 컴퓨터 과학에서는 뜻이 조금 실용적으로 바뀌어, 어떤 분야에 어떤 개념이 있고 그 개념들이 서로 어떻게 이어지는지를 사람과 기계가 함께 읽을 수 있게 약속해 적어 둔 것을 말합니다.
회사로 옮겨 보면 온톨로지는 회사가 쓰는 말을 정리한 지도에 가깝습니다. 보통 세 가지를 담습니다.
- 개념: 고객, 주문, 송장, 제품처럼 업무에서 쓰는 말과 그 뜻입니다. "거래처"와 "바이어"가 같은 고객을 가리킨다는 것도 여기에 적습니다.
- 관계: 고객 한 명에게 송장이 여러 건 있고, 송장 한 건에 제품이 여러 줄 들어간다는 식으로 개념 사이를 잇는 길입니다.
- 규칙: 매출은 주문이 아니라 송장 기준으로 세고, "6월 매출"은 6월에 청구한 금액이라는 식의 계산 약속입니다.
여기에 각 개념이 실제 데이터의 어느 테이블과 컬럼에 있는지가 함께 붙습니다. 그래야 사람이 쓰는 말과 데이터베이스가 이어집니다.
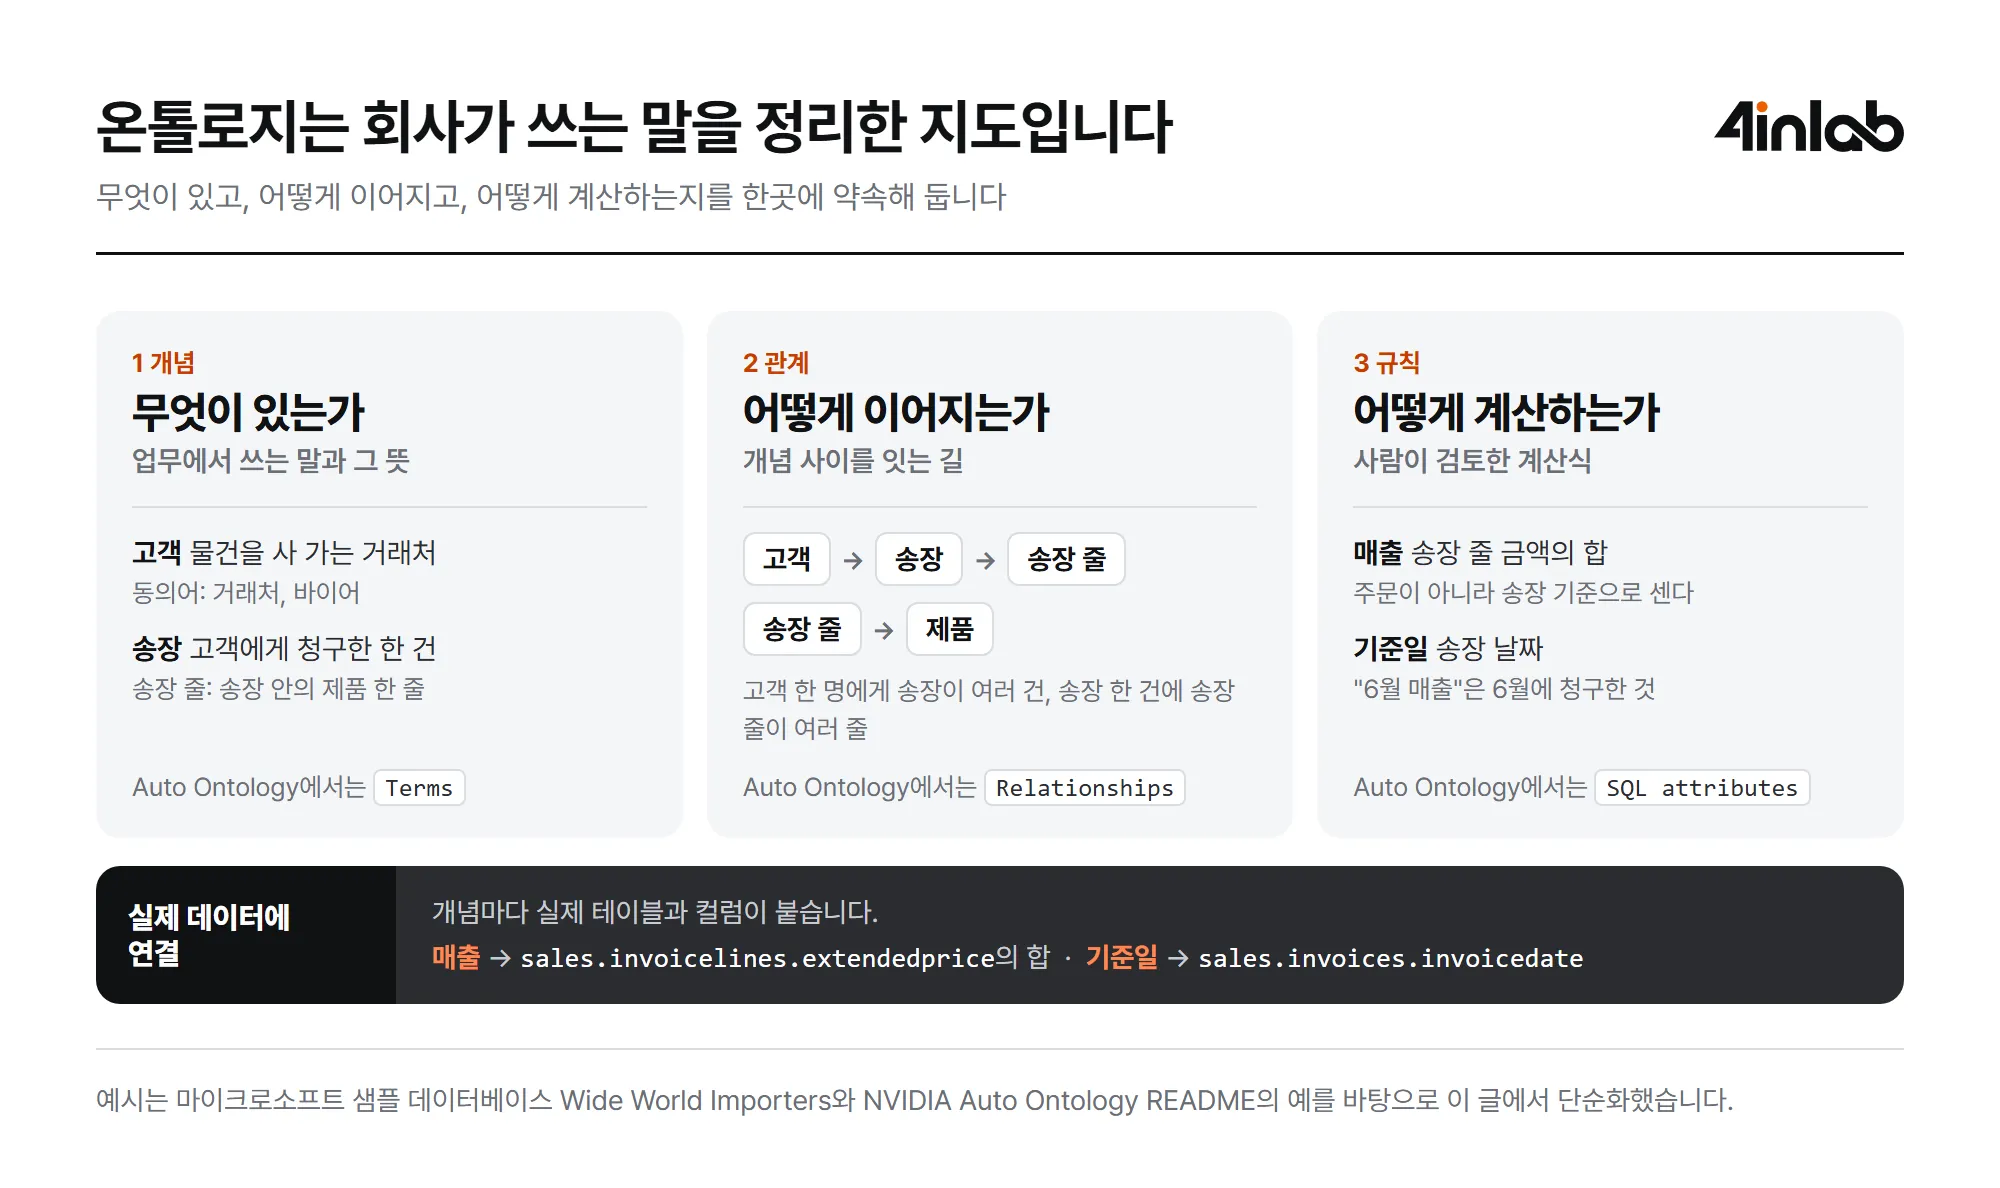
출처: NVIDIA Auto Ontology (새 탭에서 열림) README의 Wide World Importers 예시를 바탕으로 단순화해 그림
온톨로지라는 말은 팔란티어 덕분에 익숙해진 분도 많을 것입니다. 팔란티어는 회사 데이터를 객체와 그 사이의 연결로 묶고, 그 위에서 업무 동작까지 실행하게 하는 플랫폼의 중심에 온톨로지를 둡니다. 데이터 업계에서는 비슷한 층을 시맨틱 계층(semantic layer)이나 업무 용어집이라고 부르기도 합니다. 이름은 달라도 데이터에 업무의 뜻을 붙인다는 방향은 같습니다.
스키마와 온톨로지는 무엇이 다를까요?
스키마는 데이터가 어떻게 저장되어 있는지를 알려 줍니다. 어떤 테이블이 있고, 컬럼 이름과 자료형은 무엇이고, 어떤 키로 이어지는지입니다. 온톨로지는 그 데이터가 무엇을 뜻하는지를 알려 줍니다.
마이크로소프트의 샘플 데이터베이스 Wide World Importers로 보면 차이가 분명합니다. 송장 줄 테이블에는 단가(unitprice), 수량(quantity), 세액(taxamount), extendedprice 같은 컬럼이 있고, 주문 줄 테이블에도 비슷한 컬럼이 있습니다. 그런데 스키마 어디에도 "매출"이라는 이름은 없습니다.
스키마만 받은 에이전트는 이름을 보고 짐작해야 합니다. 매출이 단가 곱하기 수량인지 extendedprice인지, 주문 기준인지 송장 기준인지 정해야 하고, 질문에 나온 지역까지 가는 조인 경로도 스스로 찾아야 합니다. 어느 쪽을 골라도 SQL은 실행됩니다. 하지만 실행에 성공했다고 업무상 맞는 답이 되는 것은 아닙니다.
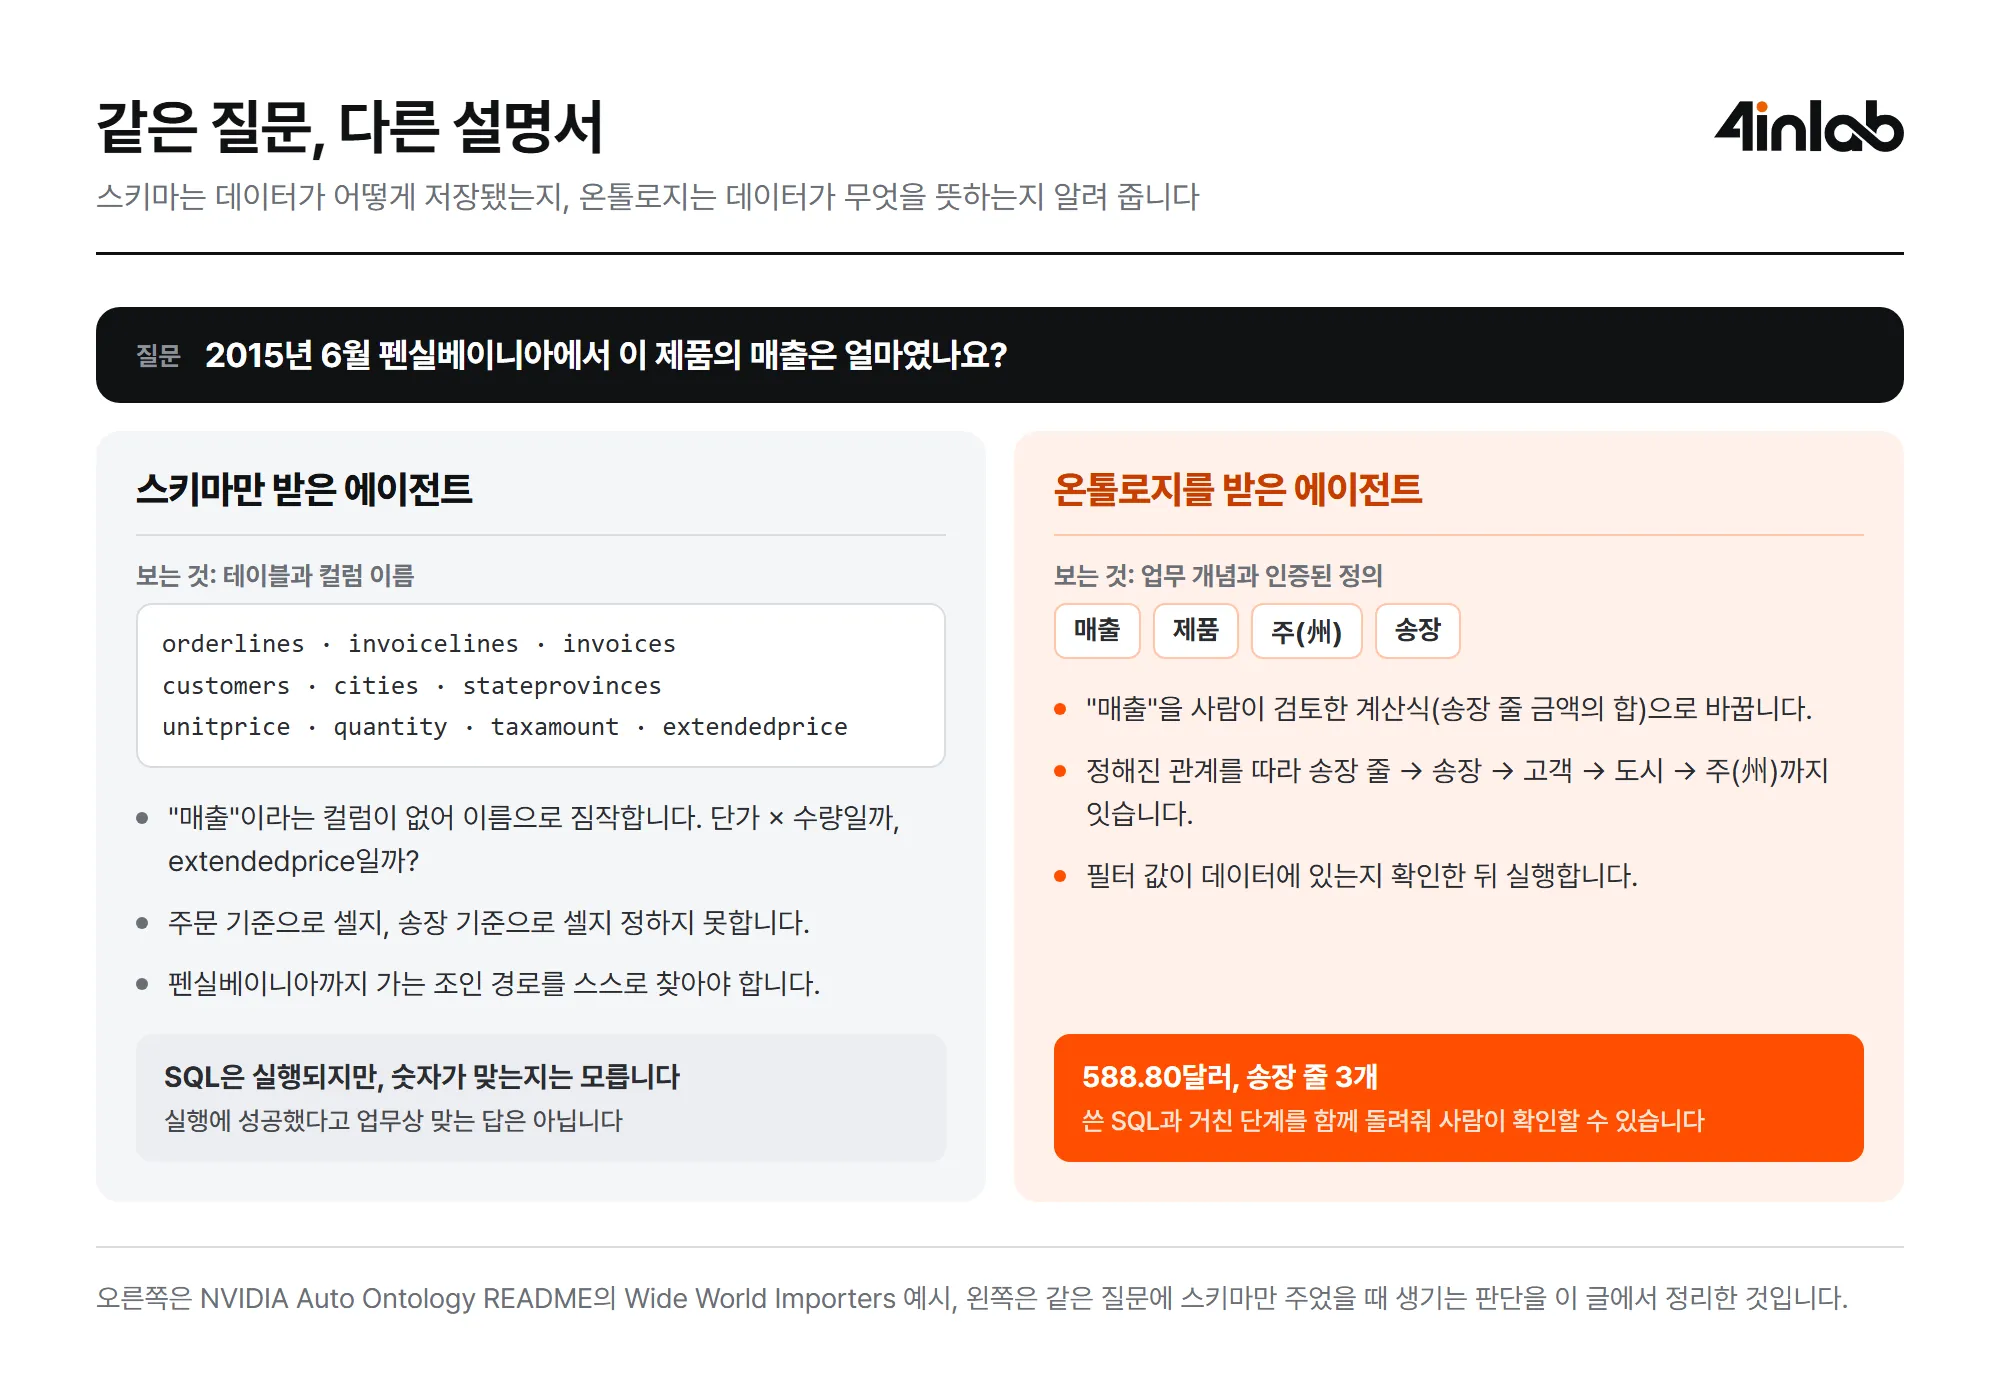
출처: NVIDIA Auto Ontology (새 탭에서 열림) README의 예시를 바탕으로 정리
실제 회사에서는 이 문제가 더 커집니다. 영업팀과 재무팀이 쓰는 매출의 정의가 다르기도 하고, 같은 고객이 시스템마다 다른 ID를 갖기도 합니다. 제조 현장도 다르지 않습니다. 같은 불량률이라도 분모를 투입 수량으로 잡는지 검사 수량으로 잡는지에 따라 숫자가 달라지고, 같은 설비가 시스템마다 다른 이름으로 불리기도 합니다. 테이블 이름만 보는 에이전트는 이런 약속을 알 길이 없습니다.
지난 컨텍스트 엔지니어링 글에서 AI에게 더 많이 보여 준다고 더 잘하는 것은 아니라고 했습니다. 스키마를 통째로 넘기는 것도 마찬가지입니다. 에이전트에게 필요한 것은 테이블 목록이 아니라 회사가 합의한 말의 뜻입니다.
엔비디아 Auto Ontology는 무엇을 할까요?
Auto Ontology는 엔비디아가 10월 21일 GTC 베를린에서 Agent Toolkit을 넓히며 발표한 Agent Knowledge Foundation (새 탭에서 열림)의 한 부분입니다. 회사 데이터베이스의 메타데이터를 읽어 온톨로지 초안을 자동으로 만들고, 사람이 그것을 확인하고 인증하게 한 뒤, 에이전트가 그 온톨로지를 거쳐 데이터에 질문하게 합니다. Apache-2.0 라이선스로 GitHub에 공개되어 있습니다.
Auto Ontology의 온톨로지에는 앞에서 본 세 가지가 그대로 들어갑니다. 개념은 용어(Terms), 관계는 관계(Relationships), 계산 규칙은 SQL 속성(SQL attributes)이라고 부릅니다. SQL 속성은 사람이 검토한 SQL 계산식이라서, 에이전트가 매번 새로 짐작하지 않고 같은 지표를 늘 같은 방식으로 계산하게 합니다.
README의 예시에서는 Wide World Importers를 한 번 컴파일해 용어 31개가 만들어졌습니다. 화면에서는 용어들이 서로 이어진 그래프로 보이고, 주문(Order)을 고르면 관련 용어 7개, 연결된 컬럼 10개, SQL 속성 2개가 함께 나옵니다.
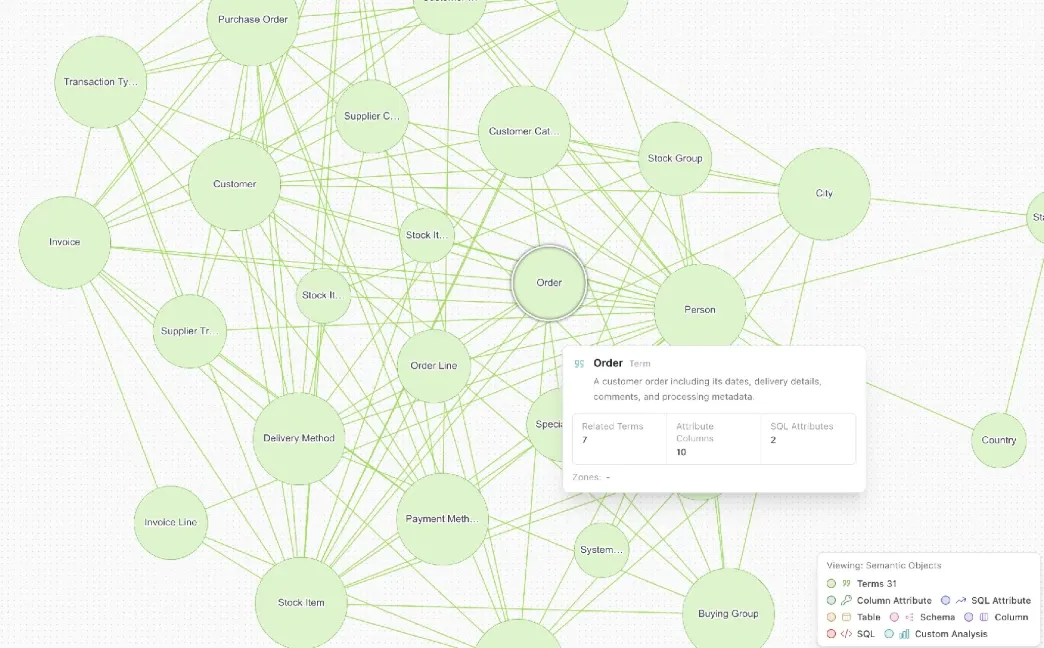
출처: NVIDIA Auto Ontology (새 탭에서 열림) README(Apache-2.0)
엔비디아는 Auto Ontology가 회사가 이미 가진 시맨틱 모델을 대체하는 것이 아니라 보완한다고 설명합니다. 시맨틱 모델을 주고받는 공개 형식인 Apache Ossie (새 탭에서 열림)로 정의를 가져오고 내보낼 수도 있습니다. PostgreSQL, MySQL, Snowflake, Databricks 등 데이터베이스 10종에 연결됩니다.
어떻게 만들고, 어떻게 답할까요?
Auto Ontology는 세 단계로 움직입니다.
- 생성: 스키마를 읽고 컬럼 값을 살펴본 뒤, 테이블마다 업무 개념을 뽑아 컬럼에 연결합니다. 테이블 사이의 조인을 추론하고, 과거 질의 기록에서 계산식을 제안합니다.
- 인증: 사람이 실제 질문을 던져 초안을 시험하고, 개념의 이름과 설명, 계산식을 다듬은 뒤 맞다고 확인한 정의를 인증합니다.
- 답변: 질문이 들어오면 에이전트가 관련 개념과 계산식을 찾아 SQL을 쓰고, 필터 값과 질의를 데이터베이스에 확인한 뒤 실행합니다. 답에는 쓴 SQL과 거친 단계가 함께 붙습니다.
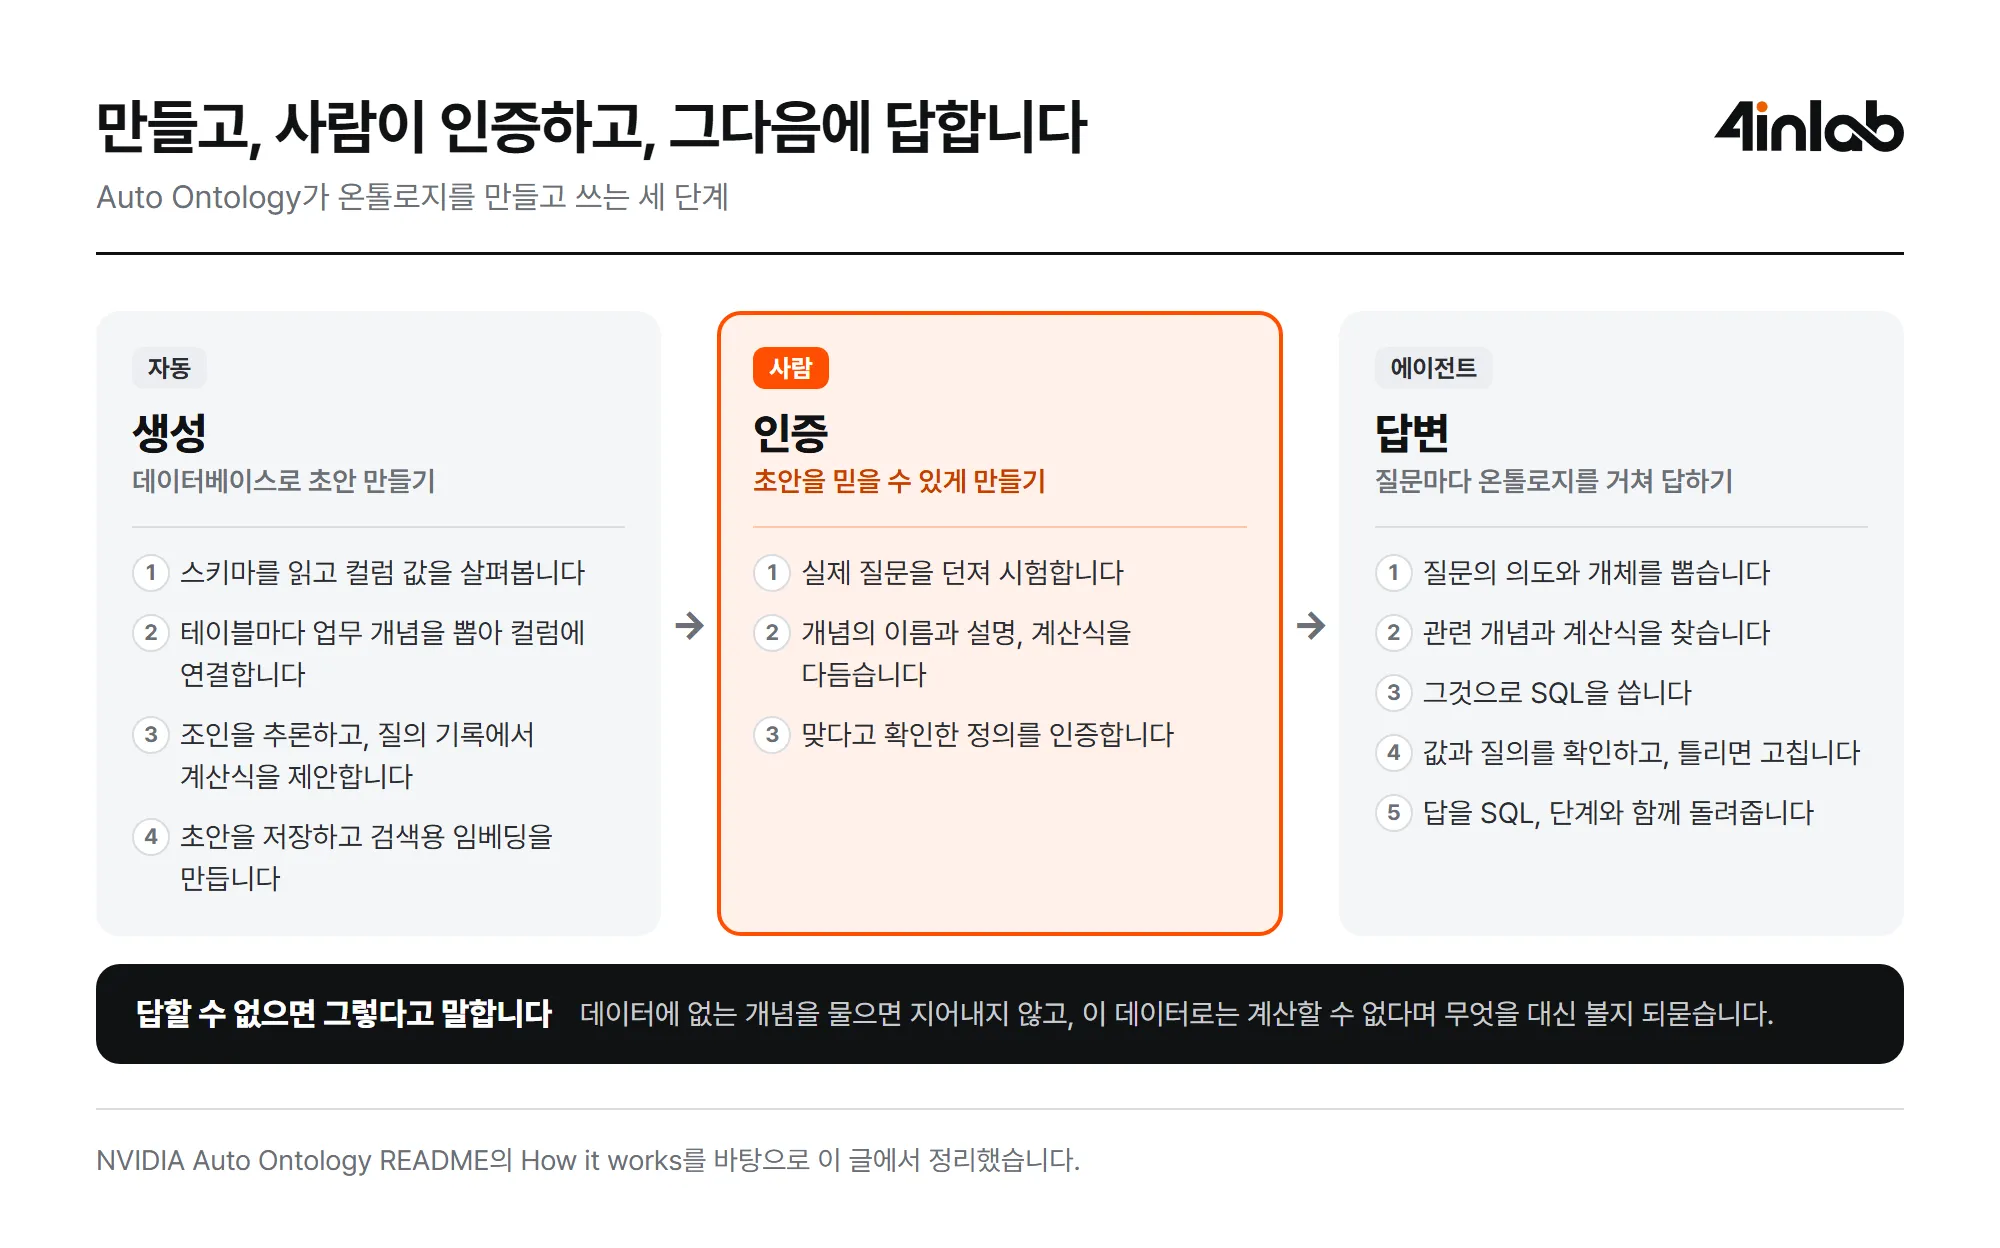
출처: NVIDIA Auto Ontology (새 탭에서 열림) README의 How it works를 바탕으로 정리
README의 예시 질문은 "2015년 6월 펜실베이니아에서 초밥 모양 USB 플래시 드라이브의 매출은 얼마였나요?"입니다. 에이전트는 매출, 제품, 주를 온톨로지의 용어로 바꾸고, 송장 줄에서 송장, 고객, 도시를 거쳐 주까지 이어지는 관계를 따라 SQL을 씁니다. 답은 송장 줄 3개, 588.80달러였습니다.
답할 수 없는 질문도 있습니다. 같은 제품의 광고비 대비 수익을 물으면, 이 데이터에는 광고비라는 개념이 없습니다. 에이전트는 숫자를 지어내지 않고, 광고비가 없어 계산할 수 없다며 매출을 대신 볼지, 광고비가 다른 곳에 있다면 그 데이터를 연결할지 되묻습니다.
왜 에이전트에게 테이블을 보여 주지 않을까요?
Auto Ontology는 MCP(Model Context Protocol)로 에이전트에게 도구 9개를 줍니다. 질문에 답하는 ask_question, 그 질문을 온톨로지가 다룰 수 있는지 미리 채점하는 check_answerable, 용어와 계산식을 찾아보는 도구들입니다. 모두 읽기 전용이라 온톨로지나 데이터베이스를 바꾸지 않습니다.
눈에 띄는 것은 빠진 도구입니다. MCP 문서 (새 탭에서 열림)에 따르면 데이터베이스나 스키마, 원시 컬럼을 둘러보는 도구는 일부러 넣지 않았습니다. 그런 도구가 있으면 에이전트가 온톨로지 대신 원시 테이블을 보고 추론하려 들기 때문입니다. 에이전트가 데이터에 닿는 길을 온톨로지 하나로 좁혀 둔 것입니다.
에이전트에게 필요한 것은 더 많은 테이블이 아니라, 사람이 합의하고 인증한 회사의 말입니다.
숫자는 어떻게 읽어야 할까요?
엔비디아는 자체 시험 (새 탭에서 열림)에서 온톨로지를 만드는 시간이 90% 줄었다고 밝혔습니다. 제품 소개 페이지에는 데이터 연결 시간 80% 감소, AI 질의 10배 정확 같은 숫자도 있습니다. 다만 시험 규모나 비교 기준은 공개하지 않았고, 90%는 정확도가 아니라 온톨로지를 만드는 시간에 대한 숫자입니다.
정확도 점수는 README에 없습니다. 대신 엔비디아는 평가 도구 (새 탭에서 열림)를 따로 냈습니다. 같은 모델에 같은 질문을 두 번 던지는데, 한 번은 질문과 스키마만 주고 한 번은 Auto Ontology를 거치게 합니다. 두 쪽이 쓴 SQL을 실제로 실행해 정답과 비교하고, 온톨로지 덕분에 맞힌 질문과 오히려 틀린 질문을 따로 보여 줍니다. BIRD 같은 공개 벤치마크뿐 아니라 자기 데이터로도 돌릴 수 있습니다. 우리 데이터에서 얼마나 나아지는지는 직접 재 봐야 한다는 뜻입니다.
한계도 분명합니다. 공식 문서와 DataFunTalk의 해설 (새 탭에서 열림)을 보면 다음과 같습니다.
- 정의를 정하는 건 여전히 사람입니다. 영업과 재무의 매출 정의가 다르면, 컬럼 이름이 비슷하다고 어느 쪽이 맞는지 정할 수는 없습니다. 업무 규칙이 바뀌면 정의도 다시 봐야 합니다.
- 자동으로 추론한 관계가 틀릴 수 있습니다. 시스템마다 고객 ID가 다르거나 송장 한 건이 주문 여러 건을 묶으면, 조인이 같은 금액을 두 번 셀 수 있습니다.
- 기본 설정은 운영용이 아닙니다. 연결 문서 (새 탭에서 열림)에 따르면 Vault를 켜지 않으면 데이터베이스 접속 비밀번호가 암호화 없이 저장됩니다. 내부 서비스 포트는 사설망에만 두라고 README에 적혀 있습니다.
- 조회도 실제 질의입니다. 도구가 읽기 전용이어도
ask_question은 데이터베이스에 질의를 실행합니다. 누가 어떤 데이터까지 볼 수 있는지, 기록을 어떻게 남길지는 회사가 정해야 합니다.
발표에 팔란티어, 데이터브릭스, 스노우플레이크 같은 파트너 이름이 함께 나오지만, 이들이 Auto Ontology를 실제로 쓰고 있다는 뜻은 아닙니다.
우리 일에는 무엇을 남길까요?
Auto Ontology가 보여 주는 순서는 이 도구를 쓰든 쓰지 않든 참고할 만합니다. 에이전트를 데이터에 붙이기 전에, 회사가 쓰는 말의 정의부터 합의해야 한다는 것입니다.
- 무엇을 정의할지: 자주 묻는 지표부터 고릅니다. 매출, 불량률, 가동률처럼 부서마다 다르게 쓰기 쉬운 말이 먼저입니다.
- 누가 인증할지: 데이터팀만이 아니라 그 숫자를 책임지는 업무 담당자가 정의를 확인해야 합니다.
- 언제 다시 볼지: 업무 규칙이나 시스템이 바뀌면 정의도 낡습니다. 인증한 정의도 버전을 남기고 다시 시험해야 합니다.
- 무엇에 답하지 않을지: 정의가 없는 질문에는 답하지 않고 되묻게 하는 편이 틀린 숫자를 내는 것보다 낫습니다.
RSI 글에서 AI가 일을 더 많이 맡을수록 사람은 방향과 검증과 권한을 붙잡아야 한다고 했습니다. 데이터 에이전트에서는 그 자리에 정의가 들어갑니다. SQL은 에이전트가 쓰더라도, 숫자의 뜻은 사람이 정해 줘야 합니다.
우리 산업 현장에도 AI를 적용할 수 있을까요?
어디서 시작할지 고민이라면, 포인랩과 산업 AI 전환의 첫걸음을 함께 찾아보세요.
이 글과 함께 읽으면 좋아요
더 많이 보여 줬는데, AI는 왜 더 헤맬까요?
같은 질문도 긴 대화 속에 넣으면 정답률이 0.92에서 0.38로 떨어집니다. 모델이 한 번에 보는 정보를 고르고 줄이고 나누는 컨텍스트 엔지니어링을 연구 결과와 포인랩의 적용 사례로 살펴봅니다.
보안 패치에서 공격 코드까지: 구글 보고서로 본 AI 자동화
구글 GTIG가 공격자의 시험용 서버에서, 보안 패치 전후 코드를 비교해 공격 코드를 쓰고 실행까지 하는 도구를 찾았습니다. 이 과정을 사람 없이 끝까지 돌린 사례는 처음입니다. 무엇이 새롭고 아직 무엇이 모자란지, 보고서와 숫자로 짚어 봅니다.
AI 에이전트의 분석을 현장의 업무로 연결하려면
AI가 이상을 찾아낸 뒤에도 현장에는 확인하고 결정할 일이 남습니다. OpenBot 1.0을 사례로, 에이전트의 분석이 사람의 판단과 후속 업무로 이어지려면 무엇이 필요한지 살펴봅니다.