제조 현장 데이터는 왜 그대로 쓸 수 없나
PLC, 센서, 비전. 프로토콜도 주기도 형식도 다른 데이터를 하나의 피처 스토어로 모으기까지 겪는 일들.
제조 AI의 첫 번째 벽은 모델이 아니라 데이터입니다. 정확히는 데이터가 없어서가 아니라, 있는 데이터를 그대로 쓸 수 없어서입니다.
이 말이 잘 와닿지 않는 이유는, 공장에 데이터가 정말로 많기 때문입니다. 설비는 밀리초 단위로 신호를 뱉고 있고, 센서는 계속 값을 올리고 있고, 카메라는 하루 종일 찍고 있습니다. 그런데 그것들을 한 화면에 올려놓고 학습을 시작하려 하면, 첫날부터 이상한 일이 벌어집니다.
세 종류의 데이터는 서로 다른 세계에 있다
- PLC 데이터. 설비 제어 신호입니다. 밀리초 단위로 바뀌고, 제조사마다 프로토콜이 다릅니다. 태그 이름은 설비를 설치한 사람이 붙인 것이라, 같은 의미의 신호가 라인마다 다른 이름을 갖습니다.
CYC_TM,cycle_time,T_CYCLE이 같은 값인지 아닌지는 문서가 아니라 사람의 기억에 있는 경우가 많습니다. - 센서 데이터. 진동, 온도, 전류. 주기는 일정하지만 노이즈가 많고, 기준선이 설비 상태에 따라 천천히 이동합니다. 어제의 정상 범위가 오늘의 정상 범위와 다릅니다.
- 비전 데이터. 이미지와 영상. 용량이 크고, 조명과 카메라 설정에 민감합니다. 다른 둘과 달리 이벤트가 있을 때만 남기는 경우가 많아, 시간축에 구멍이 많습니다.
세 데이터는 값의 형식만 다른 것이 아니라 시간을 세는 방식이 다릅니다. 그래서 "이 부품이 불량이던 순간의 설비 상태"를 알고 싶을 때, 그 순간이 어디인지부터 특정해야 합니다.
우리가 하는 순서
1. 시간 정렬
모든 소스를 하나의 시계로 맞춥니다. 이 작업이 사소해 보이지만, 실제로는 설비 시계가 어긋나 있는 경우가 생각보다 많습니다. 몇 초씩 차이 나는 정도는 흔하고, 시간대 설정이 다르거나 서머타임 처리가 제각각인 경우도 있습니다.
몇 초의 오차는 사람에게는 아무것도 아니지만, 사이클 타임이 몇 초인 공정에서는 다른 부품의 데이터를 가리킵니다. 라벨이 한 칸씩 밀린 데이터로 학습하면 모델은 아무것도 배우지 못하고, 원인을 찾기도 어렵습니다. 정확도가 낮게 나올 뿐 에러는 나지 않기 때문입니다.
2. 의미 통일
라인마다 다른 태그 이름을 하나의 사전으로 매핑합니다. 어떤 태그가 무엇을 뜻하는지, 단위는 무엇인지, 어떤 값이 정상 범위인지를 한곳에 적습니다.
이 사전을 만드는 일은 기술 작업이라기보다 현장 인터뷰에 가깝습니다. 설비를 오래 다룬 분에게 묻는 것이 문서를 읽는 것보다 빠릅니다. 그리고 이 사전이 이후 모든 작업의 기준이 됩니다. 사전이 없으면 라인이 늘어날 때마다 파이프라인을 새로 만들게 됩니다.
3. 품질 규칙
결측, 이상값, 정지 구간을 규칙으로 걸러냅니다. 셋 중 가장 자주 놓치는 것이 정지 구간입니다.
설비가 멈춰 있는 동안에도 신호는 계속 나옵니다. 값이 안정적이고 노이즈가 적어서, 데이터만 보면 오히려 가장 깨끗해 보입니다. 그 구간을 그대로 학습시키면 모델은 멈춰 있는 상태를 가장 정상적인 상태라고 배웁니다. 그리고 실제로 가동 중일 때 이상하다고 알립니다.
그래서 우리는 "무엇이 이상한가"보다 "무엇을 학습에서 뺄 것인가"를 먼저 정합니다. 정지, 워밍업, 금형 교체, 시험 가동. 이 구간들을 표시하는 규칙이 데이터 정리의 절반입니다.
4. 피처 스토어
정리된 데이터를 한곳에 두고, 학습과 추론이 같은 피처를 쓰게 합니다.
여기서 자주 생기는 문제가 학습과 추론의 불일치입니다. 학습할 때는 배치로 계산해서 지난 10분 평균을 쉽게 쓰지만, 추론할 때는 실시간이라 같은 값을 만들기 어렵습니다. 그래서 추론 쪽에서 슬쩍 다른 방식으로 계산하게 되고, 정확도는 재현되지 않습니다. 코드는 두 벌인데 아무도 두 벌인 줄 모르는 상태가 됩니다.
피처 스토어는 이 계산을 한 번만 정의해 두고 양쪽이 같은 것을 가져다 쓰게 하는 장치입니다. 화려한 기능은 아니지만, 있고 없고의 차이가 큽니다.
정리하면
데이터 정리는 한 번 하고 끝나는 일이 아닙니다. 설비가 바뀌고 센서가 추가될 때마다 사전과 규칙이 갱신되어야 합니다.
그래서 이 작업의 결과물은 잘 정리된 데이터셋이 아니라, 계속 돌아가는 시스템이어야 합니다. 데이터셋은 만든 순간부터 낡기 시작하지만, 파이프라인은 설비가 바뀌어도 따라갑니다.
다음 편에서는 이렇게 모은 데이터 위에서 안전 모니터링을 어떻게 설계했는지 이어갑니다.
이 글과 함께 읽으면 좋아요
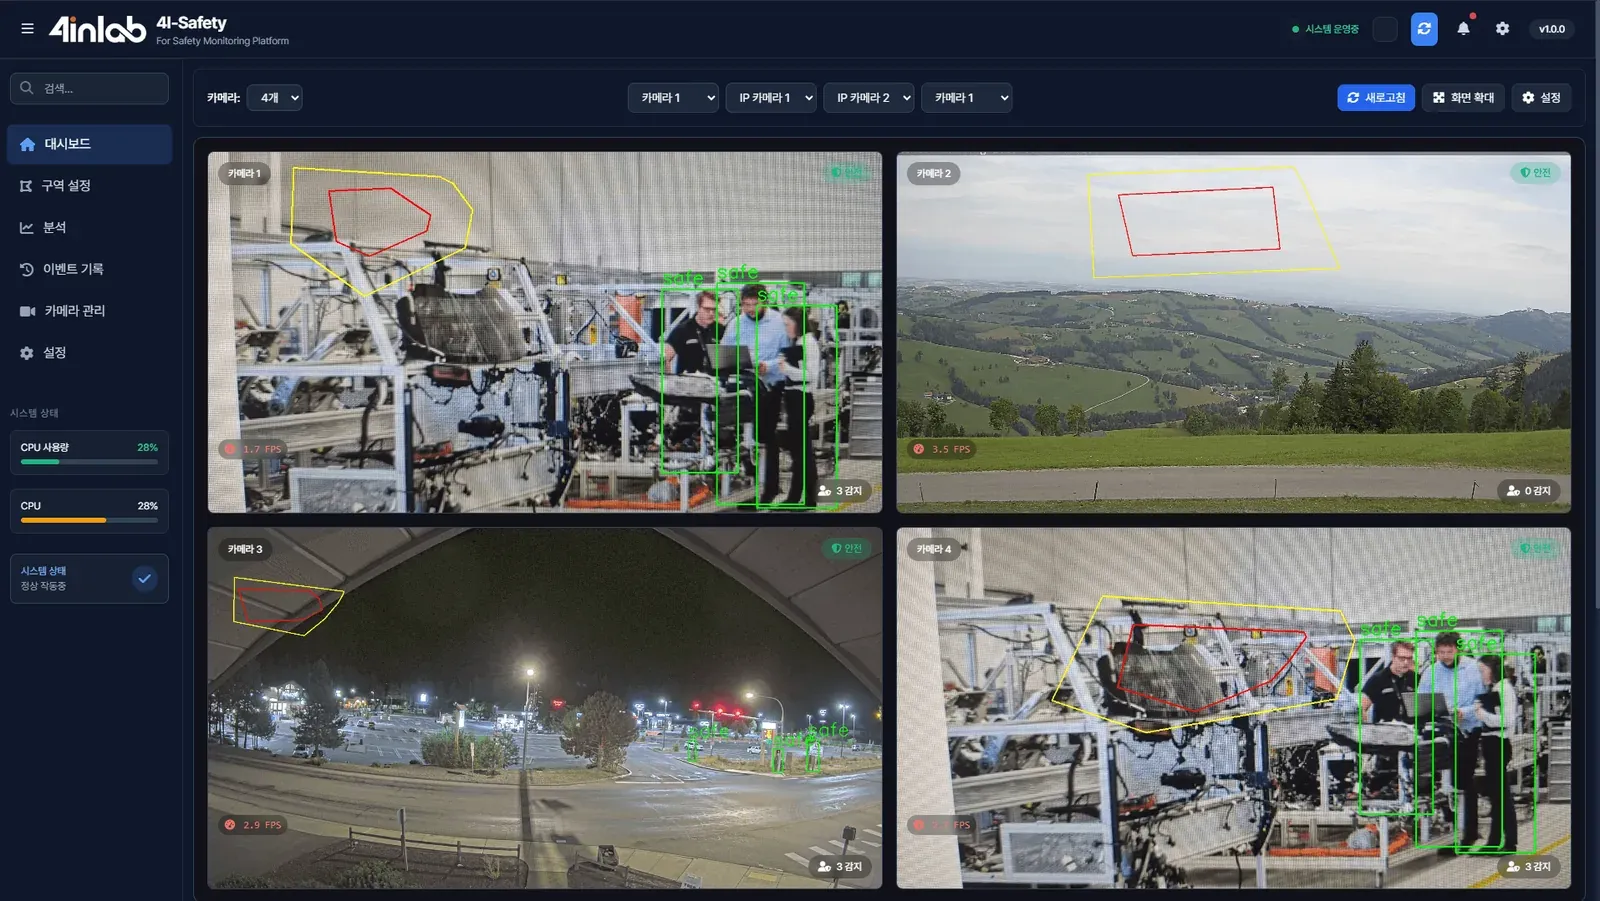
사고 전에 보는 안전 모니터링. 카메라 4대로 시작하는 방법
위험 구역을 어떻게 정의하고, 사람과 설비의 거리를 어떻게 재고, 언제 설비를 멈추는지. 4I-Safety 설계 기준.
협동로봇과 비전 AI로 품질 검사를 자동화하며 배운 것
검사 자동화 프로젝트에서 모델 정확도보다 먼저 결정해야 했던 것들. 조명, 지그, 판정 기준, 시간 예산, 그리고 검사원의 역할.